

Feliz sexta-feira a todos! Amigos, hoje continuamos a série de publicações dedicadas ao curso , pois as aulas da nova turma começam já no final da próxima semana. Então, vamos começar!
Monitoramento é simplesmente. É um fato conhecido. Levante o Nagios, inicie o NRPE em um sistema remoto, configure o Nagios na porta NRPE TCP 5666 e você tem monitoramento.
É tão fácil que não é interessante. Agora você tem as principais métricas sobre o tempo de CPU, subsistema de disco, memória RAM, que vêm por padrão no Nagios e NRPE. Mas, na verdade, isso não é 'monitoramento' como tal. É apenas o começo.
(Normalmente se instala o PNP4Nagios, RRDtool e Thruk, configura-se notificações no Slack e vai direto para nagiosexchange, mas vamos deixar isso de lado por enquanto).
Um bom monitoramento na verdade é bastante complexo, você realmente precisa conhecer os detalhes do aplicativo que está monitorando.
Monitoramento é complicado?
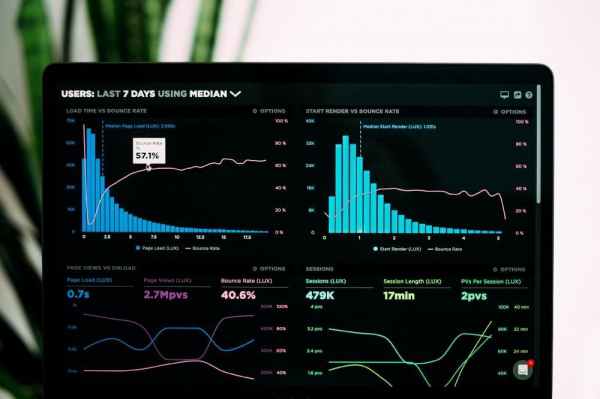
Qualquer servidor, seja Linux ou Windows, por definição servirá a algum propósito. Apache, Samba, Tomcat, armazenamento de arquivos, LDAP — todos esses serviços são mais ou menos únicos em um ou mais aspectos. Cada um tem sua função, suas particularidades. Há diferentes maneiras de obter métricas, KPIs (indicadores-chave de desempenho), que são interessantes para você quando o servidor estiver sob carga.
Autor da foto para
(Eu gostaria que meus painéis fossem coloridos em azul neon — suspirando sonhadoramente —… hmm…)
Qualquer software que fornece serviços deve ter um mecanismo para coletar métricas. O Apache tem o módulo mod-status, que exibe a página de estado do servidor. O Nginx tem stub_status. O Tomcat possui JMX ou aplicativos web específicos que mostram métricas-chave. No MySQL, há o comando 'show global status' e assim por diante.
Então por que os desenvolvedores não incorporam mecanismos assim nos aplicativos que criam?
Só os desenvolvedores fazem isso?
Um certo nível de indiferença em incorporar métricas não se limita apenas aos desenvolvedores. Eu trabalhei em empresas onde se desenvolveram aplicativos usando Tomcat e não se forneceram métricas, nem registros de atividade do serviço, além dos logs de erro gerais do Tomcat. Alguns desenvolvedores geram uma abundância de logs que não significam nada para o administrador do sistema que teve a infelicidade de lê-los às 3:15 da manhã.
Autor da foto para
Engenheiros de sistemas que permitem que esses produtos sejam lançados também devem assumir certa responsabilidade pela situação. Poucos engenheiros de sistemas têm tempo e se preocupam em tentar obter métricas significativas dos logs, sem o contexto dessas métricas e a capacidade de interpretá-las à luz da atividade do aplicativo. Alguns não entendem que benefícios podem obter com isso, além de indicadores do tipo "algo não está certo agora (ou logo estará)".
A mudança de mentalidade em relação à necessidade de métricas deve ocorrer não apenas entre os desenvolvedores, mas também entre os engenheiros de sistemas.
Para qualquer engenheiro de sistemas que precise não apenas reagir a eventos críticos, mas também garantir que eles não ocorram, a falta de métricas geralmente se torna um obstáculo.
No entanto, os engenheiros de sistemas normalmente não mergulham no código, ganhando dinheiro para sua empresa. Eles precisam de desenvolvedores líderes que entendam a importância da responsabilidade do engenheiro de sistemas na identificação de problemas, aumentando a conscientização sobre questões de desempenho e assim por diante.
Essa coisa de devops
A mentalidade devops descreve a sinergia entre o pensamento de desenvolvedores (dev) e operações (ops). Qualquer empresa que afirme que está "fazendo devops" deve:
- falar o que provavelmente não fazem (uma referência a um meme do filme "A Princesa Prometida" — "Eu não acho que isso significa o que você acha que significa!")
- promover uma postura de melhoria contínua do produto.
Você não pode melhorar um produto e saber que ele foi melhorado se não souber como ele funciona atualmente. Você não conseguirá entender como o produto funciona se não entender como seus componentes, serviços dos quais depende, principais pontos de dor e gargalos funcionam.
Se você não estiver monitorando os potenciais gargalos, não conseguirá aplicar a técnica dos "Cinco Porquês" ao escrever um Postmortem. Você não conseguirá reunir tudo em uma tela para ver como o produto funciona ou descobrir como ele parece "normal e feliz".
Deslocar para a esquerda, À ESQUERDA, EU DISSE, LEEEEEEEE—
Para mim, um dos princípios-chave do Devops é o "Deslocar para a esquerda" (shift left). O deslocamento para a esquerda neste contexto significa deslocar a possibilidade (não a responsabilidade, e apenas capacidades) para fazer o que normalmente preocupa os engenheiros de sistemas, como criar métricas de desempenho, utilizar logs de forma mais eficiente, etc., no início do ciclo de vida da entrega de software (Software Delivery Life Cycle).
Autor da foto para
Os desenvolvedores de software devem ser capazes de usar e conhecer as ferramentas de monitoramento que a empresa utiliza, para realizar monitoramento em todas as suas formas, métricas, registro de logs, interfaces de monitoramento e, mais importante, observar como seu produto funciona em produção. Você não pode forçar os desenvolvedores a investir tempo e esforço no monitoramento até que eles possam ver as métricas e influenciar como elas aparecem, como o proprietário do produto apresentará essas métricas ao CTO na próxima reunião, etc.
Em resumo
- Leve o cavalo até a água. Mostre aos desenvolvedores quantos problemas eles poderão evitar, ajude-os a identificar os KPIs e métricas corretas para suas aplicações, para que haja menos gritos do proprietário do produto, que é repreendido pelo diretor técnico (CTO). Revele isso de forma suave e calma. Se não funcionar, então suborne, ameace e persuada um deles ou o proprietário do produto para implementar essas métricas a partir das aplicações o mais rápido possível, e então crie gráficos. Isso será difícil, pois não será considerado uma prioridade, e haverá muitos projetos na linha de produtos aguardando implementação que geram receita. Portanto, você precisará de uma justificativa econômica para justificar o tempo e os recursos gastos na implementação do monitoramento no produto.
- Ajude os engenheiros de sistemas a dormir melhor. Mostre a eles que usar uma checklist de "lançamento" para qualquer produto que está sendo liberado é algo positivo. E checar se todos os aplicativos em produção estão cobertos com métricas ajudará a garantir um sono mais tranquilo à noite, permitindo que os desenvolvedores vejam o que está funcionando e o que não está. No entanto, a melhor maneira de irritar e frustrar qualquer desenvolvedor, proprietário de produto ou CTO é ficar colocando obstáculos e resistindo. Esse comportamento afetará a data de lançamento de qualquer produto, se esperar até o último minuto novamente, então mais uma vez faça um deslocamento para a esquerda e inclua essas questões no plano do projeto o mais rápido possível. Se necessário, infiltre-se nas reuniões dedicadas ao produto. Use um bigode falso e um chapéu ou algo do tipo, isso nunca falha. Comunique seus problemas, mostre as vantagens óbvias e evangelize.
- Assegure-se de que tanto os desenvolvedores (dev) quanto a operação (ops) compreendam o significado e as consequências de levar as métricas do produto para a "zona vermelha". Não deixe a operação como o único guardião da funcionalidade do produto, assegure-se de que os desenvolvedores também estejam envolvidos nisso (#productsquads).
- Logs são ótimos, mas métricas também. Combine-os e não deixe que seus logs se tornem lixo em uma enorme bola em chamas de inutilidade. Explique e mostre para os desenvolvedores por que ninguém além deles conseguirá entender seus logs, mostre a eles como é ver logs inúteis às 3:15 da manhã.
Autor da foto para
Isso é tudo. Novo material será lançado na próxima semana. Se você deseja saber mais sobre o curso, convidamos você para , que acontecerá já na segunda-feira. E agora, como de costume, esperamos seus comentários.
Fonte: habr.com
