

Olá a todos! Sou desenvolvedor backend e escrevo microsserviços em Java + Spring. Trabalho em uma das equipes de desenvolvimento de produtos internos da empresa Tinkoff.
Na nossa equipe, frequentemente surge a questão da otimização de consultas no SGBD. Sempre queremos um pouco mais de velocidade, mas nem sempre é possível contar apenas com índices bem estruturados — às vezes precisamos procurar soluções alternativas. Durante uma dessas buscas por otimizações razoáveis ao trabalhar com bancos de dados, encontrei , autor do livro SQL Performance Explained. Este é o tipo raro de blog onde podemos ler todos os artigos de uma vez.
Quero traduzir para vocês um pequeno artigo de Markus. Pode-se chamá-lo de uma espécie de manifesto, que busca chamar atenção para um problema antigo, mas ainda relevante, sobre o desempenho da operação offset segundo o padrão SQL.
Em alguns lugares, farei adições com explicações e comentários do autor. Todos esses pontos serão marcados como "prím." para maior clareza.
Uma breve introdução
Acho que muitos sabem quão problemático e lento pode ser trabalhar com seleções paginadas usando offset. Mas você sabia que é possível substituir isso por uma construção muito mais eficiente?
Assim, a palavra-chave offset indica ao banco para pular os primeiros n registros na consulta. No entanto, o banco ainda precisa ler esses primeiros n registros do disco, e na ordem especificada (prím.: aplicar ordenação, se especificada), e só depois disso será possível retornar os registros a partir de n+1 e além. O mais interessante é que o problema não está na implementação específica no SGBD, mas na definição original do padrão:
…as linhas são primeiro ordenadas de acordo com a <cláusula order by> e, em seguida, restringidas ao descartar o número de linhas especificado na <cláusula de offset do resultado> do início…
-SQL:2016, Parte 2, 4.15.3 Tabelas derivadas (prím.: atualmente o padrão mais utilizado)
O ponto chave aqui é que offset aceita um único parâmetro — o número de registros a serem pulados, e só isso. Seguindo essa definição, o SGBD só pode buscar todos os registros e, em seguida, descartar os desnecessários. É óbvio que tal definição de offset exige trabalho extra. E isso não importa se é SQL ou NoSQL.
Mais um pouco de dor
Os problemas de offset não param por aqui, e aqui está o motivo. Se uma nova operação inserir um registro entre a leitura de duas páginas de dados do disco, o que acontecerá nesse caso?
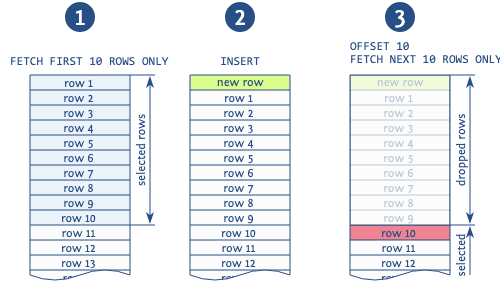
Quando se utiliza offset para pular registros de páginas anteriores, na situação em que uma nova gravação é feita entre operações de leitura de páginas diferentes, é muito provável que você acabe recebendo duplicatas (nota: isso pode ocorrer quando lemos página por página utilizando a construção order by, com uma nova gravação podendo ser inserida no meio dos nossos resultados).
A ilustração demonstra claramente essa situação. O banco de dados lê os primeiros 10 registros, então uma nova entrada é inserida, deslocando todos os registros lidos em 1. Depois, o banco de dados pega a nova página contendo os próximos 10 registros e começa não a partir do 11º, como deveria, mas a partir do 10º, duplicando esse registro. Existem outras anomalias relacionadas ao uso dessa expressão, mas essa é a mais comum.
Como já discutido, isso não é um problema específico de um determinado SGBD ou suas implementações. O problema reside na definição de paginação segundo o padrão SQL. Estamos informando ao SGBD qual página deve ser recuperada ou quantos registros ignorar. O banco de dados simplesmente não consegue otimizar tal consulta, pois falta informação suficiente.
Vale também destacar que esse problema não é de uma palavra-chave específica, mas sim da semântica da consulta. Existem várias outras sintaxes idênticas que apresentam problemas:
- A palavra-chave offset, como mencionado anteriormente.
- A construção de duas palavras-chave limit [offset] (embora limit em si não seja tão ruim).
- Filtragem por limites inferiores, baseada em numeração de linhas (por exemplo, row_number(), rownum, etc.).
Todas essas expressões simplesmente indicam quantas linhas devem ser puladas, sem fornecer nenhuma informação ou contexto adicional.
A partir deste ponto, a palavra-chave offset será utilizada como um termo genérico para todas essas variantes.
A vida sem OFFSET
E agora, vamos imaginar como seria nosso mundo sem todos esses problemas. Aparentemente, viver sem offset não é tão complicado assim: podemos selecionar apenas as linhas que ainda não vimos (nota: ou seja, aquelas que não estavam na página anterior), utilizando uma condição no where.
Neste caso, partimos do fato de que os selects são executados sobre um conjunto ordenado (o bom e velho order by). Como temos um conjunto ordenado, podemos usar um filtro bastante simples para obter apenas os dados que estão além do último registro da página anterior:
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
E esse é todo o princípio dessa abordagem. Claro, ao classificar por várias colunas, tudo fica mais interessante, mas a ideia permanece a mesma. É importante notar que essa construção é aplicável em muitos -soluções.
Essa abordagem é chamada de seek method ou paginação por chave. Ela resolve o problema com o resultado flutuante (Nota: a situação com o registro entre leituras de páginas, descrita anteriormente) e, claro, o que todos nós amamos, é mais rápida e estável do que o offset clássico. A estabilidade está no fato de que o tempo de processamento da consulta não aumenta proporcionalmente ao número da tabela solicitada (Nota: se você quiser saber mais sobre o funcionamento de diferentes abordagens de paginação, pode . Lá você também pode encontrar benchmarks comparativos sobre diferentes métodos).
Um dos slides , a paginação por chaves, claro, não é onipotente — ela tem suas limitações. A mais significativa é que não há possibilidade de ler páginas aleatórias (Nota: de forma não sequencial). No entanto, na era do scroll infinito (Nota: no front-end), isso não é um grande problema. Indicar o número da página para clicar — de qualquer forma, é uma má solução ao desenvolver a interface do usuário (Nota: opinião do autor do artigo).
E quanto às ferramentas?
A paginação por chaves muitas vezes não é adequada devido à falta de suporte instrumental a esse método. A maioria das ferramentas de desenvolvimento, incluindo diferentes frameworks, não dá a opção de qual método exatamente será utilizado para a paginação.
A situação é agravada pelo fato de que o método descrito exige suporte contínuo nas tecnologias utilizadas — desde o SGBD até a execução de chamadas AJAX no navegador durante o scroll infinito. Em vez de indicar apenas o número da página, agora será necessário especificar um conjunto de chaves para todas as páginas de uma só vez.
No entanto, o número de frameworks que suportam paginação por chave está gradualmente aumentando. Aqui está o que temos até agora:
- para Java;
- para Ruby;
- e para Django;
- para Python;
- — API de critérios para implementações JPA;
- para Perl;
- , мапер для Node.js .
(Nota: alguns links foram removidos porque, no momento da tradução, algumas bibliotecas não eram atualizadas desde 2017-2018. Se estiver interessado, pode conferir a fonte original.)
É exatamente nesse ponto que preciso da sua ajuda. Se você está desenvolvendo ou mantém um framework que, de alguma forma, utiliza paginação, peço, imploro que você implemente suporte nativo para paginação por chave. Se tiver dúvidas ou precisar de ajuda, fico feliz em ajudar (, , ) (nota: pela minha experiência em conversar com Markus, posso dizer que ele realmente aborda essa questão com entusiasmo).
Se você utiliza soluções prontas que, na sua opinião, merecem ter suporte para paginação por chave, crie um request ou até mesmo proponha uma solução pronta, se possível. Você também pode incluir este artigo no link.
Conclusão
A razão pela qual uma abordagem tão simples e útil, como a paginação por chave, é pouco difundida não é que seja difícil de implementar tecnicamente ou exija grandes esforços. A principal razão é que muitos estão acostumados a ver e trabalhar com offset — essa abordagem é ditada pelo próprio padrão.
Como consequência, poucos pensam em mudar a abordagem de paginação, e devido a isso, o suporte instrumental por parte dos frameworks e bibliotecas se desenvolve lentamente. Portanto, se você se importa com a ideia e o objetivo da paginação sem offset, — ajude a disseminá-la!
Fonte:
Autor: Markus Winand
Fonte: habr.com
