

Por favor, não se precipite em tirar conclusões por causa do título! Temos argumentos sólidos para sustentá-lo e os organizamos de forma compacta o máximo que pudemos. Apresentamos a vocês um post sobre o conceito e os princípios de funcionamento de nosso novo sistema de armazenamento de dados, cujo lançamento ocorreu em janeiro de 2020.
Acreditamos que a principal vantagem competitiva da linha de sistemas de armazenamento Dorado V6 é precisamente o desempenho e a confiabilidade mencionados no título. Sim, é tão simples assim, mas sobre quais soluções engenhosas e nem tão engenhosas conseguimos alcançar esse 'simples', é o que vamos discutir hoje.
Para melhor explorar o potencial dos sistemas de nova geração, falaremos sobre os representantes mais avançados da linha de modelos (modelos 8000, 18000). A menos que indicado de outra forma, estamos nos referindo a eles.
Uma palavra sobre o mercado
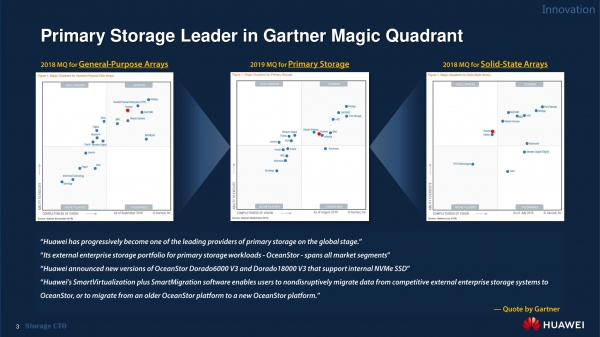
Para entender melhor a posição das soluções da Huawei no mercado, vamos nos referir a uma métrica comprovada — "" da Gartner. Dois anos atrás, no setor de matrizes de disco de uso geral, nossa empresa estava firmemente entre os líderes, atrás apenas da NetApp e da Hewlett Packard Enterprise. A posição da Huawei no mercado de sistemas de armazenamento SSD em 2018 foi caracterizada pelo status de 'desafiante', mas algo estava faltando para alcançar posições de liderança.
Em 2019, a Gartner em sua pesquisa unificou os dois setores mencionados acima em um — 'Armazenamento Principal'. Como resultado, a Huawei novamente se destacou no quadrante dos líderes, ao lado de fornecedores como IBM, Hitachi Vantara e Infinidat.
Para a completude do quadro, vale ressaltar que 80% dos dados para análise da Gartner são coletados no mercado americano, o que leva a um viés significativo em favor das empresas que estão bem representadas nos EUA. Enquanto isso, fornecedores voltados para os mercados europeu e asiático encontram-se em desvantagem. E mesmo assim, no ano passado, os produtos da Huawei ocuparam um lugar digno no quadrante superior direito e, segundo o veredito da Gartner, "podem ser recomendados para uso".
O que há de novo no Dorado V6
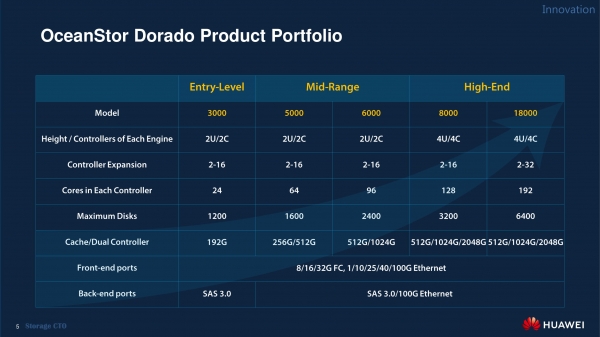
A linha de produtos Dorado V6, em particular, é composta por sistemas de nível de entrada da série 3000. Originalmente equipados com dois controladores, podem ser expandidos horizontalmente até 16 controladores, 1200 discos e 192 GB de cache. O sistema também será equipado com portas externas Fibre Channel (8 / 16 / 32 Gbps) e Ethernet (1 / 10 / 25 / 40 / 100 Gbps).
Observamos que, no momento, está sendo reduzido o uso de protocolos que não tiveram sucesso comercial, portanto, decidimos no início não oferecer suporte ao Fibre Channel over Ethernet (FCoE) e Infiniband (IB). Eles serão adicionados em versões futuras do firmware. O suporte ao NVMe over Fabric (NVMe-oF) está disponível "pronto para uso" sobre Fibre Channel. Na próxima versão do firmware, programada para junho, o suporte ao modo NVMe over Ethernet está previsto. Em nossa opinião, o conjunto mencionado acima cobrirá amplamente as necessidades da maioria dos clientes da Huawei.
O acesso a arquivos na versão atual do firmware está ausente e aparecerá em uma das próximas atualizações mais perto do final do ano. A implementação é prevista em nível nativo, pelos próprios controladores com portas Ethernet, sem a utilização de equipamentos adicionais.
A principal diferença do modelo Dorado V6 da série 3000 em relação aos mais antigos é que no backend ele suporta um único protocolo — SAS 3.0. Portanto, os dispositivos de armazenamento podem ser utilizados apenas com essa interface. Na nossa opinião, o desempenho fornecido é mais do que adequado para um dispositivo desse tipo.
Os sistemas Dorado das séries V6 5000 e 6000 pertencem a soluções de classe média. Eles também são projetados no formato 2U e equipados com dois controladores. Eles se diferenciam entre si em termos de desempenho, número de processadores, número máximo de discos e volume de cache. Ao mesmo tempo, em termos arquitetônicos e de engenharia, os Dorado V6 5000 e 6000 são idênticos e têm a mesma aparência.
As soluções hi-end referem-se aos sistemas Dorado V6 das séries 8000 e 18000. Com um tamanho de 4U, eles possuem uma arquitetura separada por padrão, onde os controladores e os discos estão fisicamente separados. Na configuração mínima, eles também podem ser fornecidos com apenas dois controladores, embora os clientes geralmente solicitem a instalação de quatro ou mais.
O Dorado V6 8000 escala horizontalmente até 16 controladores, enquanto o Dorado V6 18000 vai até 32. Esses sistemas possuem diferentes processadores com variados números de núcleos e tamanhos de cache. A identidade das soluções de engenharia, no entanto, se mantém, assim como nos modelos de classe mid-end.
Os compartimentos 2U com unidades de armazenamento se conectam via RDMA com uma largura de banda de 100 Gb/s. O backend do Dorado V6 das séries superiores também suporta SAS 3.0, mas mais como uma precaução para o caso de os SSDs com essa interface terem queda drástica de preço. Isso tornaria economicamente viável o uso deles, mesmo considerando seu desempenho inferior. No momento, a diferença de custo entre SSDs com interfaces SAS e NVMe é tão pequena que não estamos prontos para recomendar tal solução.
Dentro do controlador
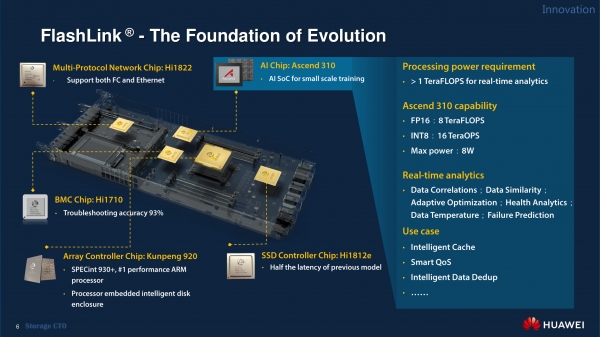
Os controladores Dorado V6 são feitos com nossa própria base de componentes. Nenhum processador da Intel, nenhum ASIC da Broadcom. Assim, todos os componentes da placa-mãe, assim como ela mesma, estão totalmente isentos de riscos associados à pressão sancionatória das empresas americanas. Aqueles que viram qualquer um de nossos equipamentos com seus próprios olhos, certamente notaram os escudos com uma faixa vermelha sob o logotipo. Isso indica que o produto não contém componentes americanos. Esse é o curso oficial da Huawei — a transição para componentes de fabricação própria ou, pelo menos, fabricados em países que não seguem a política dos EUA.
Isso é o que pode ser visto na própria placa do controlador.
- Interface de rede universal (chip Hisilicon 1822), responsável pela conexão a Fibre Channel ou Ethernet.
- Chip BMC que garante a acessibilidade remota do sistema, especificamente o Hisilicon 1710, para controle e monitoramento remoto completo do sistema. Chips semelhantes são utilizados também em nossos servidores e em outras soluções.
- O processador central, que é um chip Kunpeng 920 da Huawei baseado na arquitetura ARM. É o que é mostrado no esquema acima, embora em outros controladores possam ser instalados modelos diferentes com variados números de núcleos, diferentes frequências de clock, etc. A quantidade de processadores em um controlador pode variar de modelo para modelo. Por exemplo, nas séries superiores do Dorado V6, há quatro em uma única placa.
- Controlador SSD (chip Hisilicon 1812e), que suporta conexão tanto com drives SAS quanto com NVMe. Ademais, a Huawei fabrica seus próprios SSDs, mas não produz as células NAND, preferindo comprá-las de quatro dos maiores fabricantes globais em forma de wafers de silício não cortados. O corte, teste e embalagem em chips são realizados pela Huawei, que os lança sob sua própria marca.
- O chip de inteligência artificial é o Ascend 310. Por padrão, não está presente no controlador e é montado através de um cartão separado, ocupando um dos slots dedicados para adaptadores de rede. O chip é usado para garantir o comportamento inteligente do cache, gerenciamento de desempenho ou processos de deduplicação e compressão. Todas essas tarefas podem ser realizadas pela unidade central de processamento, mas o chip de IA permite fazê-lo de forma muito mais eficiente.
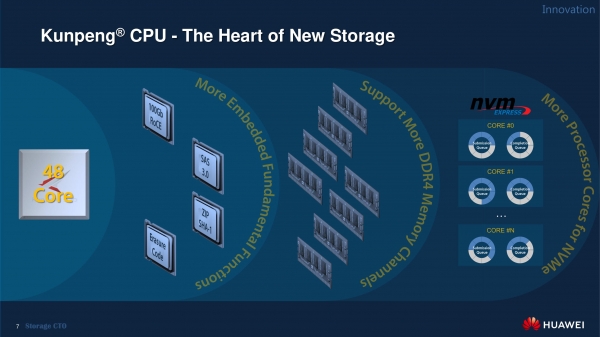
Sobre os processadores Kunpeng
O processador Kunpeng é um sistema em um chip (SoC), que além do bloco de computação, possui módulos de hardware que aceleram vários processos, como o cálculo de somas de verificação ou a execução de 'código de apagamento' (erasure coding). Também possui suporte de hardware para SAS, Ethernet, DDR4 (de seis a oito canais), entre outros. Tudo isso permite que a Huawei crie controladores de armazenamento que não ficam atrás das soluções clássicas da Intel em termos de desempenho.
Além disso, as soluções próprias baseadas na arquitetura ARM permitem à Huawei criar soluções de servidor completas e oferecê-las aos seus clientes como uma alternativa ao x86.
A nova arquitetura Dorado V6...
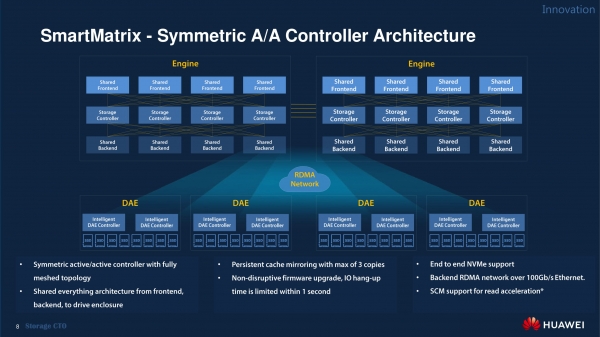
A arquitetura interna dos sistemas de armazenamento Dorado V6 da série mais alta é apresentada por quatro subdomínios principais (fábricas).
A primeira fábrica é uma interface frontal comum (interfaces de rede responsáveis pela comunicação com a fábrica SAN ou hosts).
A segunda é um conjunto de controladores, cada um dos quais pode acessar, por meio do protocolo RDMA, tanto qualquer cartão de rede da interface frontal quanto o 'motor' (engine) vizinho, que consiste em uma caixa com quatro controladores, além de fontes de alimentação e refrigeração compartilhadas. Atualmente, modelos Dorado V6 da categoria hi-end podem ser equipados com dois desses 'motores' (totalizando oito controladores).
A terceira fábrica é responsável pelo backend e consiste em placas de rede RDMA de 100G.
Finalmente, a quarta fábrica "em hardware" é representada por estantes inteligentes conectáveis com unidades de armazenamento.
Essa estrutura simétrica revela todo o potencial da tecnologia NVMe, garantindo alto desempenho e confiabilidade. O processo de entrada e saída é maximamente paralelizado entre processadores e núcleos, permitindo leitura e escrita simultâneas em múltiplos fluxos.
… e o que ela nos trouxe
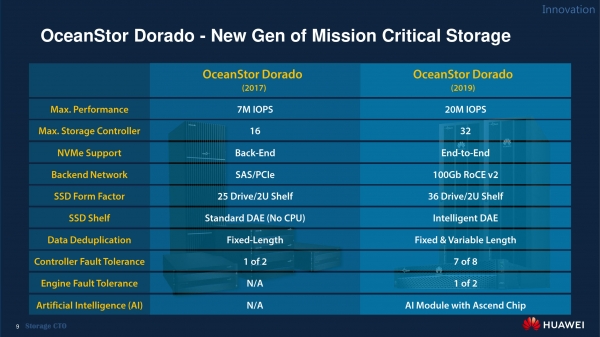
O desempenho máximo das soluções Dorado V6 é aproximadamente três vezes superior ao das sistemas de gerações anteriores (da mesma classe) e pode atingir 20 milhões de IOPS.
Isso se deve ao fato de que na geração anterior de dispositivos, o suporte a NVMe se restringia apenas a estantes de unidades de armazenamento. Agora, ele está presente em todas as etapas, do host até o SSD. A rede de backend também passou por alterações: SAS/PCIe cederam lugar ao RoCEv2 com largura de banda de 100 Gbps.
O próprio fator de forma do SSD também mudou. Antes, uma estante de 2U tinha 25 unidades de armazenamento, mas agora foi aumentada para 36 discos de formato físico palm-sized. Além disso, as estantes se tornaram "inteligentes". Cada uma delas agora possui um sistema de tolerância a falhas com dois controladores baseados em chips ARM, semelhantes aos que estão instalados nos controladores centrais.
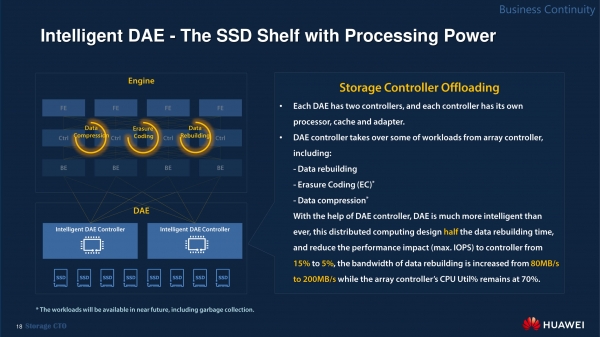
Atualmente, eles estão apenas reorganizando os dados, mas com o lançamento de novos firmwares, serão adicionadas compressão e erasure coding, o que permitirá reduzir a carga sobre os controladores principais de 15% para 5%. Transferir parte das tarefas para a estante também libera largura de banda na rede interna. E tudo isso aumenta significativamente o potencial de escalabilidade do sistema.
A compressão e deduplicação na SDD anterior eram realizadas com blocos de comprimento fixo. Agora, foi adicionado um modo de operação com blocos de comprimento variável, que ainda precisa ser ativado manualmente. Futuros firmwares podem alterar essa situação.
Também uma breve palavra sobre a tolerância a falhas. O Dorado V3 mantinha a operabilidade caso um controlador de dois falhasse. O Dorado V6 garantirá a disponibilidade de dados mesmo se sete controladores de oito falharem sequencialmente ou quatro de um único "motor" falharem ao mesmo tempo.
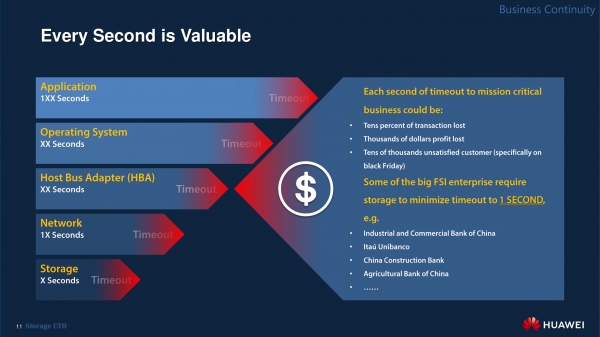
Confiabilidade do ponto de vista econômico.
Recentemente, foi realizado uma pesquisa entre os clientes da Huawei sobre quais elementos simples da infraestrutura de TI são considerados aceitáveis pela empresa. Na maioria, os entrevistados aceitaram bem a situação hipotética em que um aplicativo não responde por vários segundos. Para o sistema operacional ou adaptador de host do barramento, o tempo crítico de inatividade foi considerado em dezenas de segundos (essencialmente, o tempo de reinicialização). Os clientes têm requisitos ainda mais exigentes para a rede: sua largura de banda não deve ser interrompida por mais de 10 a 20 segundos. Como não é difícil adivinhar, os entrevistados consideraram as falhas dos sistemas de armazenamento as mais críticas. Do ponto de vista dos representantes de negócios, o tempo de inatividade do armazenamento deve ser limitado a... alguns segundos por ano!
Em outras palavras, se o aplicativo do cliente do banco não responde por 100 segundos, isso provavelmente não causará consequências catastróficas. No entanto, se o mesmo acontecer com o sistema de armazenamento, é provável que ocorra a interrupção do negócio e perdas financeiras significativas.
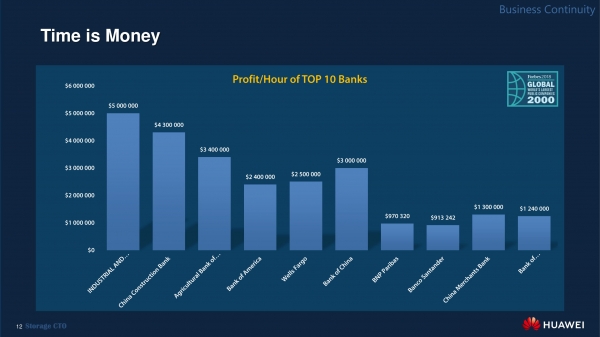
No gráfico acima, o custo de uma hora de operação dos dez maiores bancos é apresentado (dados da Forbes de 2017). Convenhamos, se sua empresa se aproxima do tamanho dos bancos chineses, será relativamente fácil justificar a necessidade de adquirir um sistema de armazenamento por alguns milhões de dólares. O mesmo se aplica ao oposto: se o negócio não enfrentar perdas significativas durante o tempo de inatividade, é improvável que compre um sistema de armazenamento de classe hi-end. De qualquer forma, é importante ter uma ideia do tamanho da lacuna que pode se formar em seu bolso enquanto o administrador de sistema resolve o sistema de armazenamento que falhou.
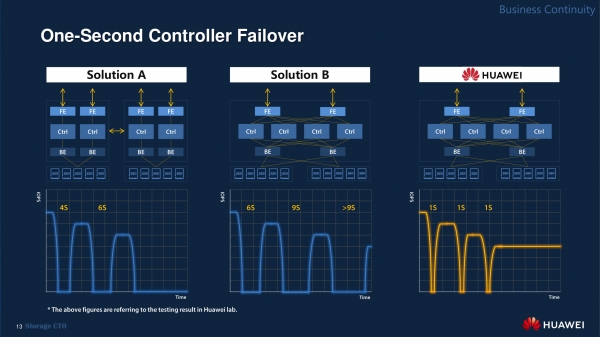
Um segundo para a troca de emergência
Na Solução A, na ilustração acima, você pode ver nosso sistema de geração anterior Dorado V3. Quatro de seus controladores operam em pares, e cópias do cache são mantidas em apenas dois controladores. Os controladores dentro do par podem redistribuir a carga. Ao mesmo tempo, como você pode ver, não há 'fábricas' de frontend e backend aqui, então cada uma das prateleiras com unidades é conectada a um par de controladores específico.
No diagrama da Solução B é mostrado a solução atualmente disponível no mercado de outro fornecedor (reconheceu?). Aqui já existem fábricas de front-end e back-end, e os armazenamentos são conectados diretamente a quatro controladores. No entanto, existem nuances não óbvias no funcionamento dos algoritmos internos do sistema.
À direita está nossa atual arquitetura de armazenamento Dorado V6 com todo o conjunto de elementos internos. Vamos analisar como esses sistemas lidam com uma situação típica — a falha de um controlador.
Em sistemas clássicos, dos quais o Dorado V3 faz parte, o tempo necessário para redistribuir a carga em caso de falha chega a quatro segundos. Durante esse tempo, as operações de entrada e saída são completamente interrompidas. Na solução Solução B dos nossos colegas, apesar de uma arquitetura mais moderna, o tempo de inatividade em caso de falha é até maior — seis segundos.
O armazenamento Dorado V6 restabelece seu funcionamento apenas um segundo após a falha. Esse resultado é alcançado graças a um ambiente interno homogêneo de RDMA, permitindo que o controlador acesse a memória 'estranha'. Outro aspecto importante é a presença da fábrica de front-end, que garante que o caminho para o host não muda. A porta permanece a mesma, e a carga é simplesmente enviada para os controladores funcionais pelos drivers de multipassing.
A falha do segundo controlador no Dorado V6 é gerida em um segundo de acordo com o mesmo esquema. No Dorado V3, isso leva cerca de seis segundos, enquanto a solução de outro fornecedor leva nove. Para muitos bancos de dados, esses intervalos já não podem ser considerados aceitáveis, pois durante esse tempo o sistema é colocado em modo de espera e interrompe seu funcionamento. Isso se aplica principalmente a bancos de dados compostos por muitas partições.
A falha do terceiro controlador na Solução A não pode ser sobrevivida. Simplesmente porque o acesso a parte dos discos com dados é perdido. Por sua vez, a Solução B, em tal situação, restabelece sua funcionalidade, levando, como no caso anterior, nove segundos.
E quanto ao Dorado V6? Um segundo.
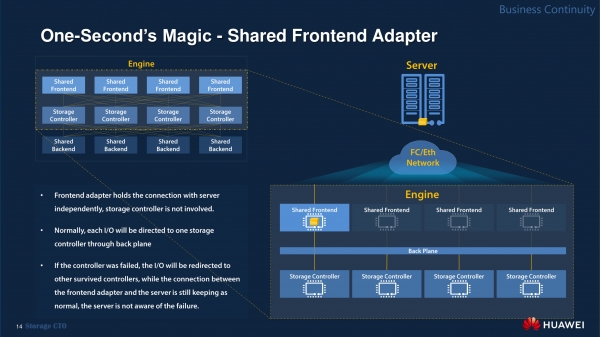
O que se pode fazer em um segundo
Quase nada, mas não precisamos disso. Reiteramos que no Dorado V6 da classe hi-end, a fábrica de frontend está desvinculada da fábrica de controladores. Isso significa que não há portas rigidamente designadas pertencentes a um controlador específico. A reconfiguração em caso de falha não implica na busca de caminhos alternativos ou na reconfiguração do multipath. O sistema continua funcionando como sempre.
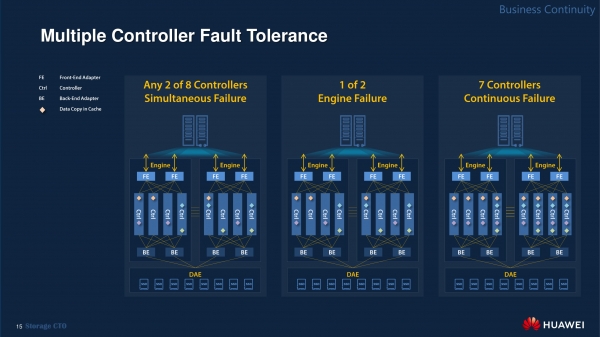
Resistência a múltiplas falhas
Os modelos mais avançados do Dorado V6 suportam sem problemas a falha simultânea de dois quaisquer (!) controladores de qualquer dos 'motores'. Isso se tornou possível porque agora a solução mantém três cópias do cache. Portanto, mesmo em caso de falha dupla, sempre haverá uma cópia íntegra.
A falha síncrona dos quatro controladores em um dos 'motores' também não causará consequências fatais, uma vez que todas as três cópias do cache estão distribuídas entre os 'motores' a qualquer momento. A própria sistema supervisiona a conformidade com essa lógica de operação.
Finalmente, um cenário extremamente improvável é a falha sequencial de sete controladores de um total de oito. Além disso, o intervalo mínimo permitido para manter a operação é de 15 minutos entre falhas individuais. Durante esse tempo, o sistema de armazenamento de dados consegue realizar as operações necessárias para a migração do cache.
O último controlador sobrevivente garantirá a operação do armazenamento de dados e manterá o cache por cinco dias (valor padrão, que pode ser facilmente alterado nas configurações). Após isso, o cache será desativado, mas a operação do sistema de armazenamento continuará.
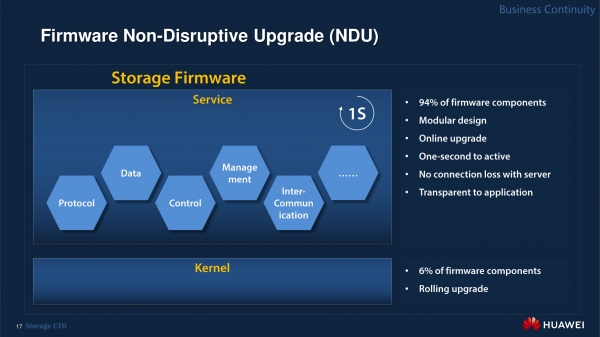
Atualizações não perturbadoras
O novo sistema operacional Dorado V6 permite atualizar o firmware do sistema de armazenamento sem reiniciar os controladores.
O sistema operacional, assim como no caso das soluções anteriores, é baseado no Linux, porém muitos processos operacionais foram transferidos do núcleo para o modo de usuário. A maioria das funções, como as responsáveis pela deduplicação e compressão, agora são processos de fundo executados por demônios comuns. Graças a isso, a atualização de módulos individuais não requer a troca de todo o sistema operacional. Por exemplo, para adicionar suporte a um novo protocolo, será necessário apenas desligar o módulo de software correspondente e iniciar o novo.
É evidente que as questões de atualização do sistema integral ainda permanecem, pois até mesmo no núcleo podem haver elementos que necessitam de atualização. No entanto, de acordo com nossas observações, isso representa menos de 6% do total. Isso permite reinicializar os controladores dezenas de vezes com menos frequência do que antes.
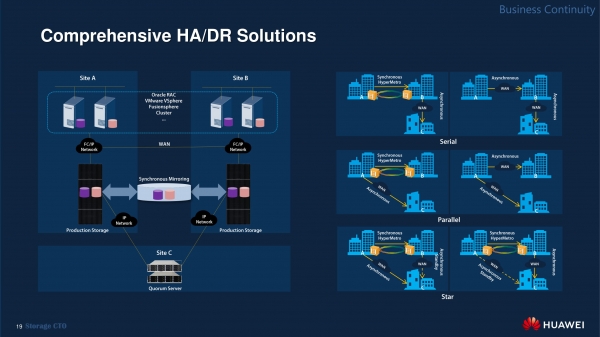
Soluções de recuperação de desastres e alta disponibilidade (HA/DR)
O Dorado V6 "pronto para uso" está preparado para integração em soluções geodistribuídas, clusters de nível urbano (metro) e data centers "triplos".
À esquerda na ilustração acima — o já conhecido metro-cluster. Dois sistemas de armazenamento (SXD) operam em modo ativo / ativo a uma distância de até 100 km um do outro. Essa infraestrutura com a presença de um ou mais servidores de quórum pode ser mantida por soluções de diferentes empresas, incluindo nosso sistema operacional em nuvem FusionSphere. Em tais projetos, as características do canal entre os sites adquiram especial importância, enquanto todas as outras tarefas são geridas pela função HyperMetro, que está disponível, novamente, "pronta para uso". A integração é possível por Fibre Channel, bem como por iSCSI em redes IP, se necessário. Não há mais necessidade de uma fibra óptica "escura" dedicada, pois o sistema pode se conectar através de canais existentes.
Na construção de tais sistemas, o único requisito de hardware para o SXD é a alocação de portas para replicação. É suficiente adquirir uma licença, iniciar servidores de quórum — físicos ou virtuais — e garantir conectividade IP até os controladores (10 Mbps, 50 ms).
Essa arquitetura é facilmente transferível para um sistema com três datacenters (veja a parte direita da ilustração). Por exemplo, quando dois datacenters operam em modo metro-cluster, enquanto o terceiro local, situado a mais de 100 km, utiliza replicação assíncrona.
O sistema suporta tecnologicamente diversos cenários de negócios que serão implementados em caso de um grande incidente.
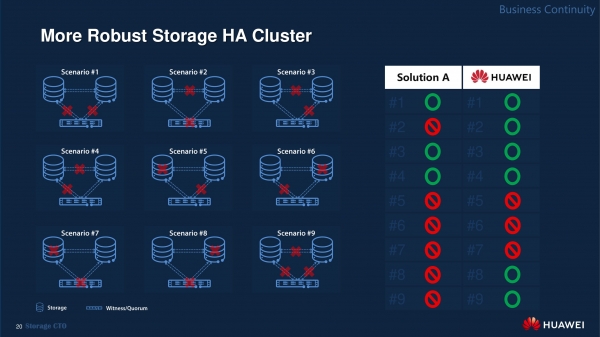
Sobrevivência do metro-cluster em caso de múltiplas falhas
Acima e abaixo também é mostrado um metro-cluster clássico, consistindo de dois sistemas de armazenamento e um servidor de quórum. Como você pode ver, em seis dos nove cenários possíveis de múltiplas falhas, nossa infraestrutura manterá a funcionalidade.
Por exemplo, no segundo cenário, em caso de falha do servidor de quorum e sincronização entre os locais, o sistema permanece produtivo, já que o segundo local interrompe suas operações. Esse comportamento já está embutido nos algoritmos integrados.
Mesmo após três falhas, o acesso à informação pode ser mantido se o intervalo entre elas for de pelo menos 15 segundos.
Um truque familiar na manga
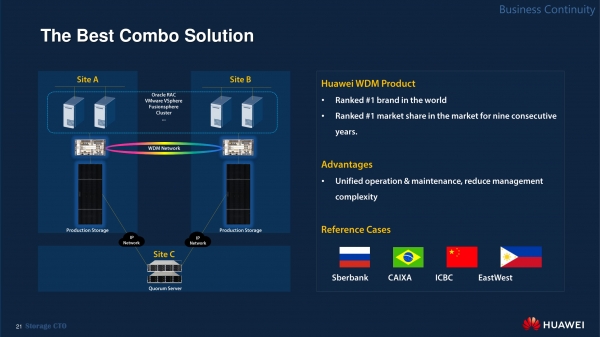
Vale lembrar que a Huawei produz não apenas soluções de armazenamento, mas também uma gama completa de equipamentos de rede. Independentemente do fornecedor de armazenamento que você escolher, se a rede WDM é utilizada entre os locais, em 90% das vezes ela será construída com soluções da nossa empresa. Surge a pergunta lógica: por que montar um zoológico de sistemas, quando todo o hardware garantidamente compatível pode ser obtido de um único fornecedor?
Sobre a questão do desempenho
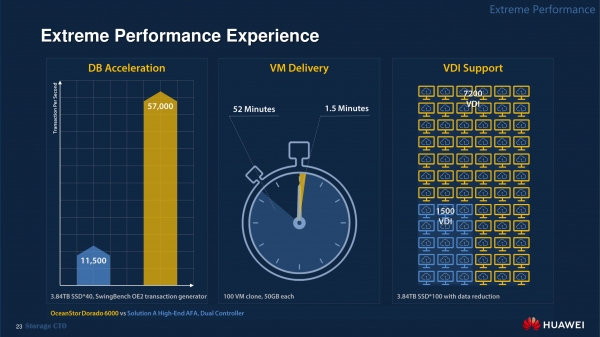
Provavelmente, ninguém precisa mais ser convencido de que a transição para soluções de armazenamento All-Flash pode reduzir significativamente os custos de manutenção da infraestrutura, já que todas as operações rotineiras são realizadas muito mais rapidamente. Isso é atestado por todos os fornecedores desse tipo de equipamento. Entretanto, muitos fornecedores começam a ser enganosos quando se trata da queda de desempenho ao ativar diferentes modos de operação das soluções de armazenamento.
Na nossa indústria, é comum fornecer soluções de armazenamento para testes de um ou dois dias. O fornecedor realiza um teste de 20 minutos em um sistema vazio, obtendo números impressionantes de desempenho. Porém, na operação real, rapidamente aparecem as ''armadilhas ocultas''. Após um dia, os belos valores de IOPS caem pela metade ou mais, e se o armazenamento estiver preenchido em 80%, ficam ainda menores. Ao mudar de RAID 5 para RAID 10, perde-se mais 10-15%, e no modo de cluster metro, o desempenho é adicionalmente reduzido pela metade.
Tudo o que foi mencionado acima não se aplica ao Dorado V6. Nossos clientes têm a oportunidade de executar um teste de desempenho durante o fim de semana ou pelo menos à noite. Assim, a coleta de lixo se manifesta, além de ficar claro como a ativação de várias opções – como snapshots e replicação – afeta os valores de IOPS atingidos.
No Dorado V6, os snapshots e o RAID com paridade afetam praticamente a performance (3–5% em vez de 10-15%). A coleta de lixo (preenchimento das células do armazenamento com zeros), compressão, deduplicação em sistemas de armazenamento ocupados em 80% sempre impactarão a velocidade total de processamento de requisições. Mas o que realmente torna o Dorado V6 interessante é que, não importa a combinação de funções e mecanismos de proteção que você ative, a performance final do sistema de armazenamento não cairá abaixo de 80% do valor obtido sem carga.
O balanceamento de carga
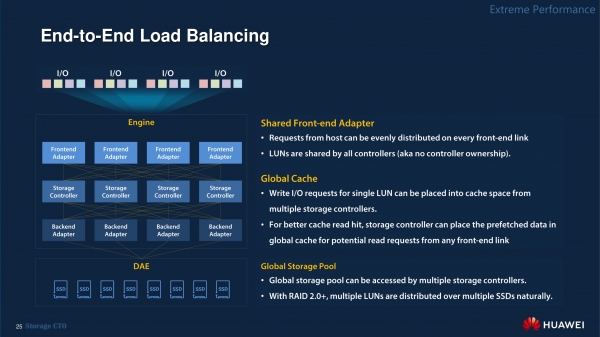
A alta performance do Dorado V6 é alcançada através do balanceamento em cada etapa, a saber:
- multi-passagem;
- uso de várias conexões de um único host;
- presença de uma fábrica de frontend;
- divisão do trabalho dos controladores do sistema de armazenamento;
- distribuição da carga entre todos os dispositivos de armazenamento em nível RAID 2.0+.
Em princípio, isso é uma prática comum. Hoje em dia, poucas pessoas mantêm todos os dados em um único LUN: todos tentam ter, pelo menos, oito, quarenta ou até mais. Esta é uma abordagem óbvia e correta, que apoiamos. Mas se sua tarefa requer apenas um LUN, que é mais fácil de manter, nossas soluções arquitetônicas permitem alcançar 80% da performance disponível usando múltiplos LUNs.
Planejamento dinâmico da carga dos processadores
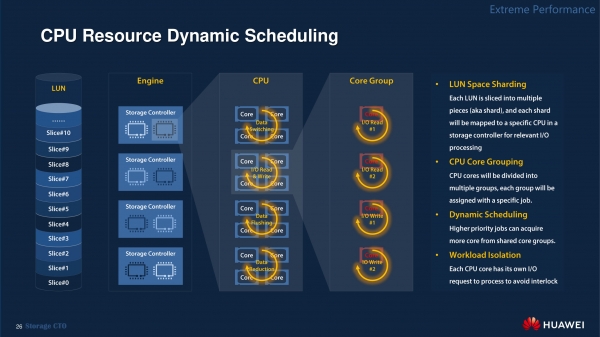
A distribuição da carga nos processadores ao usar um único LUN é implementada da seguinte maneira: as tarefas, ainda no nível do LUN, são divididas em pequenos "shards", cada um dos quais é rigidamente atribuído a um controlador específico no "motor". Isso é feito para que o sistema não perca performance enquanto "salta" com esse pedaço de dados entre diferentes controladores.
Outro mecanismo para manter alta performance é o escalonamento dinâmico, em que diferentes núcleos de processador podem ser alocados para diferentes pools de tarefas. Por exemplo, se no momento o sistema está ocioso em nível de deduplicação e compressão, parte dos núcleos pode ser ativada para o processo de atendimento de entrada e saída. Ou vice-versa. Tudo isso é realizado automaticamente e de forma transparente para o usuário.
As informações sobre a carga atual de cada núcleo do Dorado V6 não são exibidas na interface gráfica, mas através da linha de comando é possível acessar o sistema operacional do controlador e usar o comando normal do Linux. top.
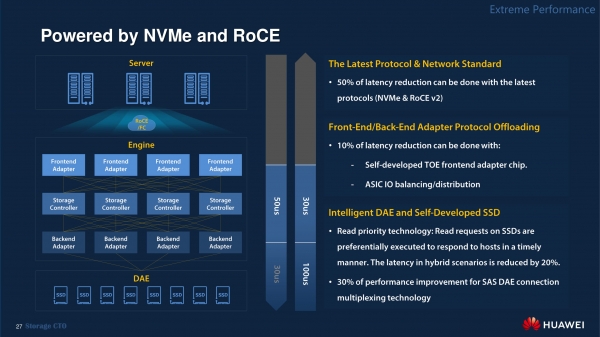
Suporte a NVMe e RoCE
Como já mencionado, neste momento, o Dorado V6 suporta completamente NVMe over Fibre Channel "pronto para uso" e não requer nenhuma licença. No meio do ano, haverá suporte para o modo NVMe over Ethernet. Para seu uso completo, será necessário suporte a Ethernet com acesso direto à memória (DMA) versão v2.0, tanto do lado do sistema de armazenamento quanto do lado dos switches e adaptadores de rede. Por exemplo, como o Mellanox ConnectX-4 ou ConnectX-5. Também podem ser utilizados adaptadores de rede baseados em nossos chips. Além disso, o suporte a RoCE deve ser implementado no nível do sistema operacional.
De forma geral, consideramos o Dorado V6 um sistema orientado a NVMe. Apesar do suporte existente ao Fibre Channel e iSCSI, está planejada uma transição futura para Ethernet de alta velocidade com RDMA.
Uma pitada de marketing
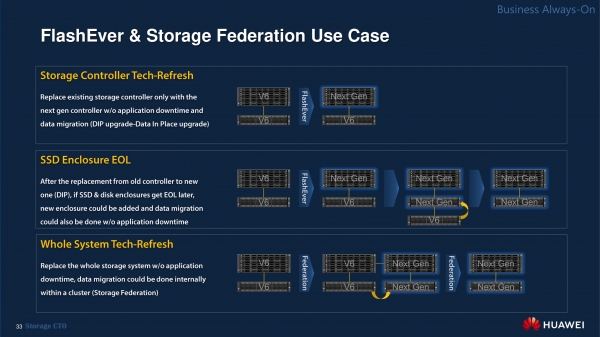
Graças à alta resistência a falhas do sistema Dorado V6, sua boa escalabilidade horizontal, suporte a várias tecnologias de migração, etc., o efeito econômico de sua aquisição se manifesta com o início da exploração intensa do sistema de armazenamento. Continuaremos a nos esforçar para tornar a posse do sistema o mais vantajosa possível, mesmo que na primeira fase isso não seja evidente.
Em particular, criamos o programa FLASH EVER, relacionado à extensão do ciclo de vida do sistema de armazenamento e projetado para aliviar o cliente na realização de upgrades.
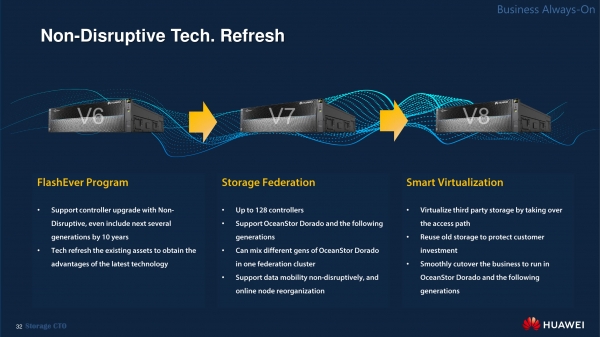
Este programa inclui uma série de medidas:
- possibilidade de substituição gradual dos controladores e prateleiras com discos por novas versões sem a necessidade de substituir todo o equipamento (para sistemas Dorado V6 da classe hi-end);
- possibilidade de armazenamento federativo (união de diferentes versões do Dorado dentro de um único cluster híbrido de armazenamento);
- virtualização inteligente (capacidade de usar equipamentos de terceiros como parte da solução Dorado).
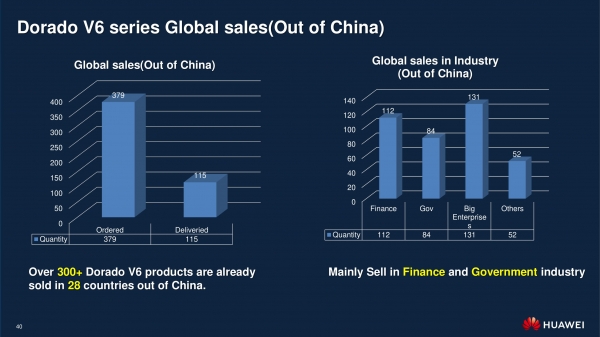
Vale ressaltar que a situação complexa no mundo teve pouco impacto nas perspectivas comerciais do novo sistema. Apesar de o lançamento oficial do Dorado V6 ter ocorrido apenas em janeiro, observamos uma demanda significativa por ele na China, além de um grande interesse por parte de parceiros russos e internacionais nos setores financeiro e governamental.
Além disso, em decorrência da pandemia, por quanto tempo ela durar, surge de forma aguda a questão de fornecer desktops virtuais para os funcionários remotos. Nesse processo, o Dorado V6 também poderia resolver muitas questões. Para isso, estamos fazendo todos os esforços necessários, incluindo uma negociação praticamente finalizada para a inclusão do novo sistema na lista de compatibilidade da VMware.
***
Aliás, não se esqueça de nossos inúmeros webinars, realizados não apenas na comunidade de língua russa, mas também em nível global. A lista de webinars de abril está disponível em .
Fonte: habr.com
