

Olá, Habr! Apresento a vocês a tradução do artigo autores Burak Yavuz, Brenner Heintz e Denny Lee, que foi preparado antes do início do curso da OTUS.
Os dados, assim como nossa experiência, estão sempre se acumulando e evoluindo. Para não ficarmos para trás, nossos modelos mentais do mundo precisam se adaptar a novos dados, alguns dos quais contêm novas dimensões — novas maneiras de observar coisas que antes não tínhamos ideia. Esses modelos mentais são pouco diferentes dos esquemas de tabelas que definem como classificamos e processamos novas informações.
Isso nos leva à questão da gestão de esquemas. À medida que as necessidades e requisitos de negócios mudam ao longo do tempo, a estrutura de seus dados também muda. O Delta Lake permite a implementação fácil de novas dimensões ao modificar dados. Os usuários têm acesso a uma semântica simples para gerenciar os esquemas de suas tabelas. Essas ferramentas incluem a aplicação forçada de esquemas (Schema Enforcement), que protege os usuários contra contaminações acidentais de suas tabelas por erros ou dados indesejados, bem como a evolução de esquemas (Schema Evolution), que permite adicionar automaticamente novas colunas com dados valiosos nos locais apropriados. Neste artigo, vamos nos aprofundar no uso dessas ferramentas.
Entendendo os esquemas de tabelas
Cada DataFrame no Apache Spark contém um esquema que define a forma dos dados, como tipos de dados, colunas e metadados. Com o Delta Lake, o esquema da tabela é salvo no formato JSON dentro do log de transações.
O que é a aplicação forçada de esquemas?
A aplicação forçada de esquemas (Schema Enforcement), também conhecida como verificação de esquemas (Schema Validation), é um mecanismo de proteção no Delta Lake que garante a qualidade dos dados, rejeitando registros que não atendem ao esquema da tabela. Assim como uma anfitriã na recepção de um restaurante popular que aceita apenas reservas, ele verifica se cada coluna de dados inserida na tabela está na lista correta de colunas esperadas (em outras palavras, se há uma 'reserva' para cada uma delas) e rejeita qualquer registro com colunas que não estão na lista.
Como funciona a aplicação forçada de esquemas?
O Delta Lake utiliza verificação de schema ao gravar, o que significa que todas as novas gravações na tabela são verificadas quanto à compatibilidade com o schema da tabela de destino durante a gravação. Se o schema não for compatível, o Delta Lake reverte completamente a transação (os dados não são gravados) e gera uma exceção para informar o usuário sobre a inconsistência.
Para determinar a compatibilidade da gravação, o Delta Lake utiliza as seguintes regras. DataFrame a ser gravado:
- não pode conter colunas adicionais que não estão no schema da tabela de destino. E, vice-versa, está tudo certo se os dados de entrada não contiverem todas as colunas da tabela — essas colunas simplesmente receberão valores nulos.
- não pode ter tipos de dados das colunas que sejam diferentes dos tipos de dados das colunas na tabela de destino. Se uma coluna da tabela de destino contém dados do tipo StringType, mas a coluna correspondente no DataFrame contém dados do tipo IntegerType, a aplicação forçada do schema gerará uma exceção e impedirá a execução da operação de gravação.
- não pode conter nomes de colunas que diferem apenas em maiúsculas e minúsculas. Isso significa que você não pode ter colunas com os nomes ‘Foo’ e ‘foo’ definidas na mesma tabela. Embora o Spark possa ser configurado para ser sensível ou não sensível (por padrão) a maiúsculas e minúsculas, o Delta Lake mantém a sensibilidade a maiúsculas e minúsculas, mas é insensível no que diz respeito ao armazenamento do schema. Parquet é sensível a maiúsculas e minúsculas ao armazenar e retornar informações de colunas. Para evitar possíveis erros, corrupção de dados ou perda deles (como já encontramos pessoalmente na Databricks), decidimos adicionar essa restrição.
Para ilustrar isso, vamos dar uma olhada no que acontece no código abaixo ao tentar adicionar algumas colunas recém-geradas em uma tabela Delta Lake que ainda não está configurada para aceitá-las.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
Em vez de adicionar automaticamente novas colunas, o Delta Lake impõe o schema e interrompe a gravação. Para ajudar a identificar qual coluna (ou quais) é a causa da inconsistência, o Spark emite ambos os schemas do stack trace para comparação.
Qual é a vantagem da aplicação forçada do schema?
Como a aplicação forçada de esquemas é uma verificação bastante rigorosa, é uma excelente ferramenta para ser usada como um guardião de um conjunto de dados limpos e totalmente transformados, prontos para produção ou consumo. Geralmente, é aplicado a tabelas que fornecem dados diretamente:
- Algoritmos de aprendizado de máquina
- Painéis de BI
- Análise de dados e ferramentas de visualização
- Qualquer sistema de produção que exija esquemas semânticos rigorosamente estruturados e tipados.
Para preparar seus dados para essa barreira final, muitos usuários utilizam uma arquitetura simples de "multi-hop" que gradualmente impõe estrutura às suas tabelas. Para saber mais sobre isso, você pode conferir o artigo
Claro, a aplicação forçada de esquemas pode ser utilizada em qualquer lugar do seu pipeline, mas lembre-se de que a gravação em fluxo em uma tabela pode ser frustrante, especialmente se você esquecer que adicionou uma nova coluna aos dados de entrada.
Prevenção de desagregação de dados
Nesse ponto, você pode se perguntar por que todo esse alvoroço? Afinal, às vezes, um erro inesperado de "incompatibilidade de esquema" pode atrapalhar seu fluxo de trabalho, especialmente se você é novo no Delta Lake. Por que simplesmente não permitir que o esquema mude como necessário para que eu possa gravar meu DataFrame, custe o que custar?
Como diz o velho ditado, "uma onça de prevenção vale uma libra de remédio". Em algum momento, se você não tomar cuidado com a aplicação do seu esquema, problemas de compatibilidade de tipos de dados surgirão — fontes de dados brutos aparentemente homogêneas podem conter casos limites, colunas corrompidas, mapeamentos mal formados ou outras coisas desagradáveis que assombram pesadelos. A melhor abordagem é deter esses inimigos na porta — através da aplicação forçada de esquemas — e lidar com eles à luz do dia, em vez de mais tarde, quando começarem a vaguear nas profundezas sombrias do seu código de trabalho.
A aplicação forçada do esquema garante que a estrutura da sua tabela não mudará, a menos que você mesmo confirme uma alteração. Isso evita a "diluição" dos dados, que pode ocorrer quando novas colunas são adicionadas com tanta frequência que tabelas antes valiosas e compactadas perdem seu significado e utilidade devido a um excesso de dados. Incentivando você a ser intencional, estabelecer altos padrões e esperar alta qualidade, a aplicação forçada do esquema faz exatamente o que foi projetado — ajuda você a permanecer diligente e suas tabelas a ficarem limpas.
Se, ao considerar mais a fundo, você decidir que deve realmente é necessário adicionar uma nova coluna — sem problemas, aqui está uma correção em uma linha. A solução é a evolução do esquema!
O que é a evolução do esquema?
A evolução do esquema é uma funcionalidade que permite aos usuários facilmente modificar o esquema atual da tabela de acordo com dados que mudam ao longo do tempo. É mais comumente utilizada ao executar uma operação de adição ou reescrita, para adaptar automaticamente o esquema para incluir uma ou mais novas colunas.
Como funciona a evolução do esquema?
Seguindo o exemplo da seção anterior, os desenvolvedores podem facilmente usar a evolução do esquema para adicionar novas colunas que anteriormente foram rejeitadas devido a incompatibilidade com o esquema. A evolução do esquema é ativada adicionando .option('mergeSchema', 'true') ao seu comando Spark .write ou .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
Para visualizar o gráfico, execute a seguinte consulta Spark SQL
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 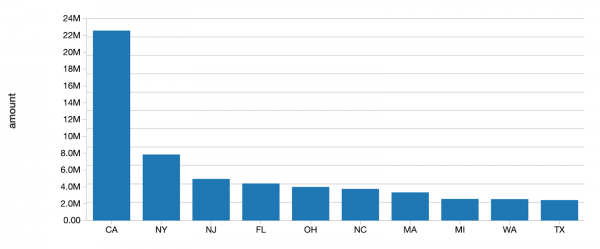
Como alternativa, você pode definir esta opção para toda a sessão Spark, adicionando spark.databricks.delta.schema.autoMerge = True na configuração do Spark. Mas use isso com cuidado, pois a aplicação forçada do esquema não irá mais alertá-lo sobre incompatibilidades inesperadas.
Incorporando ao seu pedido o parâmetro mergeSchema, todas as colunas que estiverem presentes no DataFrame, mas ausentes na tabela de destino, serão automaticamente adicionadas ao final do esquema durante a transação de gravação. Campos aninhados também podem ser adicionados e serão incluídos no final das colunas correspondentes da estrutura.
Engenheiros e cientistas podem usar esta opção para adicionar novas colunas (como uma métrica monitorada recentemente ou uma coluna de vendas deste mês) às suas tabelas de produção de aprendizado de máquina existentes, sem quebrar os modelos existentes baseados em colunas antigas.
Os seguintes tipos de alterações de esquema são permitidas no contexto da evolução do esquema ao adicionar ou reescrever uma tabela:
- Adição de novas colunas (este é o cenário mais comum)
- Alteração de tipos de dados de NullType -> qualquer outro tipo ou elevação de ByteType -> ShortType -> IntegerType
Outras alterações, não permitidas no contexto da evolução do esquema, exigem que o esquema e os dados sejam reescritos através da adição .option("overwriteSchema", "true"). Por exemplo, se a coluna "Foo" era originalmente do tipo inteiro e o novo esquema fosse do tipo string, então todos os arquivos Parquet (dados) precisariam ser reescritos. Alterações como estas incluem:
- remoção da coluna
- alteração do tipo de dados de uma coluna existente (in-place)
- renomeação de colunas que diferem apenas por maiúsculas e minúsculas (por exemplo, "Foo" e "foo")
Finalmente, com o próximo lançamento do Spark 3.0, o DDL explícito será totalmente suportado (usando ALTER TABLE), permitindo que os usuários realizem as seguintes operações em esquemas de tabelas:
- adição de colunas
- alteração de comentários de colunas
- configuração de propriedades da tabela que definem o comportamento da tabela, como a definição da duração de retenção do log de transações.
Qual é a vantagem da evolução do esquema?
A evolução do esquema pode ser usada sempre que você pretende modificar o esquema de sua tabela (em contraste com situações em que você acidentalmente adicionou colunas ao seu DataFrame que não deveriam estar lá). Esta é a maneira mais simples de migrar seu esquema, pois adiciona automaticamente os nomes de coluna e tipos de dados corretos sem a necessidade de declará-los explicitamente.
Conclusão
A aplicação forçada do esquema reverte quaisquer novas colunas ou outras alterações no esquema que não sejam compatíveis com sua tabela. Ao estabelecer e manter esses altos padrões, analistas e engenheiros podem confiar que seus dados têm o mais alto nível de integridade, pensando sobre isso de forma clara e precisa, o que lhes permite tomar decisões empresariais mais eficazes.
Por outro lado, a evolução do esquema complementa a aplicação forçada, simplificando as alterações automáticas do esquema. No final das contas, isso não deveria ser complicado — adicionar uma coluna.
A aplicação forçada do esquema é o yang, enquanto a evolução do esquema é o yin. Quando usadas em conjunto, essas funcionalidades tornam mais fácil do que nunca filtrar o ruído e ajustar o sinal.
Gostaríamos também de agradecer a Mukul Murti e Pranav Anand por suas contribuições a este artigo.
Outros artigos desta série:
Artigos relacionados
Fonte: habr.com
