

TL;DR: Quatro anos atrás, deixei o Google com a ideia de uma nova ferramenta para monitoramento de servidores. A ideia era combinar em um único serviço funções geralmente isoladas. e análise de logs, coleta de métricas, e painéis de controle. Um dos princípios é que o serviço deve ser realmente rápido, proporcionando aos devops um trabalho fácil, interativo e prazeroso. Isso exige o processamento de conjuntos de dados de vários gigabytes em frações de segundo, sem extrapolar o orçamento. Ferramentas existentes para lidar com logs costumam ser lentas e complicadas, então nos deparamos com um bom desafio: desenvolver uma ferramenta que proporcionasse novas experiências aos usuários.
Este artigo descreve como nós, na Scalyr, resolvemos esse problema aplicando métodos de escola antiga, uma abordagem de força bruta, eliminando camadas desnecessárias e evitando estruturas de dados complexas. Essas lições podem ser aplicadas às suas próprias tarefas de engenharia.
A força da escola antiga
A análise de logs geralmente começa pela busca: encontrar todas as mensagens que correspondem a um determinado padrão. Na Scalyr, isso significa dezenas ou centenas de gigabytes de logs de vários servidores. Abordagens modernas costumam pressupor a construção de uma estrutura de dados complexa otimizada para busca. Eu, claro, já vi isso no Google, onde eles são bastante bons nessas coisas. Mas nós optamos por uma abordagem muito mais simples: a varredura linear de logs. E funcionou — oferecemos uma interface de busca que é muito mais rápida do que a dos concorrentes (veja a animação no final).
A grande revelação foi que os processadores modernos são realmente muito rápidos em operações simples e diretas. Isso é fácil de perder de vista em sistemas complexos e multicamadas que dependem da velocidade de I/O e operações de rede, e tais sistemas são muito comuns hoje em dia. Assim, desenvolvemos um design que minimiza o número de camadas e o tráfego desnecessário. Com vários processadores e servidores trabalhando em paralelo, a velocidade de busca atinge 1 TB por segundo.
Principais conclusões deste artigo:
- A busca bruta é uma abordagem viável para resolver problemas reais e escaláveis.
- Força bruta é uma técnica de design, não uma forma de se isentar do trabalho. Como qualquer técnica, ela se adapta melhor a certos problemas do que a outros, e pode ser implementada de forma ruim ou boa.
- A força bruta é especialmente eficaz para alcançar desempenho estável.
- O uso eficaz da força bruta exige otimização de código e a aplicação oportuna de recursos suficientes. Ela é adequada se seus servidores estiverem sob alta carga que não está relacionada a usuários, enquanto as operações dos usuários permanecem prioritárias.
- O desempenho depende do design de todo o sistema, não apenas do algoritmo do ciclo interno.
(Este artigo descreve a busca de dados na memória. Na maioria das vezes, quando um usuário realiza uma busca em logs, os servidores Scalyr já os cachearam. No próximo artigo, discutiremos a busca em logs não cacheados. Os mesmos princípios se aplicam: código eficiente, método de força bruta com grandes recursos computacionais).
Método de força bruta
Tradicionalmente, a busca em um grande conjunto de dados é realizada por meio de índices de palavras-chave. No contexto dos logs de servidor, isso significa buscar cada palavra única no registro. Para cada palavra, é necessário compilar uma lista de todas as ocorrências. Isso facilita encontrar todas as mensagens com essa palavra, como 'erro', 'firefox' ou 'transaction_16851951' – basta consultar o índice.
Eu usei essa abordagem no Google e funcionou bem. Mas no Scalyr, buscamos nos logs byte a byte.
Por quê? Do ponto de vista algorítmico abstrato, os índices de palavras-chave são muito mais eficazes do que a busca bruta. No entanto, não vendemos algoritmos, vendemos desempenho. E desempenho não se resume apenas a algoritmos, mas também à engenharia do sistema. Precisamos considerar tudo: o volume de dados, o tipo de busca, o hardware disponível e o contexto do software. Decidimos que, para nosso problema específico, uma abordagem como 'grep' se adequa melhor do que um índice.
Índices são ótimos, mas têm limitações. Encontrar uma única palavra é fácil. Mas buscar mensagens com várias palavras, como 'googlebot' e '404', já é muito mais complicado. A busca de uma frase como 'exception não capturada' requer um índice mais elaborado, que registre não só todas as mensagens com essa palavra, mas também a localização específica da palavra.
A verdadeira dificuldade surge quando você não está procurando palavras. Suponha que você queira ver quanto tráfego vem de bots. O primeiro pensamento é pesquisar nos logs pela palavra ‘bot’. Assim, você encontrará alguns bots: Googlebot, Bingbot e muitos outros. Mas aqui ‘bot’ não é uma palavra, mas parte dela. Se você procurar ‘bot’ no índice, não encontraremos mensagens com a palavra 'Googlebot'. Se verificarmos cada palavra no índice e, em seguida, escaneamos o índice pelos termos encontrados, a busca vai diminuir muito a velocidade. Como resultado, alguns programas para análise de logs não permitem pesquisas por partes da palavra ou (na melhor das hipóteses) permitem usar uma sintaxe especial com desempenho inferior. Queremos evitar isso.
Mais um problema é a pontuação. Quer encontrar todas as consultas de 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Finalmente, os engenheiros adoram ferramentas poderosas, e às vezes o problema só pode ser resolvido com uma expressão regular. O índice de palavras-chave não é muito adequado para isso.
Além disso, os índices são complicados. Cada mensagem precisa ser adicionada a várias listas de palavras-chave. Estas listas devem ser mantidas constantemente em um formato que facilite a busca. Consultas com frases, fragmentos de palavras ou expressões regulares precisam ser convertidas em operações com várias listas, e os resultados precisam ser escaneados e combinados para gerar o conjunto de resultados. No contexto de um serviço multimodal de grande escala, essa complexidade cria problemas de desempenho que não são visíveis ao analisar algoritmos.
Os índices de palavras-chave também ocupam muito espaço, e o armazenamento é o principal item de custo em um sistema de gerenciamento de logs.
Por outro lado, pode-se gastar muita potência computacional em cada pesquisa. Nossos usuários valorizam buscas em alta velocidade com consultas únicas, mas tais consultas são feitas relativamente raramente. Para consultas de busca típicas, como a do painel de monitoramento, aplicamos técnicas especiais (descreveremos isso no próximo artigo). Outras consultas são suficientemente raras, de modo que raramente precisamos processar mais de uma por vez. Mas isso não significa que nossos servidores não estão ocupados: eles estão carregados com o trabalho de receber, analisar e compactar novas mensagens, avaliar alertas, compactar dados antigos e assim por diante. Assim, temos uma reserva considerável de processadores que podem ser usados para executar consultas.
Força bruta funciona se você tiver um problema contundente (e muita força).
Força bruta funciona melhor em tarefas simples com ciclos internos pequenos. Muitas vezes, você pode otimizar o ciclo interno para funcionar em velocidades muito altas. Se o código for complicado, é muito mais difícil otimizá-lo.
Originalmente, nosso código de busca tinha um ciclo interno bastante grande. Armazenamos mensagens em páginas de 4K; cada página contém algumas mensagens (em UTF-8) e metadados para cada mensagem. Os metadados são uma estrutura que codifica o comprimento do valor, o ID interno da mensagem e outros campos. O ciclo de busca parecia assim:
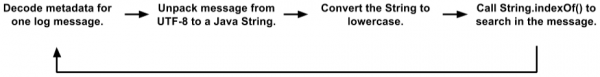
Esta é uma versão simplificada em comparação com o código real. Mas mesmo aqui, é visível várias alocações de objetos, cópias de dados e chamadas de funções. A JVM otimiza bastante bem as chamadas de funções e aloca objetos efêmeros, por isso esse código funcionou melhor do que merecíamos. Durante os testes, os clientes tiveram bastante sucesso em usá-lo. Mas, no final das contas, nós avançamos para um novo nível.
(Você pode se perguntar por que armazenamos mensagens nesse formato de páginas de 4K, com texto e metadados, em vez de trabalhar diretamente com logs. Existem muitos motivos que se resumem ao fato de que internamente o mecanismo Scalyr se assemelha mais a um banco de dados distribuído do que a um sistema de arquivos. A busca textual é frequentemente combinada com filtros do tipo SGBD em campos após a análise dos logs. Podemos buscar simultaneamente em milhares de logs de uma só vez, e arquivos de texto simples não são adequados para a nossa gestão de dados transacional, replicada e distribuída).
Inicialmente, parecia que esse código não era muito adequado para a otimização pelo método de força bruta. "O verdadeiro trabalho" em String.indexOf() não predominava nem mesmo no perfil da CPU. Ou seja, a otimização apenas desse método não teria um efeito substancial.
Acabou que armazenamos metadados no início de cada página, enquanto o texto de todas as mensagens em UTF-8 está compactado na outra extremidade. Aproveitando isso, reescrevemos o loop para buscar imediatamente em toda a página:
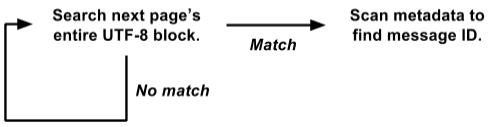
Essa versão trabalha diretamente na representação raw byte[] e realiza a busca de todas as mensagens de uma só vez em toda a página de 4K.
É muito mais fácil otimizar para o método de força bruta. O loop de busca interno é chamado simultaneamente para toda a página de 4K, e não separadamente para cada mensagem. Não há cópias de dados nem alocação de objetos. E operações mais complexas com metadados são invocadas apenas quando há um resultado positivo, e não para cada mensagem. Assim, eliminamos uma tonelada de sobrecarga, e o restante da carga está concentrado em um pequeno loop interno de busca, que se adapta bem a uma otimização posterior.
O nosso algoritmo de busca real é baseado na . Ele é semelhante ao algoritmo de Boyer-Moore com o pulo de aproximadamente o comprimento da string de busca em cada passo. A principal diferença é que ele verifica dois bytes por vez, para minimizar falsos positivos.
Nossa implementação exige a criação de uma tabela de pesquisa de 64K para cada busca, mas isso é nada comparado aos gigabytes de dados que estamos analisando. O laço interno processa vários gigabytes por segundo em um único núcleo. Na prática, o desempenho estável é de cerca de 1,25 GB por segundo em cada núcleo, e há potencial para melhorias. Algumas sobrecargas fora do laço interno podem ser eliminadas, e planejamos experimentar o laço interno em C em vez de Java.
Aplicando força
Discutimos que a pesquisa em logs pode ser realizada 'de forma bruta', mas quanta 'força' temos? Bastante.
1 núcleo: quando utilizado corretamente, um núcleo de processador moderno é bastante poderoso por si só.
8 núcleos: atualmente, estamos operando em servidores Amazon hi1.4xlarge e i2.4xlarge SSD, cada um com 8 núcleos (16 threads). Como mencionado anteriormente, geralmente esses núcleos estão ocupados com operações em segundo plano. Quando um usuário realiza uma busca, as operações em segundo plano são suspensas, liberando todos os 8 núcleos para a busca. A pesquisa normalmente é concluída em frações de segundo, após o que o trabalho em segundo plano é retomado (o programa regulador garante que uma explosão de consultas de busca não interfira no importante trabalho em segundo plano).
16 núcleos: para maior confiabilidade, organizamos os servidores em grupos master/slave. Cada master controla um servidor SSD e um EBS. Se o servidor principal falhar, o servidor SSD ocupa imediatamente o seu lugar. Quase o tempo todo, master e slave funcionam normalmente, então cada bloco de dados está disponível para pesquisa em dois servidores diferentes (o servidor EBS tem um processador fraco, então não o consideramos). Distribuímos a carga entre eles, de modo que temos um total de 16 núcleos disponíveis.
Muitos núcleos: em um futuro próximo, vamos distribuir os dados pelos servidores de forma que todos participem do processamento de cada solicitação não trivial. Cada núcleo estará em operação. [Nota: implementamos um plano e aumentamos a velocidade de pesquisa para 1 TB/s, veja a nota no final do artigo].
A simplicidade garante confiabilidade
Outra vantagem do método de força bruta é o desempenho bastante estável. Em geral, a pesquisa não é muito sensível aos detalhes da tarefa e do conjunto de dados (acho que é por isso que é chamada de 'bruta').
O índice de palavras-chave pode às vezes fornecer resultados incrivelmente rápidos, enquanto em outras situações não. Suponha que você tenha 50 GB de logs, onde o termo ‘customer_5987235982’ aparece exatamente três vezes. A busca por esse termo conta diretamente a partir do índice três localizações e termina instantaneamente. Mas uma busca complexa com curingas pode escanear milhares de palavras-chave e levar muito tempo.
Por outro lado, a busca por força bruta para qualquer consulta é realizada a uma velocidade mais ou menos constante. A pesquisa de palavras longas é melhor, mas até mesmo a busca por um único caractere ocorre de forma bastante rápida.
A simplicidade do método de força bruta significa que seu desempenho está próximo do máximo teórico. Aqui há menos chances de sobrecarga inesperada de discos, conflitos durante bloqueios, perseguição de ponteiros e mil outras razões para falhas. Eu simplesmente olhei para as consultas feitas pelos usuários do Scalyr na semana passada em nosso servidor mais carregado. Foram 14.000 consultas. Apenas oito delas levaram mais de um segundo; 99% foram concluídas em até 111 milissegundos (se você não usou ferramentas de análise de logs, acredite: é rápido).
Um desempenho estável e confiável é importante para a usabilidade do serviço. Se ele tiver paradas ocasionais, os usuários o considerarão pouco confiável e hesitarão em usá-lo.
Busca por logs em ação
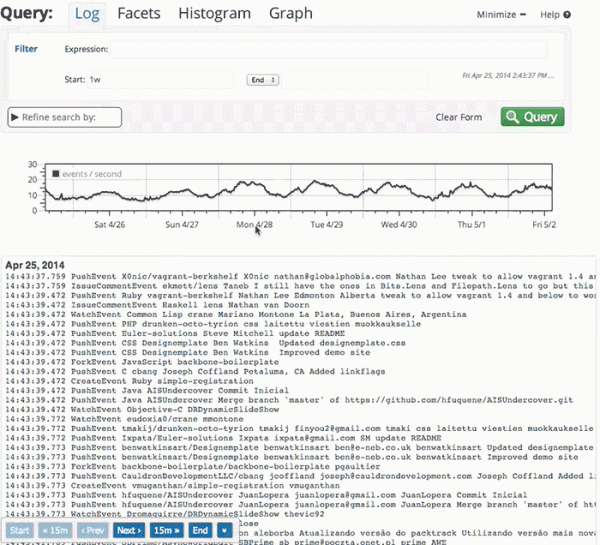
Aqui está uma pequena animação que mostra a busca Scalyr em ação. Temos uma conta de demonstração, onde importamos cada evento de cada repositório público do Github. Nesta demonstração, estou explorando dados de uma semana: cerca de 600 MB de logs não processados.
O vídeo foi gravado ao vivo, sem preparação especial, no meu desktop (cerca de 5000 quilômetros do servidor). O desempenho que você verá deve muito à , assim como ao backend rápido e confiável. Sempre que houver uma pausa sem o indicador ‘loading’, sou eu fazendo uma pausa para que você consiga ler o que estou prestes a clicar.
Para concluir
Ao lidar com grandes volumes de dados, é importante escolher um bom algoritmo, mas "bom" não significa "complicado". Pense em como seu código funcionará na prática. Alguns fatores que podem ser muito significativos no mundo real não aparecem na análise teórica dos algoritmos. Algoritmos mais simples são mais fáceis de otimizar e são mais estáveis em situações extremas.
Considere também o contexto em que o código será executado. No nosso caso, precisamos de servidores com capacidade suficiente para gerenciar tarefas em segundo plano. Os usuários raramente iniciam buscas, então podemos alugar um grupo inteiro de servidores por um curto período, o tempo necessário para realizar cada busca.
Usando um método de força bruta, implementamos uma busca rápida, confiável e flexível em um conjunto de logs. Esperamos que essas ideias sejam úteis para seus projetos.
Edição: o título e o texto mudaram de "Busca a uma velocidade de 20 GB por segundo" para "Busca a uma velocidade de 1 TB por segundo" para refletir o aumento de desempenho nos últimos anos. Esse aumento de velocidade está principalmente relacionado à mudança no tipo e na quantidade de servidores EC2 que estamos levantando hoje para atender à crescente base de clientes. Mudanças estão a caminho que proporcionarão um novo aumento significativo na eficiência, e estamos ansiosos para compartilhar isso assim que tivermos a oportunidade.
Fonte: habr.com
