

Continuação da tradução de um pequeno livro:
«Understanding Message Brokers»,
autor: Jakub Korab, editora: O’Reilly Media, Inc., data de publicação: Junho de 2017, ISBN: 9781492049296.
Parte anterior traduzida:
CAPÍTULO 3
Kafka
Kafka foi desenvolvido no LinkedIn para contornar algumas limitações dos corretores de mensagens tradicionais e evitar a necessidade de configurar vários corretores de mensagens para diferentes interações 'ponto a ponto', como descrito neste livro na seção 'Escalonamento Vertical e Horizontal' na página 28. Os cenários de uso no LinkedIn foram, em sua maioria, baseados em absorção unidirecional de grandes volumes de dados, como cliques em páginas e logs de acesso, permitindo ao mesmo tempo que esses dados fossem utilizados por vários sistemas, sem impactar a performance dos produtores ou de outros consumidores. De fato, a razão da existência do Kafka é estabelecer uma arquitetura de troca de mensagens, conforme descrito no Universal Data Pipeline.
Considerando esse objetivo final, naturalmente surgiram outras exigências. O Kafka deve:
- Ser extremamente rápido
- Fornecer alta capacidade de processamento ao lidar com mensagens
- Suportar modelos 'Publicador-Assinante' e 'Ponto a Ponto'
- Não desacelerar com a adição de consumidores. Por exemplo, a performance tanto das filas quanto dos tópicos no ActiveMQ se deteriora com o aumento do número de consumidores no destinatário
- Ser escalável horizontalmente; se um corretor que persiste mensagens só pode fazer isso na velocidade máxima do disco, então faz sentido ultrapassar a capacidade de uma única instância de corretor para aumentar a performance
- Delimitar o acesso ao armazenamento e à recuperação de mensagens
Para alcançar tudo isso, o Kafka adotou uma arquitetura que redefiniu os papéis e responsabilidades dos clientes e dos corretores de mensagens. O modelo JMS é muito centrado no corretor, onde ele é responsável pela distribuição de mensagens, enquanto os clientes precisam se preocupar apenas em enviar e receber mensagens. O Kafka, por outro lado, é centrado no cliente, onde o cliente assume muitas funções do corretor tradicional, como a distribuição justa de mensagens relevantes entre os consumidores, em troca de um corretor extremamente rápido e escalável. Para aqueles que trabalharam com sistemas tradicionais de troca de mensagens, trabalhar com o Kafka exige mudanças fundamentais na forma de pensar.
Essa abordagem de engenharia levou à criação de uma infraestrutura de troca de mensagens capaz de aumentar a largura de banda em muitos pedidos em comparação com um corretor convencional. Como veremos, essa abordagem envolve compromissos que significam que o Kafka não é adequado para certos tipos de cargas de trabalho e software estabelecido.
Modelo unificado de destinatário
Para atender aos requisitos mencionados acima, o Kafka combinou mensagens do tipo 'publicação-assinatura' e 'ponto-a-ponto' em um único tipo de destinatário — tópico. Isso confunde pessoas que trabalharam com sistemas de troca de mensagens onde a palavra 'tópico' se refere a um mecanismo de transmissão, do qual a leitura (do tópico) não é confiável (é não durável). Os tópicos no Kafka devem ser vistos como um tipo híbrido de destinatário, de acordo com a definição fornecida na introdução deste livro.
Na restante parte deste capítulo, a menos que indiquemos explicitamente o contrário, o termo 'tópico' se referirá ao tópico do Kafka.
Para entender completamente como os tópicos se comportam e quais garantias oferecem, devemos primeiro considerar como eles são implementados no Kafka.
Cada tópico no Kafka tem seu próprio log.
Os produtores que enviam mensagens para o Kafka escrevem neste log, enquanto os consumidores leem do log usando ponteiros que se movem constantemente para frente. Periodicamente, o Kafka remove as partes mais antigas do log, independentemente de as mensagens nessas partes terem sido lidas ou não. A parte central do design do Kafka é que o broker não se preocupa se as mensagens foram lidas ou não — essa é uma responsabilidade do cliente.
Os termos “log” e “ponteiro” não aparecem na . Estes termos bem conhecidos são utilizados aqui para ajudar na compreensão.
Este modelo é completamente diferente do ActiveMQ, onde as mensagens de todas as filas são armazenadas em um único log e o broker marca as mensagens como removidas depois que foram lidas.
Vamos agora nos aprofundar um pouco e examinar o log do tópico com mais detalhes.
O log do Kafka consiste em várias partições (). O Kafka garante uma ordenação estrita em cada partição. Isso significa que as mensagens gravadas em uma partição em uma determinada ordem serão lidas na mesma ordem. Cada partição é implementada como um arquivo de log cíclico (rolling) que contém um subconjunto (subset) de todas as mensagens enviadas para o tópico por seus produtores. O tópico criado contém por padrão uma partição. A ideia de partições é o conceito central do Kafka para escalabilidade horizontal.
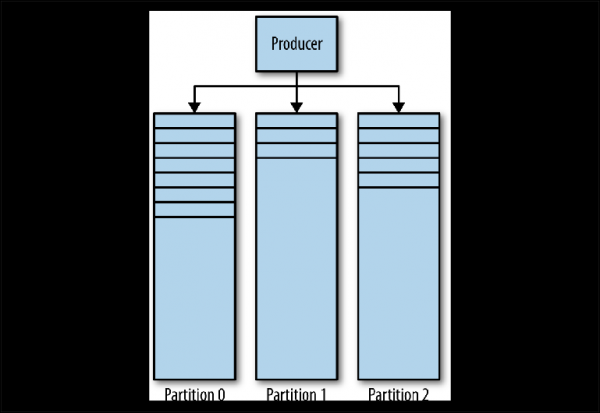
Figura 3-1. Partições do Kafka
Quando um produtor envia uma mensagem para um tópico Kafka, ele decide em qual partição enviar a mensagem. Vamos abordar isso com mais detalhes mais tarde.
Leitura de mensagens
O cliente que deseja ler mensagens gerencia um ponteiro nomeado chamado grupo de consumidores (consumer group), que aponta para o deslocamento (offset) da mensagem na partição. O deslocamento é uma posição com um número crescente que começa em 0 no início da partição. Este grupo de consumidores, ao qual se refere na API através de um identificador definido pelo usuário group_id, corresponde a um único consumidor lógico ou sistema.
A maioria dos sistemas que utilizam troca de mensagens lê os dados do destinatário através de várias instâncias e fluxos para o processamento paralelo das mensagens. Assim, geralmente haverá muitas instâncias de consumidores compartilhando um mesmo grupo de consumidores.
O problema da leitura pode ser apresentado da seguinte forma:
- O tópico possui várias partições
- Múltiplos grupos de consumidores podem usar o tópico simultaneamente
- Um grupo de consumidores pode ter várias instâncias separadas
Este é um problema não trivial de 'muitos para muitos'. Para entender como o Kafka lida com as relações entre grupos de consumidores, instâncias de consumidores e partições, vamos considerar uma série de cenários de leitura que se tornam gradualmente mais complexos.
Consumidores e grupos de consumidores
Vamos tomar como ponto de partida um tópico com uma partição ().
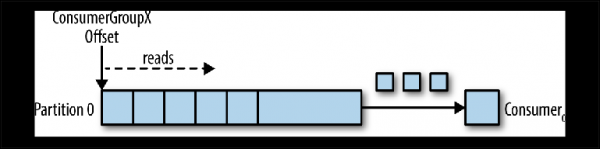
Figura 3-2. O consumidor lê a partir da partição
Quando uma instância de consumidor se conecta a este tópico com seu próprio group_id, uma partição é designada para leitura e um deslocamento nesta partição. A posição desse deslocamento é configurada no cliente, como um ponteiro para a posição mais recente (a mensagem mais nova) ou a posição mais antiga (a mensagem mais antiga). O consumidor solicita (polls) as mensagens do tópico, resultando em sua leitura sequencial do registro.
A posição do deslocamento é regularmente confirmada de volta ao Kafka e armazenada como mensagens no tópico interno _consumer_offsets. As mensagens lidas não são removidas, ao contrário de um broker comum, e o cliente pode retroceder (rewind) o deslocamento para reprocessar mensagens já visualizadas.
Quando um segundo consumidor lógico se conecta, usando um group_id diferente, ele gerencia um segundo ponteiro que não depende do primeiro (). Dessa forma, o tópico Kafka funciona como uma fila, onde existe um consumidor, e como um tópico convencional de publicação-assinatura (pub-sub), no qual vários consumidores estão inscritos, com a vantagem adicional de que todas as mensagens são armazenadas e podem ser processadas várias vezes.
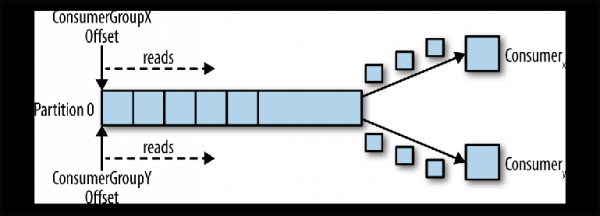
Figura 3-3. Dois consumidores em diferentes grupos de consumidores leem de uma partição
Consumidores em um grupo de consumidores
Quando uma instância do consumidor lê dados de uma partição, ela controla completamente o apontador e processa as mensagens, como descrito na seção anterior.
Se várias instâncias de consumidores estiverem conectadas com o mesmo group_id a um tópico com uma partição, a instância que se conectar por último obterá o controle sobre o apontador e, a partir desse momento, receberá todas as mensagens ().
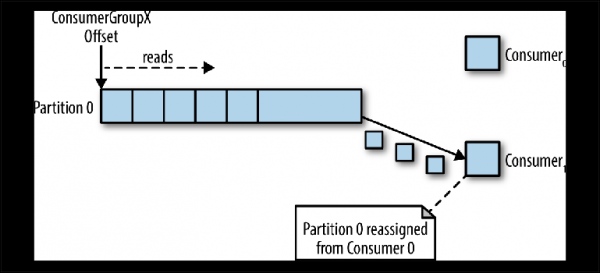
Figura 3-4. Duas instâncias de consumidores no mesmo grupo de consumidores leem de uma partição
Esse modo de processamento, em que o número de instâncias de consumidores supera o número de partições, pode ser considerado uma forma de consumidor monopolista. Isso pode ser útil se você precisar de uma clusterização "ativa-passiva" (ou "quente-morna") de suas instâncias de consumidores, embora a operação paralela de vários consumidores ("ativa-ativa" ou "quente-quente") seja muito mais típica do que consumidores em modo de espera.
Esse comportamento de distribuição de mensagens, descrito acima, pode surpreender em comparação com o que acontece em uma fila JMS comum. Nesse modelo, as mensagens enviadas para a fila são distribuídas uniformemente entre os dois consumidores.
Na maioria das vezes, ao criar várias instâncias de consumidores, fazemos isso para processamento paralelo de mensagens, para aumentar a velocidade de leitura ou para melhorar a resiliência do processo de leitura. Como uma instância de consumidor pode ler dados de uma partição simultaneamente, como isso é alcançado no Kafka?
Uma das maneiras de fazer isso é usar uma instância de consumidor para ler todas as mensagens e passar para um pool de threads. Embora essa abordagem aumente a taxa de processamento, aumenta a complexidade da lógica dos consumidores e não faz nada para melhorar a resiliência do sistema de leitura. Se uma instância de consumidor falhar devido a uma perda de energia ou evento semelhante, a leitura é interrompida.
A maneira canônica de resolver esse problema no Kafka é usar umAmaior número de partições.
Particionamento
As partições são o principal mecanismo para paralelizar a leitura e escalar o tópico além da capacidade de um único broker. Para entender melhor isso, vamos considerar uma situação em que existe um tópico com duas partições e um consumidor se inscreve neste tópico ().
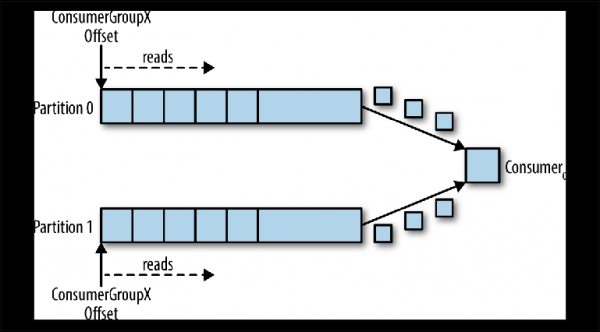
Figura 3-5. Um consumidor lê de várias partições
Neste cenário, o consumidor tem controle sobre os ponteiros correspondentes ao seu group_id em ambas as partições e começa a ler mensagens de ambas as partições.
Quando um consumidor adicional é adicionado a este tópico para o mesmo group_id, o Kafka realoca uma das partições do primeiro para o segundo consumidor. A partir daí, cada instância do consumidor lerá de uma partição do tópico ().
Para garantir o processamento de mensagens em paralelo em 20 threads, você precisará de pelo menos 20 partições. Se houver menos partições, você terá consumidores que não têm nada com o que trabalhar, como discutido anteriormente no tópico dos consumidores monopolistas.
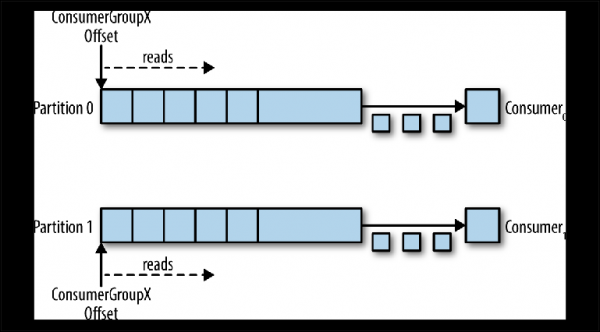
Figura 3-6. Dois consumidores no mesmo grupo de consumidores leem de partições diferentes
Esse esquema reduz significativamente a complexidade do trabalho do broker Kafka em comparação com a distribuição de mensagens necessária para suportar uma fila JMS. Aqui, não é necessário se preocupar com os seguintes aspectos:
- Qual consumidor deve receber a próxima mensagem, com base na distribuição em round-robin, na capacidade atual dos buffers de pré-busca ou em mensagens anteriores (como para grupos de mensagens JMS).
- Quais mensagens foram enviadas para quais consumidores e se devem ser entregues novamente em caso de falha.
Tudo o que o broker Kafka precisa fazer é encaminhar mensagens sequencialmente ao consumidor quando este as solicita.
No entanto, as exigências para a paralelização da leitura e reenvio de mensagens falhas não desaparecem - a responsabilidade por elas simplesmente passa do broker para o cliente. Isso significa que elas devem ser consideradas no seu código.
Envio de Mensagens
A responsabilidade pela decisão de em qual partição enviar uma mensagem recai sobre o produtor dessa mensagem. Para entender o mecanismo pelo qual isso é feito, primeiro precisamos considerar o que exatamente estamos enviando.
Enquanto no JMS usamos uma estrutura de mensagem com metadados (cabeçalhos e propriedades) e um corpo contendo a carga útil (payload), no Kafka a mensagem é um par "chave-valor".A carga útil da mensagem é enviada como o valor (value). A chave, por outro lado, é usada principalmente para particionamento e deve conter uma chave específica para a lógica de negócios, para colocar mensagens relacionadas na mesma partição.
No Capítulo 2, discutimos o cenário de apostas online, onde eventos relacionados devem ser processados em ordem por um único consumidor:
- A conta do usuário está configurada.
- O dinheiro é creditado na conta.
- Uma aposta é feita, retirando dinheiro da conta.
Se cada evento representa uma mensagem enviada para o tópico, então a chave natural seria o identificador da conta.
Quando uma mensagem é enviada usando a API do Kafka Producer, ela é passada para a função de particionamento, que, considerando a mensagem e o estado atual do cluster Kafka, retorna o identificador da partição para a qual a mensagem deve ser enviada. Esta função é implementada em Java através da interface Partitioner.
Esta interface é a seguinte:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
A implementação do Partitioner para determinar a partição usa por padrão um algoritmo de hash da chave (general-purpose hashing algorithm over the key) ou round-robin, se a chave não for especificada. Este valor padrão funciona bem na maioria dos casos. No entanto, no futuro, você pode querer escrever o seu próprio.
Escrevendo sua própria estratégia de particionamento
Vamos considerar um exemplo em que você deseja enviar metadados junto com a carga útil da mensagem. A carga útil no nosso exemplo é uma instrução para fazer um depósito na conta de jogo. A instrução é algo que gostaríamos de garantir que não será modificado durante a transmissão e queremos ter certeza de que apenas um sistema confiável de nível superior pode iniciar essa instrução. Nesse caso, os sistemas remetente e receptor concordam em usar uma assinatura para verificar a autenticidade da mensagem.
No JMS padrão, simplesmente definimos a propriedade "assinatura da mensagem" e a acrescentamos à mensagem. No entanto, o Kafka não nos fornece um mecanismo para transmitir metadados — apenas chave e valor.
Como o valor é a carga útil de uma transferência bancária, cuja integridade queremos preservar, não temos escolha a não ser definir uma estrutura de dados para usar na chave. Assumindo que precisamos de um identificador de conta para particionar, já que todas as mensagens relacionadas à conta devem ser processadas em ordem, iremos criar a seguinte estrutura JSON:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Como o valor da assinatura variará dependendo da carga útil, a estratégia padrão de hash da interface Partitioner não irá agrupar mensagens relacionadas de forma confiável. Portanto, precisaremos escrever nossa própria estratégia, que analisará essa chave e particionará o valor accountId.
O Kafka inclui somatórios de verificação para detectar corrupção de mensagens no armazenamento e possui um conjunto completo de funcionalidades de segurança. Mesmo assim, às vezes surgem requisitos específicos da indústria, como o mencionado acima.
A estratégia de particionamento personalizada deve garantir que todas as mensagens relacionadas sejam colocadas na mesma partição. Embora isso pareça simples, a exigência pode ser complicada devido à importância de ordenar mensagens relacionadas e a rigidez do número de partições no tópico.
O número de partições em um tópico pode mudar ao longo do tempo, pois podem ser adicionadas se o tráfego exceder as expectativas iniciais. Assim, as chaves de mensagem podem estar associadas à partição para a qual foram enviadas inicialmente, implicando uma parte do estado que deve ser distribuído entre as instâncias do produtor.
Outro fator a ser considerado é a uniformidade da distribuição de mensagens entre partições. De modo geral, as chaves não são distribuídas uniformemente entre as mensagens, e funções de hash não garantem uma distribuição justa de mensagens para um pequeno conjunto de chaves.
É importante notar que, independentemente de como você decide dividir as mensagens, o próprio delimitador pode precisar ser reutilizado.
Consideremos o requisito de replicação de dados entre clusters Kafka em diferentes locais geográficos. Para isso, o Kafka vem com uma ferramenta de linha de comando chamada MirrorMaker, que é usada para ler mensagens de um cluster e transmiti-las para outro.
O MirrorMaker deve entender as chaves do tópico replicado para manter a ordem relativa entre as mensagens durante a replicação entre clusters, uma vez que o número de partições desse tópico pode não coincidir em ambos os clusters.
Estratégias de particionamento personalizadas são relativamente raras, pois a partição padrão por hashing ou round-robin funciona com sucesso na maioria dos cenários. No entanto, se você precisa de garantias rigorosas de ordenação ou precisa extrair metadados das cargas úteis, o particionamento é algo que você deve examinar com mais detalhes.
Os benefícios de escalabilidade e desempenho do Kafka são devido à transferência de algumas responsabilidades de um corretor tradicional para o cliente. Neste caso, uma decisão é tomada para distribuir mensagens potencialmente relacionadas entre vários consumidores que trabalham em paralelo.
Os corretores JMS também precisam lidar com esses requisitos. Curiosamente, o mecanismo de envio de mensagens relacionadas ao mesmo consumidor, implementado por meio de JMS Message Groups (uma variante da estratégia de balanceamento de carga sticky load balancing (SLB)), também requer que o remetente marque as mensagens como relacionadas. No caso do JMS, o corretor é responsável por enviar este grupo de mensagens relacionadas a um consumidor entre muitos e transferir a propriedade do grupo se o consumidor falhar.
Acordos sobre o produtor
O particionamento não é a única coisa a considerar ao enviar mensagens. Vamos considerar os métodos send() da classe Producer na API Java:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
É importante notar que ambos os métodos retornam um Future, indicando que a operação de envio não é realizada imediatamente. Como resultado, a mensagem (ProducerRecord) é gravada no buffer de envio para cada partição ativa e enviada ao corretor em uma thread de fundo na biblioteca cliente do Kafka. Embora isso torne a operação incrivelmente rápida, significa que um aplicativo mal escrito pode perder mensagens se seu processo for interrompido.
Como sempre, há uma maneira de tornar a operação de envio mais confiável em termos de desempenho. O tamanho desse buffer pode ser definido como 0, forçando a thread do aplicativo enviador a aguardar até que a transmissão da mensagem ao corretor seja concluída, da seguinte forma:
RecordMetadata metadata = producer.send(record).get();Novamente sobre a leitura de mensagens
A leitura de mensagens apresenta complexidades adicionais que precisam ser discutidas. Ao contrário da API JMS, que pode iniciar um listener de mensagens em resposta à chegada de uma mensagem, a interface Consumer Kafka apenas faz polling. Vamos examinar mais de perto o método poll (), utilizado para esse propósito:
ConsumerRecords < K, V > poll(long timeout);O valor retornado pelo método é uma estrutura contendo vários objetos ConsumerRecord de potencialmente várias partições. ConsumerRecord Esse é um objeto que contém um par chave-valor com metadados correspondentes, como a partição de onde foi obtido.
Como discutido no Capítulo 2, devemos sempre ter em mente o que acontece com as mensagens após seu processamento bem-sucedido ou não, por exemplo, se o cliente não consegue processar a mensagem ou se ele falha. Na JMS, isso era tratado por meio do modo de reconhecimento (acknowledgement mode). O corretor pode remover a mensagem processada com sucesso ou reentregar a mensagem não processada ou falhada (desde que transações tenham sido utilizadas).
O Kafka funciona de maneira completamente diferente. As mensagens não são removidas no corretor após a leitura, e a responsabilidade pelo que acontece em caso de falha recai sobre o próprio código de leitura.
Como já mencionamos, um grupo de consumidores está associado a um deslocamento no log. A posição no log associada a esse deslocamento corresponde à próxima mensagem que será emitida em resposta a poll ()O momento em que esse deslocamento aumenta tem um significado crucial na leitura.
Voltando ao modelo de leitura discutido anteriormente, o processamento da mensagem consiste em três etapas:
- Extrair a mensagem para leitura.
- Processar a mensagem.
- Confirmar a mensagem.
O consumidor Kafka vem com a opção de configuração enable.auto.commit. Esta é uma configuração frequentemente utilizada como padrão, como é comum com configurações que contêm a palavra "auto".
Até o Kafka 0.10, o cliente que usava esse parâmetro enviava o deslocamento da última mensagem lida na próxima chamada poll () após o processamento. Isso significava que quaisquer mensagens que já tinham sido extraídas (fetched) poderiam ser processadas novamente, se o cliente já as tivesse processado, mas fosse inesperadamente encerrado antes da chamada poll (). Como o corretor não mantém nenhum estado sobre quantas vezes uma mensagem foi lida, o próximo consumidor que extrai essa mensagem não saberá que algo ruim aconteceu. Esse comportamento era pseudo-transacional. O deslocamento era confirmado apenas em caso de processamento bem-sucedido da mensagem, mas se o cliente parasse de funcionar, o corretor enviava a mesma mensagem a outro cliente. Esse comportamento se alinhava com a garantia de entrega de mensagens "pelo menos uma vez«.
No Kafka 0.10, o código do cliente foi alterado de modo que o commit começasse a ser executado periodicamente pela biblioteca do cliente, de acordo com a configuração auto.commit.interval.ms. Esse comportamento está em algum lugar entre os modos JMS AUTO_ACKNOWLEDGE e DUPS_OK_ACKNOWLEDGE. Ao usar o auto commit, as mensagens podiam ser confirmadas independentemente de terem sido realmente processadas — isso poderia ocorrer no caso de um consumidor lento. Se o consumidor parasse de funcionar, as mensagens eram extraídas pelo próximo consumidor, começando pela posição confirmada, o que poderia levar à perda de mensagens. Nesse caso, o Kafka não perdia mensagens, o código de leitura simplesmente não as processava.
Este modo tem as mesmas perspectivas que na versão 0.9: as mensagens podem ser processadas, mas em caso de falha, o deslocamento pode não ser confirmado, o que pode potencialmente levar à duplicação da entrega. Quanto mais mensagens você extrai ao realizar poll (), maior é esse problema.
Como discutido na seção "Leitura de mensagens da fila" na página 21, não existe o conceito de entrega única de mensagens no sistema de troca de mensagens, considerando os modos de falha.
No Kafka, existem duas maneiras de confirmar (commitar) o offset: automaticamente e manualmente. Em ambos os casos, as mensagens podem ser processadas várias vezes, caso a mensagem tenha sido processada, mas uma falha ocorra antes do commit. Você também pode não processar a mensagem de forma alguma, se o commit ocorreu em segundo plano e seu código foi finalizado antes de começar a processá-la (possivelmente nas versões do Kafka 0.9 e anteriores).
Gerenciar o processo de commit de offset manualmente pode ser feito na API do consumidor Kafka, definindo o parâmetro enable.auto.commit como false e chamando explicitamente um dos seguintes métodos:
void commitSync();
void commitAsync();
Se você deseja processar uma mensagem "pelo menos uma vez", deve comitar o offset manualmente usando commitSync (), executando este comando imediatamente após o processamento das mensagens.
Esses métodos não permitem confirmar (acknowledge) mensagens até que elas sejam processadas, mas não fazem nada para eliminar a potencial duplicação de processamento, ao mesmo tempo que criam a aparência de transacionalidade. O Kafka não possui transações. O cliente não pode fazer o seguinte:
- Reverter automaticamente (roll back) uma mensagem com falha. Os consumidores devem tratar as exceções decorrentes de payloads problemáticos e falhas no backend, uma vez que não podem contar com a reentrega de mensagens pelo broker.
- Enviar mensagens para múltiplos tópicos como uma única operação atômica. Como veremos em breve, o controle sobre diversos tópicos e partições pode estar em diferentes máquinas no cluster Kafka, que não coordenam transações ao enviar. No momento da redação deste artigo, um trabalho considerável havia sido feito para tornar isso possível através do KIP-98.
- Vincular a leitura de uma mensagem de um tópico ao envio de outra mensagem para outro tópico. Novamente, a arquitetura do Kafka depende de várias máquinas independentes operando como um único barramento e não há tentativas de ocultar isso. Por exemplo, não existem componentes na API que permitam vincular Consumidor e Produtor na transação. No JMS isso é garantido pelo objeto Sessão, do qual são criados MessageProducers e MessageConsumers.
Se não podemos confiar em transações, como podemos garantir uma semântica mais próxima daquela fornecida por sistemas tradicionais de troca de mensagens?
Se houver a possibilidade de que o deslocamento do consumidor possa aumentar antes que a mensagem tenha sido processada, por exemplo, durante uma falha do consumidor, então o consumidor não tem como saber se seu grupo de consumidores perdeu mensagens quando recebeu a partição. Assim, uma das estratégias envolve retroceder (rewind) o deslocamento para a posição anterior. A API do consumidor Kafka fornece os seguintes métodos para isso:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Método seek () pode ser usado com o método
offsetsForTimes (Map timestampsToSearch) para retroceder a um estado em um momento específico no passado.
Implicitamente, usar essa abordagem significa que, provavelmente, algumas mensagens que foram processadas anteriormente serão lidas e processadas novamente. Para evitar isso, podemos usar leitura idempotente, conforme descrito no Capítulo 4, para acompanhar mensagens visualizadas anteriormente e excluir duplicatas.
Como alternativa, o código do seu consumidor pode ser simples, se a perda ou duplicação de mensagens for aceitável. Quando consideramos cenários de uso para os quais o Kafka é geralmente usado, como processamento de eventos de logs, métricas, rastreamento de cliques, etc., entendemos que a perda de mensagens individuais dificilmente terá um impacto significativo nas aplicações circundantes. Nesses casos, os valores padrão são bastante aceitáveis. Por outro lado, se seu aplicativo precisar transmitir pagamentos, você deve cuidar de cada mensagem individualmente. Tudo se resume ao contexto.
Observações pessoais mostram que, à medida que a intensidade das mensagens aumenta, o valor de cada mensagem individual diminui. Mensagens de alto volume se tornam, geralmente, valiosas se consideradas em uma forma agregada.
Alta Disponibilidade (High Availability)
A abordagem do Kafka em relação à alta disponibilidade difere substancialmente da abordagem do ActiveMQ. O Kafka foi projetado com base em clusters horizontalmente escaláveis, onde todas as instâncias do broker aceitam e distribuem mensagens simultaneamente.
Um cluster Kafka é composto por várias instâncias de brokers que operam em servidores diferentes. O Kafka foi desenvolvido para funcionar em hardware autônomo comum, onde cada nó tem seu próprio armazenamento dedicado. O uso de armazenamento em rede (SAN) não é recomendado, uma vez que múltiplos nós de computação podem competir por janelas de tempodearmazenamento e criar conflitos.
Kafka é uma sistema sempre ativo. Muitos grandes usuários do Kafka nunca desativam seus clusters, e o software sempre realiza atualizações através de reinicializações sequenciais. Isso é alcançado garantindo a compatibilidade com versões anteriores para mensagens e interações entre brokers.
Os brokers estão conectados ao cluster de servidores , que atua como um registro de dados de configuração e é usado para coordenar os papéis de cada broker. O ZooKeeper é, por si só, um sistema distribuído que fornece alta disponibilidade através da replicação de informações estabelecendo um quórum..
No caso básico, um tópico é criado no cluster Kafka com as seguintes propriedades:
- Número de partições. Como discutido anteriormente, o valor exato utilizado aqui depende do nível desejado de leitura paralela.
- O fator de replicação determina quantas instâncias de brokers no cluster devem conter logs para essa partição.
Usando o ZooKeeper para coordenação, o Kafka tenta distribuir novas partições de forma justa entre os brokers no cluster. Isso é feito por uma instância que atua como Controlador.
Em tempo de execução, para cada partição do tópico, Controlador atribui ao broker papéis de líder (líder, master) e seguidores. (seguidores, escravos, subordinados). O broker que atua como líder para essa partição é responsável por receber todas as mensagens enviadas a ele pelos produtores e espalhar as mensagens para os consumidores. Ao enviar mensagens para a partição do tópico, elas são replicadas em todos os nós do broker que atuam como seguidores dessa partição. Cada nó que contém logs para a partição é chamado de réplica. O broker pode atuar como líder para algumas partições e como seguidor para outras.
O seguidor que contém todas as mensagens armazenadas no líder é chamado de réplica sincronizada (réplica que está em estado sincronizado, in-sync replica). Se o broker que atua como líder para a partição falha, qualquer broker que esteja em um estado atualizado ou sincronizado para essa partição pode assumir o papel de líder. Este é um design incrivelmente resiliente.
Parte da configuração do produtor é o parâmetro acks, que determina quantas réplicas devem confirmar (acknowledge) o recebimento da mensagem antes que o fluxo do aplicativo continue o envio: 0, 1 ou todos. Se o valor allfor especificado, ao receber a mensagem, o líder enviará uma confirmação (confirmation) de volta ao produtor assim que receber confirmações (acknowledgements) da gravação de várias réplicas (incluindo a si mesmo), conforme definido pela configuração do tópico min.insync.replicas (padrão 1). Se a mensagem não puder ser replicada com sucesso, o produtor lançará uma exceção para o aplicativo (NotEnoughReplicas ou NotEnoughReplicasAfterAppend).
Em uma configuração típica, um tópico é criado com um fator de replicação de 3 (1 líder, 2 seguidores para cada partição) e o parâmetro min.insync.replicas é definido como 2. Nesse caso, o cluster permitirá que um dos brokers que gerenciam a partição do tópico possa falhar sem afetar os aplicativos clientes.
Isso nos traz de volta ao compromisso familiar entre desempenho e confiabilidade. A replicação ocorre devido ao tempo adicional necessário para receber confirmações (acknowledgments) dos seguidores. No entanto, como acontece em paralelo, a replicação, pelo menos em três nós, tem o mesmo desempenho que em dois (ignorando o aumento do uso da largura de banda da rede).
Usando este esquema de replicação, o Kafka habilmente evita a necessidade de garantir a gravação física de cada mensagem no disco através da operação sync (). Cada mensagem enviada pelo produtor será gravada no log da partição, mas, como discutido no Capítulo 2, a gravação no arquivo é inicialmente feita no buffer do sistema operacional. Se essa mensagem for replicada em outra instância do Kafka e estiver em sua memória, a perda do líder não significa que a própria mensagem foi perdida — ela pode ser assumida por uma réplica sincronizada.
Abandonar a necessidade de realizar a operação sync () significa que o Kafka pode aceitar mensagens na velocidade com que pode gravá-las na memória. E, inversamente, quanto mais tempo puder evitar o descarregamento (flushing) da memória no disco, melhor. Por esse motivo, não é incomum que os corretores Kafka sejam alocados com 64 GB de memória ou mais. Esse uso de memória significa que uma instância do Kafka pode operar facilmente em velocidades milhares de vezes mais rápidas do que um corretor de mensagens tradicional.
O Kafka também pode ser configurado para aplicar a operação sync () em pacotes de mensagens. Como tudo no Kafka é orientado a trabalhar com pacotes, isso realmente funciona bastante bem para muitos cenários de uso e é uma ferramenta útil para os usuários que requerem garantias muito fortes. Grande parte do desempenho puro do Kafka está relacionada às mensagens que são enviadas ao corretor em forma de pacotes e ao fato de que essas mensagens são lidas do corretor em blocos consecutivos usando operações (com operações nas quais não há execução da tarefa de copiar dados de uma área de memória para outra). O último é um grande ganho em termos de desempenho e recursos e é possível apenas graças ao uso da estrutura de dados subjacente do log, que define o esquema de partição.
Em um cluster Kafka, é possível obter uma performance muito maior do que ao usar um único broker Kafka, pois as partições do tópico podem ser escaladas horizontalmente em várias máquinas distintas.
Resultados
Neste capítulo, examinamos como a arquitetura do Kafka recontextualiza as relações entre clientes e brokers para proporcionar um pipeline de troca de mensagens incrivelmente robusto, com uma capacidade muito maior do que a de um broker de mensagens comum. Discutimos a funcionalidade que ela utiliza para alcançar esse objetivo e revisamos brevemente a arquitetura das aplicações que fornecem essa funcionalidade. No próximo capítulo, abordaremos os problemas comuns que precisam ser resolvidos pelas aplicações baseadas em troca de mensagens e discutiremos estratégias para sua resolução. Encerramos o capítulo delineando como pensar sobre tecnologias de troca de mensagens em geral, para que você possa avaliar sua adequação para seus cenários de uso.
Parte anterior traduzida:
Tradução realizada:
Continua…
Apenas usuários registrados podem participar da pesquisa. , por favor.
O Kafka é usado em sua organização?
Sim
Não
Era usado, mas não é mais
Planejamos usar
38 usuários votaram. 8 usuários se abstiveram.
Fonte: habr.com
