

Uma excelente sexta-feira a todos! Cada vez menos tempo resta até o lançamento do curso , portanto hoje compartilhamos a tradução de mais um material útil sobre o tema.
No processo de desenvolvimento foi realizado um trabalho impressionante para melhorar o particionamento de tabelas. Particionamento de tabelas — é uma função que existia no PostgreSQL há bastante tempo, mas que, por assim dizer, na prática não existia até a versão 10, onde se tornou uma função bastante útil. Anteriormente, afirmamos que a herança de tabelas é nossa implementação de particionamento, e isso é verdade. Somente esse método obrigava você a fazer a maior parte do trabalho manualmente. Por exemplo, se você quisesse que os tuplos fossem inseridos nas seções durante os INSERTs, precisaria configurar gatilhos para fazer isso por você. O particionamento usando herança era muito lento e difícil de desenvolver funcionalidades adicionais sobre ele.
No PostgreSQL 10, vimos o nascimento do "particionamento declarativo" — um recurso projetado para resolver muitos problemas que eram irresolvíveis ao usar o antigo método de herança. Isso levou ao surgimento de uma ferramenta muito mais poderosa, permitindo-nos dividir dados horizontalmente!
Comparação de recursos
No PostgreSQL 11, apareceu um conjunto impressionante de novos recursos que ajudam a aumentar a performance e tornam as tabelas particionadas mais transparentes para as aplicações.
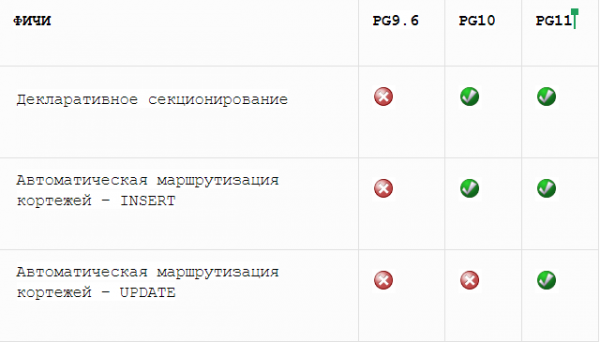
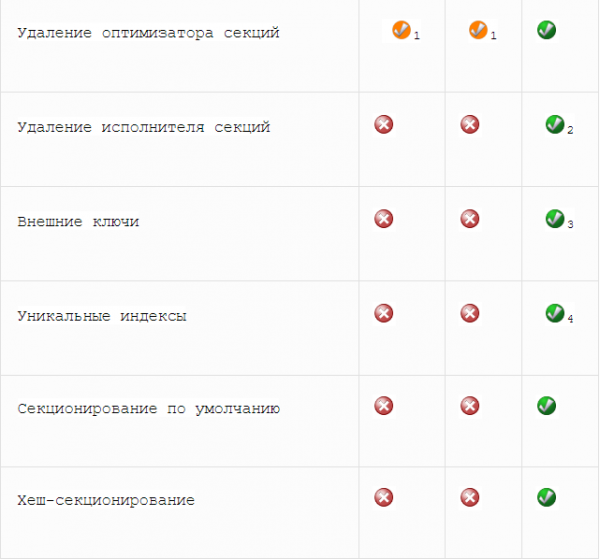
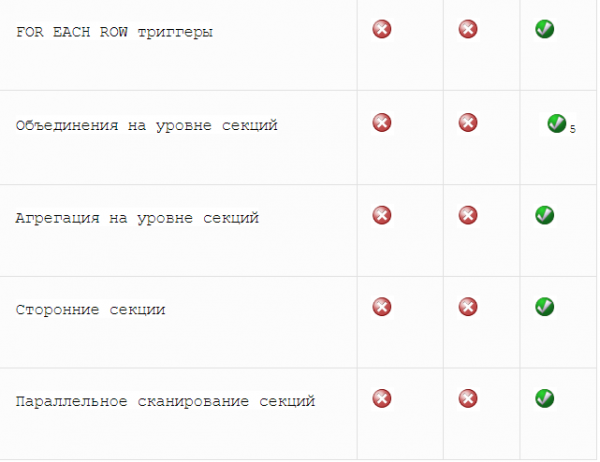
1. Uso de exceções restritivas
2. Adiciona apenas nós
3. Apenas para tabela particionada, referindo-se a não particionada
4. Índices devem conter todas as colunas-chave da seção
5. Restrições de seção em ambos os lados devem coincidir
Desempenho
Aqui também temos boas notícias! Um novo método foi adicionado . Este novo algoritmo pode determinar seções apropriadas examinando a condição da consulta WHERE. O algoritmo anterior, por outro lado, verificava cada seção para determinar se ela poderia atender à condição WHERE. Isso levava a um aumento adicional no tempo de planejamento à medida que o número de seções crescia.
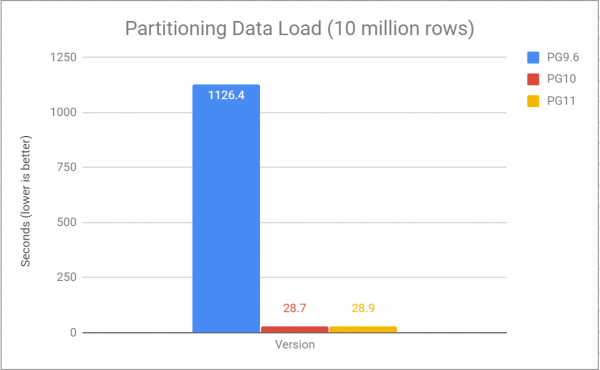
Na versão 9.6, com particionamento por herança, o roteamento de tuplas na seção geralmente era feito escrevendo uma função de gatilho que continha uma série de operadores IF para inserir a tupla na seção correta. Essas funções podiam ser muito lentas na execução. Com o particionamento declarativo adicionado na versão 10, isso passou a funcionar muito mais rápido.
Usando uma tabela particionada com 100 seções, podemos avaliar o desempenho de carregar 10 milhões de linhas em uma tabela com 1 coluna BIGINT e 5 colunas INT.
O desempenho da consulta a esta tabela para buscar um único registro indexado e executar DML para manipular um registro (usando apenas 1 processador):
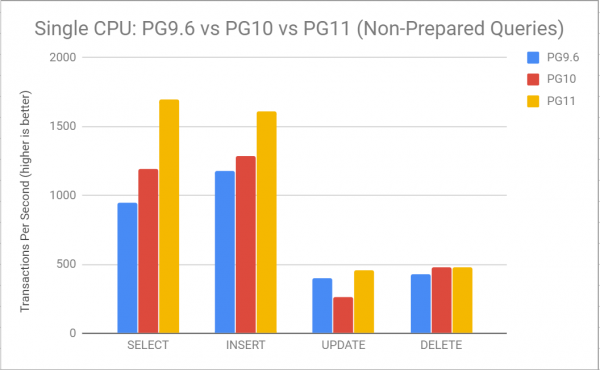
Aqui vemos que o desempenho de cada operação aumentou significativamente após o PG 9.6. As consultas SELECT parecem muito melhores, especialmente aquelas que conseguem excluir várias seções durante o planejamento das consultas. Isso significa que o planejador pode pular uma grande parte do trabalho que antes precisava realizar. Por exemplo, já não são mais construídos caminhos para seções desnecessárias.
Conclusão
O particionamento de tabelas começa a se tornar uma funcionalidade muito poderosa no PostgreSQL. Isso permite que os dados sejam rapidamente exportados para online e transferidos para offline, sem esperar a conclusão de operações DML massivas e lentas.Isso também significa que os dados relacionados podem ser armazenados juntos, ou seja, os dados necessários podem ser acessados de forma muito mais eficiente. As melhorias feitas nesta versão seriam impossíveis sem os desenvolvedores, revisores e commiters que trabalharam incansavelmente em todos esses recursos.
Obrigado a todos eles! PostgreSQL 11 parece simplesmente fantástico!
Aqui está um artigo curto, mas bastante interessante. Compartilhem seus comentários e não se esqueçam de se inscrever no , onde o cronograma do curso será detalhado.
Fonte: habr.com
