

Hoje não teremos casos complexos ou algoritmos complicados em SQL. Tudo será muito simples, no nível do Capitão Obvio — vamos fazer a visualização do registro de eventos com classificação por tempo.
Ou seja, temos uma tabela no banco de dados events, e ela possui um campo ts — exatamente o tempo pelo qual queremos exibir esses registros de forma ordenada:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
É claro que teremos mais do que algumas dezenas de registros, então precisaremos de alguma forma de navegação paginada.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
É quase uma piada — raro, mas acontece na natureza. Às vezes, após trabalhar com ORM, pode ser difícil se readaptar para o trabalho 'direto' com SQL.
Mas vamos passar para problemas mais comuns e menos óbvios.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - registros por página, $1 - começo da página
De onde vem o número 26? É a quantidade aproximada de registros para preencher uma tela. Na verdade, 25 registros exibidos, mais 1, sinalizando que há mais algo na seleção e que vale a pena continuar.
Claro, esse valor pode não ser 'incorporado' no corpo da consulta, mas passado como parâmetro. Mas nesse caso, o planejador do PostgreSQL não poderá se apoiar no conhecimento de que os registros devem ser relativamente poucos, e facilmente escolherá um plano ineficiente.
E enquanto na interface do aplicativo a visualização do registro for realizada como uma alternância entre 'páginas' visuais, ninguém nota nada suspeito por muito tempo. Justamente até o momento em que, em nome da conveniência do UI/UX, decidem refazer a interface para um 'scroll infinito' — ou seja, todos os registros do log são apresentados em uma única lista que o usuário pode rolar para cima e para baixo.
E assim, em um novo teste, você é pego por duplicação de registros no log. Por que isso acontece, se a tabela possui um índice normal (ts), no qual sua consulta se baseia?
Exatamente porque você não considerou que ts não é uma chave única nesta tabela. Na verdade, os valores também não são únicos, como em qualquer "tempo" em condições reais — portanto, o mesmo registro em duas consultas adjacentes facilmente "salta" de página para página devido a uma outra ordem final dentro da classificação de um valor de chave igual.
Na verdade, existe um segundo problema oculto, que é muito mais difícil de notar — alguns registros não serão exibidos de forma alguma! Afinal, os registros "duplicados" ocuparam o lugar de alguém. Uma explicação detalhada com belas ilustrações pode ser .
Expandindo o índice
O desenvolvedor astuto entende — é preciso tornar a chave do índice única, e a maneira mais simples é expandi-la com um campo que já é único, e o PK se encaixa perfeitamente:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);E a consulta se transforma:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Algum tempo depois, um DBA vem até você e "alegra" dizendo que suas consultas , e, aliás, já está na hora de mudar para navegação a partir do último valor exibido. Sua consulta se transforma novamente:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- últimos valores recebidos na etapa anterior
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Você suspirou aliviado, até que aconteceu...
#3. Чистка индексов
Porque um dia, seu DBA leu e percebeu que "timestamp não final" — isso não é bom. E novamente ele veio até você — agora com a ideia de que aquele índice deve, de fato, voltar a ser (ts DESC).
Mas o que fazer com o problema original de "pular" registros entre as páginas?... Simples — precisamos escolher blocos com um número variável de registros!
Na verdade, quem nos proíbe de ler não "exatamente 26", mas "pelo menos 26"? Por exemplo, de modo que no próximo bloco apareçam registros com valores deliberadamente diferentes ts — assim, não haverá problemas de "saltar" registros entre os blocos!
Veja como conseguir isso:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
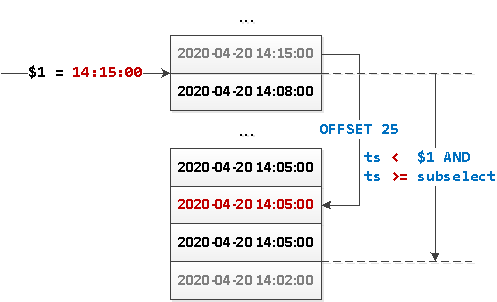
O que está acontecendo aqui?
- Avançamos 25 registros "para baixo" e obtemos o valor "limite"
ts. - Se não há nada lá, substituímos o valor NULL por
-infinity. - Subtraímos todo o segmento de valores entre o valor recebido
tse o parâmetro $1 (o "último" valor desenhado anteriormente). - Se o bloco retornou menos de 26 registros - é o último.
Ou a mesma coisa em imagem:
Agora que temos a amostra não possui um "início" definido, nada nos impede de "desdobrar" essa consulta ao contrário e implementar o carregamento dinâmico de blocos de dados a partir do "ponto de referência" em ambas as direções - tanto para baixo quanto para cima.
Observação
- Sim, nesse caso, consultamos o índice duas vezes, mas tudo "pelo índice". Portanto, a consulta aninhada resultará apenas em uma varredura adicional apenas do índice.
- É bastante óbvio que essa técnica só pode ser utilizada quando você tem valores
tsque podem se cruzar apenas aleatoriamente, e são poucos. Se seu caso típico é "um milhão de registros em 00:00:00.000", então não é o que você deve fazer. Quero dizer, não deve permitir esse caso. Mas se é assim que aconteceu, utilize a versão com índice expandido.
Fonte: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish