

Periodicamente, o desenvolvedor precisa enviar um conjunto de parâmetros ou até mesmo um conjunto completo como entrada. Às vezes, encontramos soluções muito estranhas para essa tarefa.
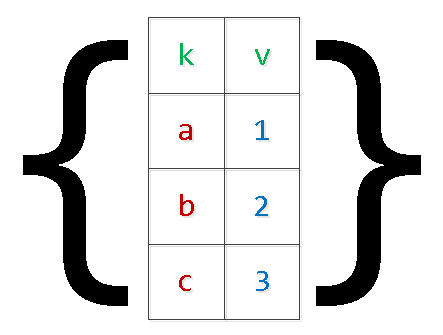
Vamos começar pelo oposto e ver como não se deve fazer, por quê e como podemos fazer melhor.
A inserção direta de valores no corpo da solicitação
normalmente se parece com isto:
query = "SELECT * FROM tbl WHERE id = " + value… ou assim:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Sobre esse método, já foi discutido, escrito e em abundância:
Quase sempre isso é um caminho direto para injeções SQL e carga desnecessária na lógica de negócios, que é forçada a "grudar" a string da sua solicitação.
Essa abordagem pode ser parcialmente justificada apenas no caso da necessidade de particionamento nas versões do PostgreSQL 10 e anteriores para obter um plano mais eficiente. Nesses versões, a lista de seções a serem examinadas é definida sem considerar os parâmetros passados, apenas com base no corpo da solicitação.
$n-argumentos
Uso de parâmetros - isso é bom, permitindo o uso de , reduzindo a carga tanto na lógica de negócios (a string da solicitação é formada e passada apenas uma vez), como no servidor de banco de dados (não é necessário reaprender ou planejar para cada instância da solicitação).
Número variável de argumentos
Os problemas nos aguardam quando tentamos passar um número de argumentos desconhecido previamente:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Se deixarmos a solicitação dessa forma, isso, embora nos proteja de potenciais injeções, ainda resultará na necessidade de concatenar/parsing da solicitação para cada variante em função do número de argumentos.. Já é melhor do que fazer isso a cada vez, mas podemos evitar isso.
Basta passar apenas um parâmetro contendo a representação serializada de um array:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'A única diferença é a necessidade de converter explicitamente o argumento para o tipo correto de array. Mas isso não causa problemas, uma vez que já sabemos para onde estamos nos dirigindo.
Passagem de uma seleção (matriz)
Normalmente, isso são vários métodos de transmissão de conjuntos de dados para inserir no banco "em uma única solicitação":
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Além dos problemas mencionados acima com a "recolagem" da solicitação, isso pode nos levar a out of memory e queda do servidor. A razão é simples — os argumentos PG reservam memória adicional, e o número de registros do conjunto é limitado apenas pelas necessidades da lógica de negócios. Em casos extremos, já vi argumentos "numéricos" acima de $9000 — não faça isso.
Vamos reescrever a consulta, aplicando já a "serialização em dois níveis":
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Sim, no caso de valores "complexos" dentro do array, eles precisam ser envoltos em aspas.
É claro que dessa forma é possível "expandir" a seleção com um número arbitrário de campos.
unnest, unnest, …
Periodicamente, encontramos variantes de passar em vez de "um array de arrays" vários "arrays de colunas", sobre os quais mencionei :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Com esse método, errando ao gerar listas de valores para diferentes colunas, é muito fácil obter resultados totalmente inesperados, dependendo também da versão do servidor:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Desde a versão 9.3, o PostgreSQL introduziu funções completas para trabalhar com o tipo json. Portanto, se a definição dos parâmetros de entrada ocorre no navegador, você pode gerar o objeto json para a consulta SQL diretamente lá:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Para versões anteriores, o mesmo método pode ser usado para each(hstore), mas a "compactação" correta com a escapagem de objetos complexos em hstore pode causar problemas.
json_populate_recordset
Se você sabe antecipadamente que os dados do "array json de entrada" serão usados para preencher uma tabela, é possível economizar bastante na "desreferenciação" dos campos e na conversão para os tipos necessários, usando a função json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
E essa função apenas "expandirá" o array de objetos passado na seleção, sem se basear no formato da tabela:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TABELA TEMPORÁRIA
Mas se o volume de dados na seleção passada for muito grande, enviar tudo em um único parâmetro serializado é difícil, e às vezes impossível, pois exige uma alocação única de um grande volume de memóriaPor exemplo, você pode precisar coletar por muito tempo um grande pacote de dados de eventos de um sistema externo e depois querer processá-lo de uma só vez no lado do banco de dados.
Neste caso, a melhor solução será utilizar :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- repetir muitas e muitas vezes
...
-- aqui fazemos algo útil com toda essa tabela de uma vez
Esse método é especialmente bom para a transmissão esporádica de grandes volumes de dados.
Do ponto de vista da descrição da estrutura dos seus dados, uma tabela temporária se distingue de uma "comum" apenas por um único atributo na tabela do sistema pg_class, e no pg_type, pg_depend, pg_attribute, pg_attrdef, … — na verdade, nada.
Por isso, em sistemas web com um grande número de conexões de curta duração, para cada uma delas essa tabela irá gerar novos registros do sistema a cada vez, que são excluídos com o fechamento da conexão com o banco de dados. Como resultado, o uso incontrolável de TEMP TABLE leva ao "inchaço" das tabelas no pg_catalog e à lentidão de muitas operações que as utilizam.
Claro, isso pode ser combatido com um processo periódico de VACUUM FULL nas tabelas do catálogo do sistema.
Variáveis de sessão
Suponhamos que o processamento de dados do caso anterior seja suficientemente complicado para uma única consulta SQL, mas queremos fazê-lo com frequência. Ou seja, queremos utilizar o processamento procedural em , mas usar a passagem de dados via tabelas temporárias seria muito oneroso.
Não conseguiremos usar parâmetros $n para passar para um bloco anônimo. Podemos resolver isso com variáveis de sessão e a função current_setting.
Até a versão 9.2, era necessário configurar previamente custom_variable_classes para variáveis de sessão "próprias". Nas versões atuais, podemos escrever algo assim:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
Em outras linguagens procedurais suportadas, pode-se encontrar outras soluções.
Você conhece outras formas? Compartilhe nos comentários!
Fonte: habr.com
