

Milhares de gerentes de vendas em todo o país registram em diariamente dezenas de milhares de contatos — casos de comunicação com potenciais ou já existentes clientes. E para encontrar esse cliente, é preciso primeiro localizá-lo, e preferencialmente muito rápido. Isso geralmente acontece através do nome.
Portanto, não é surpreendente que, ao analisar mais uma vez os 'pesos pesados' em uma das bases mais carregadas — a nossa própria , eu descobri que, no 'topo', a pesquisa para 'busca rápida' por nome para cartões de organizações.
Além disso, uma investigação mais aprofundada revelou um exemplo interessante de primeiro otimização e depois degradação do desempenho da solicitação durante seu aprimoramento sequencial por várias equipes, cada uma delas atuando exclusivamente com as melhores intenções.
0: o que o usuário realmente queria
 [KDPV ]
O que normalmente se entende por 'busca rápida' por nome? Quase nunca é uma 'busca honesta' por substring como ... LIKE '%rosa%' — pois assim, o resultado inclui não apenas 'Rosalía' e 'Loja Rosa', mas também 'Grrosa' e até mesmo 'Casa do Papai Noel Rosa'.
O usuário entende, em um nível prático, que você deve garantir a busca pelo início da palavra no título e apresentar com mais relevância aquilo que começa com o que foi digitado. E fazer isso praticamente em um instante — ao inserir a substring.
1: limitamos a tarefa
E muito menos alguém vai digitar intencionalmente 'rosa loja', para que cada palavra precise ser buscada com um prefixo. Não, é muito mais fácil para o usuário reagir a uma sugestão rápida para a última palavra do que intencionalmente não digitar as anteriores — veja como isso é feito por qualquer motor de busca.
De modo geral, armazenar corretamente formular os requisitos para a tarefa já é mais da metade da solução. Às vezes, uma análise cuidadosa do caso de uso .
O que faz um desenvolvedor abstrato?
1.0: mecanismo de busca externo
Oh, busca é complicado, não quero lidar com isso — vamos entregar isso ao devops! Que eles implementem para nós um sistema de busca relativamente externo ao banco de dados: Sphinx, ElasticSearch,…
Uma opção viável, embora trabalhosa em termos de sincronização e rapidez nas mudanças. Mas não é o nosso caso, já que a busca é realizada para cada cliente apenas dentro dos dados de sua conta. E os dados apresentam uma variabilidade bastante alta — e se agora o gerente registrou o cartão 'Loja Rosa', em 5-10 segundos ele já pode lembrar que esqueceu de incluir o email e querer encontrá-lo e corrigi-lo.
Portanto — vamos buscar "diretamente pela base". Felizmente, o PostgreSQL nos permite fazer isso, e não de uma única maneira — vamos examiná-las.
1.1: "substring" honesta
Ficamos com a palavra "substring". Justamente para a busca de índice por substring (e até mesmo por expressões regulares!) existe um excelente ! Mas depois teremos que classificar corretamente.
Vamos tentar usar um modelo tão simples quanto esta tabela:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Carregamos 7,8 milhões de registros de organizações reais e indexamos:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Vamos procurar as primeiras 10 entradas para a busca por substring:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'rosa')
ORDER BY
  lower(name) ~ ('^' || 'rosa') DESC -- primeiro os que "começam com"
, lower(name) -- o restante em ordem alfabética
LIMIT 10;
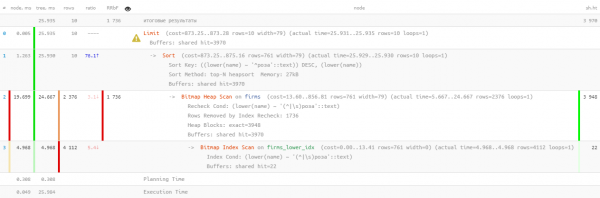
Bem, assim... 26ms, 31MB de dados lidos e mais de 1,7K de registros filtrados — para 10 buscados. Os custos operacionais são muito altos, não seria possível fazer isso de forma mais eficiente?
1.2: busca por texto? isso é FTS!
De fato, o PostgreSQL oferece um muito poderoso (Full Text Search), incluindo a possibilidade de busca por prefixo. Uma ótima opção, nem precisamos instalar extensões! Vamos tentar:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rosa:*')
ORDER BY
lower(name) ~ ('^' || 'rosa') DESC
, lower(name)
LIMIT 10; 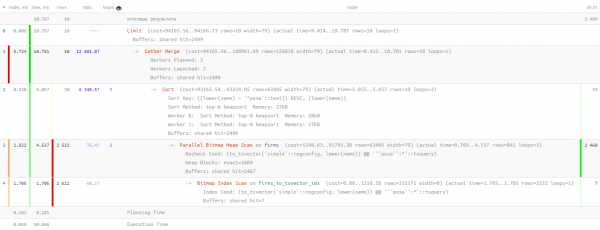
Aqui, a paralelização da execução da consulta nos ajudou um pouco, reduzindo o tempo pela metade para 11ms. E lemos 1,5 vezes menos — apenas 20MB. E quanto menor, melhor, pois quanto maior o volume que lemos, maiores as chances de ocorrer um cache miss, e cada página de dados lida a mais do disco é um potencial "atraso" para a consulta.
1.3: e se usássemos LIKE?
Todos esses pedidos anteriores são bons, mas se forem feitos cem mil vezes por dia, então já acumula 2TB dados lidos. No melhor cenário — da memória, mas se a sorte não estiver ao nosso lado, do disco. Então, vamos tentar torná-lo menor.
Lembre-se, o usuário deseja ver primeiro "que começam com...". Isso é claramente com text_pattern_ops! E só se não tivermos "suficiente" até 10 entradas buscadas, teremos que continuar a leitura usando a pesquisa FTS:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('rosa' || '%')
LIMIT 10; 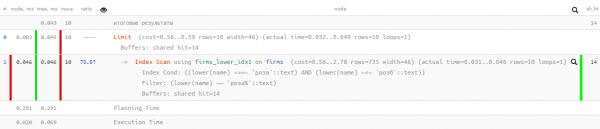
Ótimos resultados — apenas 0.05ms e um pouco mais de 100KB lidos! Mas esquecemos a ordenação pelo nome, para que o usuário não se perca nos resultados:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rosa' || '%')
ORDER BY
  lower(name)
LIMIT 10; 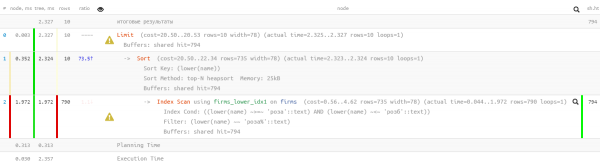
Oh, algo já não está tão bonito — parece que o índice existe, mas a ordenação ignora isso… É, com certeza, muito mais eficiente do que a versão anterior, mas…
1.4: "aperfeiçoar manualmente"
Mas há um índice que permite buscar também por intervalo e utilizar a ordenação corretamente — btree comum!
CREATE INDEX ON firms(lower(name));Apenas o SQL para isso terá que ser "montado manualmente":
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'rosa' AND
  lower(name) <= ('rosa' || chr(65535)) -- para UTF8, para codificações de byte único - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 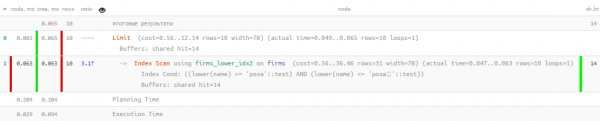
Ótimo — tanto a ordenação quanto o consumo de recursos continuaram "microscópicos", milhares de vezes mais eficiente do que o "FTS puro"! Resta juntar em uma única consulta:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'rosa' AND
    lower(name) <= ('rosa' || chr(65535)) -- para UTF8, para codificações de byte único - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rosa:*') AND
    lower(name) NOT LIKE ('rosa' || '%') -- "começando com" já encontramos acima
  ORDER BY
    lower(name) ~ ('^' || 'rosa') DESC -- usamos a mesma ordenação para NÃO seguir pelo índice btree
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Observe que a segunda subconsulta é executada somente se a primeira retornar menos do que o esperado número de linhas. Já escrevi sobre esse método de otimização de consultas LIMIT Pois é, agora temos na tabela tanto btree quanto gin, mas estatisticamente menos de 10% das consultas chegam a executar o segundo bloco. .
1.5*: vamos dispensar o manualmente Acima.
1.5*: vamos conseguir sem a lima
Acima LIKE tivemos dificuldades com a ordenação incorreta. Mas isso pode ser "ajustado" usando o operador USING:
Por padrão, pressupõe-se
ASC. Além disso, é possível especificar o nome de um operador de ordenação específico na cláusulaUSING. O operador de ordenação deve ser um membro do conjunto "menor que" ou "maior que" de uma família de operadores de B-tree.ASCnormalmente equivalente aUSING <eDESCnormalmente equivalente aUSING >.
No nosso caso, "menor que" é ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rosa' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 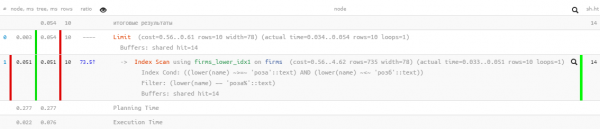
2: como os pedidos "azedam"
Agora, deixamos nosso pedido "macerar" por meio ano a um ano, e com surpresa descobrimos novamente que ele está "no topo" com índices de aumento total diário da memória (buffers shared hit) em 5.5TB — ou seja, ainda mais do que inicialmente.
Claro, nosso negócio cresceu, e a carga aumentou, mas não tanto assim! Isso significa que algo não está certo — vamos investigar.
2.1: o nascimento da paginação
Em algum momento, outra equipe de desenvolvedores quis possibilitar que, a partir de uma pesquisa instantânea, se "saltasse" para um registro com os mesmos dados, mas expandidos. E que registro não tem navegação paginada? Vamos implementar!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Agora era possível, sem esforço para o desenvolvedor, exibir o registro de resultados de pesquisa com carregamento "tipo-paginado".
Claro, na verdade, para cada próxima página de dados, lê-se cada vez mais (tudo do último vez, que vamos descartar, mais o necessário "triângulo") — ou seja, esse é um padrão claramente anti-padrão. E seria mais correto — iniciar a busca na próxima iteração a partir da chave armazenada na interface, mas sobre isso — numa próxima vez.
2.2: quero exóticas
Em algum momento, o desenvolvedor sentiu a necessidade de variar a seleção de resultados com dados de outra tabela, para isso todo o pedido anterior foi enviado para CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- algum pedido para a tabela relacionada
FROM
  q
LIMIT 10 OFFSET ;
E mesmo assim — não é ruim, pois a subconsulta é calculada apenas para os 10 registros retornados, se não fosse por...
2.3: DISTINCT sem sentido e impiedoso
Em algum ponto durante essa evolução, do 2° subpedido se perdeu NOT LIKE condição. É claro que após isso UNION ALL começou a retornar alguns registros duas vezes — primeiro encontramos pelo início das linhas, e depois novamente — pelo início da primeira palavra dessa linha. No limite, todas as entradas da segunda subconsulta poderiam coincidir com as entradas da primeira.
O que o desenvolvedor faz em vez de buscar a causa?.. Sem dúvida!
- dobramos o tamanho amostras de origem
- impondo DISTINCT, para que apenas ocorrências únicas de cada linha sejam retornadas
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Ou seja, é claro que o resultado, no final, é exatamente o mesmo, mas a chance de 'perder' na segunda subconsulta CTE aumentou consideravelmente, e mesmo assim, lê-se claramente mais.
Mas isso não é o maior problema. Como o desenvolvedor pediu para selecionar DISTINCT não por campos específicos, mas por todos os campos simultaneamente as entradas, isso automaticamente incluiu o campo sub_query — o resultado da subconsulta. Agora, para realizar DISTINCT, o banco teve que executar não 10 subconsultas, mas todas + 10!
2.4: cooperação acima de tudo!
Era assim que os desenvolvedores viviam — despreocupados, porque no registro 'ajustar' para valores significativos de N durante a desaceleração crônica da obtenção de cada próxima 'página' claramente não tinha paciência suficiente.
Até que desenvolvedores de outro departamento chegaram e quiseram aproveitar um método tão conveniente para busca iterativa — ou seja, pegamos um pedaço de alguma amostra, filtramos por condições adicionais, mostramos o resultado, e depois o próximo pedaço (o que, em nosso caso, é alcançado aumentando N), e assim até preencher a tela.
Em resumo, no exemplo capturado N atingiu quase 17K, e ao longo de um dia foram executadas 'em cadeia' não menos que 4K dessas consultas. As últimas delas escaneavam corajosamente já por 1GB de memória em cada iteração…
Total
Fonte: habr.com
