

As características do funcionamento dos mecanismos internos do PostgreSQL permitem que ele seja muito rápido em algumas situações e "não muito" em outras. Hoje, vamos parar em um exemplo clássico de conflito entre como o SGBD funciona e o que o desenvolvedor faz com ele — UPDATE vs princípios MVCC.
Resumidamente, a trama é :
Quando uma linha é modificada pelo comando UPDATE, na verdade, duas operações são realizadas: DELETE e INSERT. Na versão atual da linha é definido xmax, igual ao número da transação que executou o UPDATE. Em seguida, é criado uma nova versão da mesma linha; o valor xmin coincide com o valor xmax da versão anterior.
Depois de algum tempo, após a conclusão dessa transação, a versão antiga ou nova, dependendo de COMMIT/ROLLBACK, será considerada "morta" (dead tuples) ao percorrer VACUUM a tabela e será removida.
Mas isso não acontecerá imediatamente; problemas com "mortos" podem surgir muito rapidamente — ao realizar atualizações múltiplas ou em uma grande tabela, e logo depois você poderá se deparar com a situação de que nem .
#1: I Like To Move It
Suponha que seu método de lógica de negócios funcione e, de repente, você percebe que seria necessário atualizar o campo X em algum registro:
UPDATE tbl SET X = WHERE pk = $1;Depois, durante a execução, descobre que o campo Y também precisa ser atualizado:
UPDATE tbl SET Y = WHERE pk = $1;… e depois Z — por que ser modesto?
UPDATE tbl SET Z = WHERE pk = $1;Quantas versões deste registro temos agora no banco? Ah, 4 delas! Das quais uma é atual, e 3 você terá que limpar com [auto]VACUUM.
Não faça isso! Use a atualização de todos os campos em uma única consulta — quase sempre é possível mudar a lógica do método assim:
UPDATE tbl SET X = , Y = , Z = WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Então, você realmente quis (durante a execução de um script ou conversor, por exemplo). E no script vem algo assim:
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2;Esse tipo de consulta aparece com frequência e quase sempre não é para preencher um novo campo vazio, mas para corrigir algum erro nos dados. Ao mesmo tempo, a correção dos dados já existentes geralmente não é considerada — e isso é um erro! Ou seja, o registro é reescrevendo, mesmo que nele estivesse exatamente o que se queria — e por que fazer isso? Vamos corrigir:
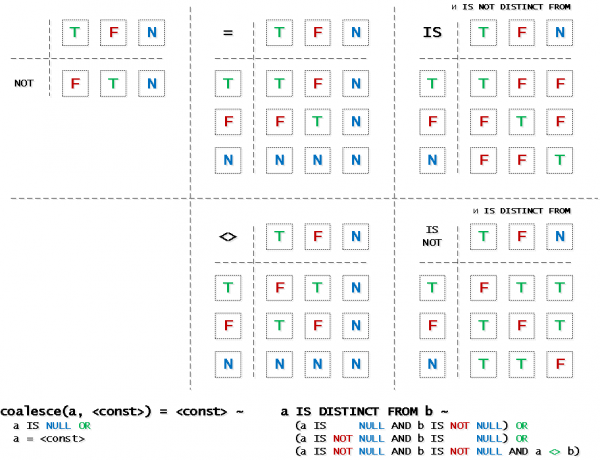
UPDATE tbl SET X = WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM ; Muitos não estão cientes da existência desse operador maravilhoso, então aqui está um guia sobre IS DISTINCT FROM e outros operadores lógicos para ajudar:
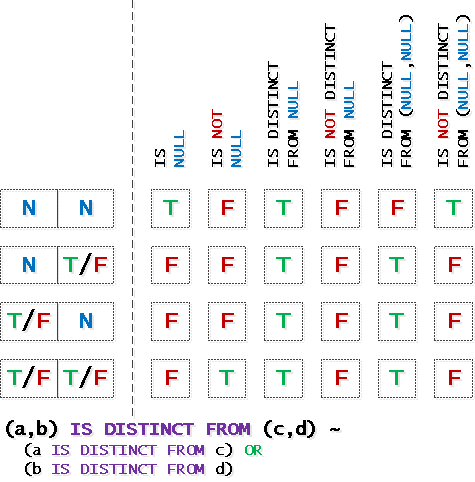
… e um pouco sobre operações com expressões complexas: ROW()-expressões:
#3: А я милого узнаю по… блокировке
São iniciados dois processos paralelos idênticos, cada um tentando marcar o registro como 'em trabalho':
UPDATE tbl SET processing = TRUE WHERE pk = $1;Mesmo que esses processos façam coisas independentes entre si, mas dentro de um mesmo ID, nesta consulta o segundo cliente 'será bloqueado' até que a primeira transação termine.
Solução nº 1: o problema é reduzido ao anterior
Simplesmente adicionaremos novamente IS DISTINCT FROM:
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE;Desta forma, a segunda consulta simplesmente não alterará nada no banco de dados, pois já 'está tudo certo' — portanto, a bloqueio não ocorrerá. Mais adiante, o fato de um registro 'não ser encontrado' já será tratado no algoritmo da aplicação.
Solução nº 2: advisory locks
Um grande tema para um artigo separado, onde você pode ler sobre .
Solução nº 3: chamadas sem [d] senso
Aqui deve ocorrer com certeza o trabalho simultâneo com o mesmo registro? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Fonte: habr.com
