

Tenha cuidado com operações, buffers que trazem...
Usaremos um exemplo de uma consulta simples para discutir algumas abordagens universais para otimização de consultas no PostgreSQL. Utilizá-las ou não é uma escolha sua, mas é bom conhecê-las.
Em versões posteriores do PG, a situação pode mudar com a 'inteligência' do planejador, mas para 9.4/9.6 parece mais ou menos a mesma, como os exemplos aqui.
Vou pegar uma consulta bastante realista:
SELECT
  TRUE
FROM
  "Documento" d
INNER JOIN
  "DocumentoExtensão" doc_ex
    USING("@Documento")
INNER JOIN
  "TipoDocumento" t_doc ON
    t_doc."@TipoDocumento" = d."TipoDocumento"
WHERE
  (d."Pessoa3" = 19091 or d."Funcionário" = 19091) AND
  d."$Rascunho" IS NULL AND
  d."Removido" IS NOT TRUE AND
  doc_ex."Estado"[1] IS TRUE AND
  t_doc."TipoDocumento" = 'PlanoDeTrabalho'
LIMIT 1;
sobre nomes de tabelas e camposOs nomes 'russos' dos campos e tabelas podem ser encarados de diferentes maneiras, mas isso é uma questão de gosto. Como estiverem entre aspas , preferimos nomear os objetos de forma clara e inequívoca, para evitar mal-entendidos., preferimos nomear os objetos de forma clara e inequívoca, para evitar ambiguidades.
Vamos olhar o plano resultante:
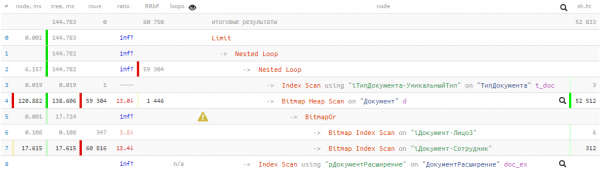
144ms e quase 53K buffers — ou seja, mais de 400MB de dados! E teremos sorte se todos eles estiverem em cache no momento de nossa consulta, caso contrário, ela ficará muito mais longa ao ser lida do disco.
O algoritmo é o mais importante!
Para otimizar qualquer consulta, é preciso primeiro entender o que ela realmente deve fazer.
Vamos deixar de lado por enquanto o desenvolvimento da própria estrutura do BD, e concordar que podemos "baratear" reescrever a consulta e/ou aplicar no banco alguns índices que precisamos necessários.
Então, a consulta:
— verifica a existência de pelo menos um documento
— no estado desejado e de um tipo específico
— onde o autor ou executor é o funcionário necessário
JOIN + LIMIT 1
Frequentemente, é mais fácil para o desenvolvedor escrever uma consulta que inicialmente junta uma grande quantidade de tabelas, e depois, de toda essa massa, sobra apenas um único registro. Mas mais fácil para o desenvolvedor não significa mais eficaz para o BD.
No nosso caso, havia apenas 3 tabelas — e que efeito…
Vamos primeiro eliminar a junção com a tabela "TipoDocumento", e já informamos ao banco que a tabela de tipos é única (nós sabemos disso, mas o planejador ainda não recebeu essa informação):
WITH T AS (
  SELECT
    "@TipoDocumento"
  FROM
    "TipoDocumento"
  WHERE
    "TipoDocumento" = 'PlanoDeTrabalho'
  LIMIT 1
)
...
WHERE
  d."TipoDocumento" = (TABLE T)
...
Sim, se a tabela/CTE consiste em um único campo de um único registro, no PG você pode fazer assim, ao invés.
d."TipoDocumento" = (SELECT "@TipoDocumento" FROM T LIMIT 1)Cálculos "preguiçosos" em consultas PostgreSQL
BitmapOr vs UNION
Em alguns casos, a varredura Bitmap Heap Scan pode ser muito custosa — por exemplo, na nossa situação, onde muitos registros se enquadram na condição exigida. Isso foi obtido devido a uma condição OR que se transformou em BitmapOroperação no plano.
Retornemos ao problema original — precisamos encontrar um registro correspondente a qualquer uma das condições — ou seja, não há necessidade de buscar todos os 59K registros em ambas as condições. Existe uma forma de lidar com uma condição, e passar para a segunda apenas quando nada for encontrado na primeira.A estrutura que nos ajudará será:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
"O LIMIT 1 externo garante que a busca será encerrada ao encontrar o primeiro registro. E se ele for encontrado já no primeiro bloco, a execução do segundo não acontecerá (nunca executado no plano).
"Escondendo sob CASE" condições complexas
Na consulta original, há um ponto extremamente inconveniente — a verificação do estado na tabela relacionada "DocumentoExtensão". Independentemente da veracidade das outras condições na expressão (por exemplo, d."Removido" IS NOT TRUE), essa junção é sempre realizada e "consome recursos". Mais ou menos recursos serão gastos — depende do volume dessa tabela.
Mas podemos modificar a consulta para que a busca do registro relacionado ocorra apenas quando realmente necessário:
SELECT
  ...
FROM
  "Documento" d
WHERE
  ... /*index cond*/ AND
  CASE
    WHEN "$Rascunho" IS NULL AND "Removido" IS NOT TRUE THEN (
      SELECT
        "Estado"[1] IS TRUE
      FROM
        "DocumentoExtensão"
      WHERE
        "@Documento" = d."@Documento"
    )
  END
Uma vez que não precisamos de nenhum dos campos da tabela vinculada para o resultado, podemos transformar o JOIN em uma condição através da subconsulta.Deixamos os campos indexáveis "fora das chaves" CASE, e as condições simples do registro são inseridas no bloco WHEN — e agora a consulta "pesada" é executada apenas ao entrar no THEN.
Meu sobrenome é "Total"
Montamos a consulta resultante com todas as mecânicas descritas acima:
Estamos reunindo a consulta resultante com todas as mecânicas descritas acima:
COM T COMO (
  SELECIONE
    "@TipoDocumento"
  DE
    "TipoDocumento"
  ONDE
    "TipoDocumento" = 'PlanoTrabalho'
)
  (
    SELECIONE
      VERDADEIRO
    DE
      "Documento" d
    ONDE
      ("Pessoa3", "TipoDocumento") = (19091, (TABELA T)) E
      CASO
        QUANDO "$Rascunho" É NULO E "Removido" NÃO É VERDADEIRO ENTÃO (
          SELECIONE
            "Estado"[1] É VERDADEIRO
          DE
            "DocumentoExtensao"
          ONDE
            "@Documento" = d."@Documento"
        )
      FIM
    LIMITAR 1
  )
UNION ALL
  (
    SELECIONE
      VERDADEIRO
    DE
      "Documento" d
    ONDE
      ("TipoDocumento", "Funcionário") = ((TABELA T), 19091) E
      CASO
        QUANDO "$Rascunho" É NULO E "Removido" NÃO É VERDADEIRO ENTÃO (
          SELECIONE
            "Estado"[1] É VERDADEIRO
          DE
            "DocumentoExtensao"
          ONDE
            "@Documento" = d."@Documento"
        )
      FIM
    LIMITAR 1
  )
LIMITAR 1;
Ajustando [para] os índices
Um olhar atento percebeu que as condições indexadas nos subblocos UNION variam um pouco — isso porque já temos índices apropriados na tabela. E se não os tivermos — seria necessário criá-los: Documento(Pessoa3, TipoDocumento) e Documento(TipoDocumento, Funcionário).
sobre a ordem dos campos nas condições ROWDo ponto de vista do planejador, claro, pode-se escrever também (A, B) = (constA, constB), quanto (B, A) = (constB, constA). Mas ao escrever na ordem dos campos no índice, essa consulta simplesmente é mais fácil de depurar depois.
O que está no plano?
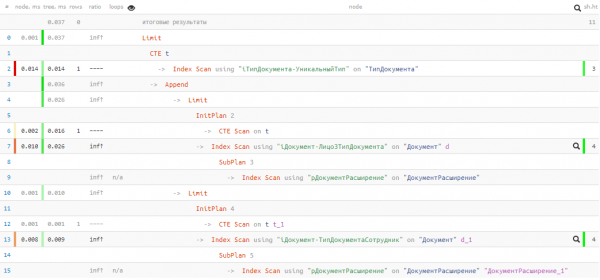
Infelizmente, não tivemos sorte, e nada foi encontrado no primeiro bloco UNION, então o segundo realmente foi executado. Mas mesmo assim — apenas 0.037ms e 11 buffers!
Aceleramos a consulta e reduzimos a "transferência" de dados na memória milhares de vezes, utilizando técnicas bastante simples — um bom resultado com um pouco de cópia e colagem. 🙂
Fonte: habr.com
