

Gostaria de apresentar a transcrição da palestra de início de 2016 de Vladimir Sitnikov "PostgreSQL e JDBC extraindo todos os sucos"
Bom dia! Meu nome é Vladimir Sitnikov. Trabalho há 10 anos na empresa NetCracker. E, principalmente, me concentro em desempenho. Tudo o que está relacionado a Java, tudo o que diz respeito a SQL – é o que eu amo.
E hoje eu vou falar sobre o que encontramos na empresa quando começamos a usar o PostgreSQL como servidor de banco de dados. E nós trabalhamos principalmente com Java. Mas o que vou falar hoje não está apenas relacionado ao Java. Como a prática mostrou, isso ocorre em outras linguagens também.
Vamos discutir:
- sobre a seleção de dados.
- Sobre a gravação de dados.
- E também sobre desempenho.
- E sobre obstáculos ocultos que estão embutidos.
Vamos começar com uma pergunta simples. Selecionamos uma linha da tabela pela chave primária.
O banco de dados está no mesmo host. E todo esse processo leva 20 milissegundos.
Esses 20 milissegundos são muito. Se você tiver 100 dessas solicitações, você está gastando tempo em segundos para processar essas solicitações, ou seja, estamos desperdiçando tempo desnecessariamente.
Nós não gostamos de fazer isso e estamos verificando o que o banco de dados nos oferece para isso. O banco de dados nos propõe duas opções para a execução das consultas.
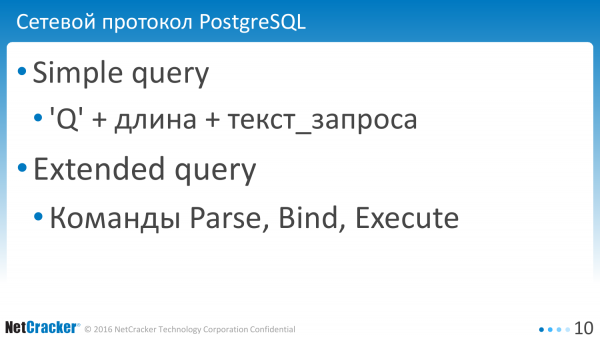
A primeira opção é uma consulta simples. O que é bom nisso? O fato de que a pegamos e enviamos, e nada mais.
O banco de dados também tem uma consulta expandida, que é mais astuta, mas mais funcional. Você pode enviar separadamente uma consulta para análise, execução, ligação de variáveis, etc.
A super consulta expandida – isso é algo que não iremos cobrir na apresentação atual. Podemos ter algumas necessidades em relação ao banco de dados e há essa lista de desejos, que foi formada de alguma maneira, ou seja, isso é o que queremos, mas não é possível agora e no próximo ano. Portanto, apenas registramos e iremos procurar as pessoas principais.
Quanto ao que podemos fazer, são a consulta simples e a consulta expandida.
Qual é a particularidade de cada abordagem?
A consulta simples é boa para uma execução única. Executou uma vez e esqueceu. E o problema é que ela não suporta o formato binário de dados, ou seja, para alguns sistemas de alto desempenho, ela não é adequada.
A consulta estendida – permite economizar tempo na análise. Isso é o que fizemos e começamos a usar. Isso nos ajudou imensamente. Não há apenas economia na análise. Há também economia na transmissão de dados. Transmitir dados em formato binário é muito mais eficiente.
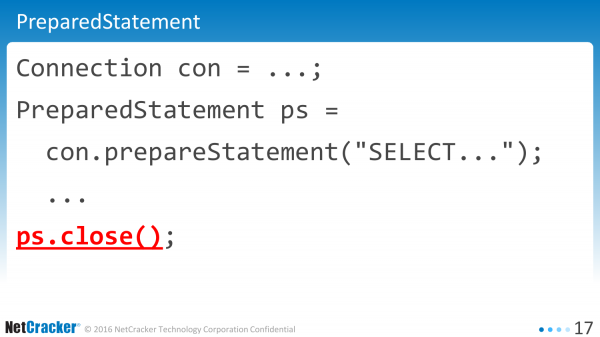
Vamos à prática. Veja como é um aplicativo típico. Pode ser Java, etc.
Criamos um statement. Executamos o comando. Criamos um close. Onde está o erro aqui? Qual é o problema? Não há problemas. Assim é escrito em todos os livros. É assim que deve ser. Se você quer a máxima performance, escreva assim.
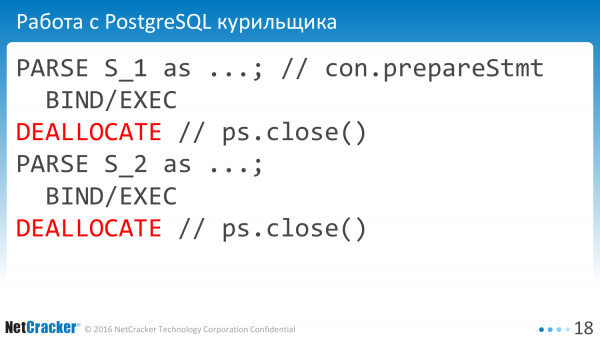
Mas a prática mostrou que isso não funciona. Por quê? Porque temos o método "close". E quando fazemos isso, do ponto de vista do banco de dados, é como se um fumante estivesse trabalhando com o banco de dados. Dizemos "PARSE EXECUTE DEALLOCATE".
Por que essas criações desnecessárias e descarte de statements? Elas não são necessárias. Mas geralmente em PreparedStatement acontece isso; quando os fechamos, eles fecham tudo no banco de dados. Isso não é o que queremos.
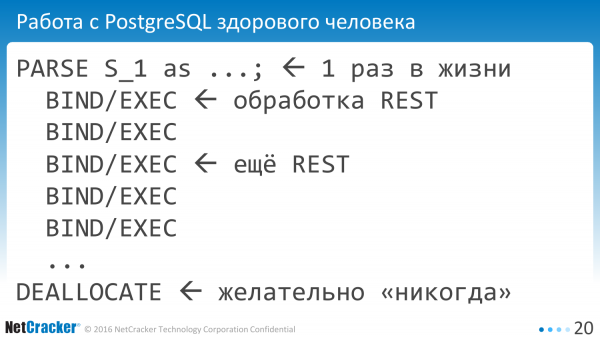
Queremos, como pessoas saudáveis, trabalhar com o banco. Preparamos nosso statement uma vez e depois o executamos muitas vezes. Na verdade, muitas vezes significa uma vez durante toda a vida do aplicativo. E em diferentes REST usamos o mesmo id de statement. Esse é o nosso objetivo.
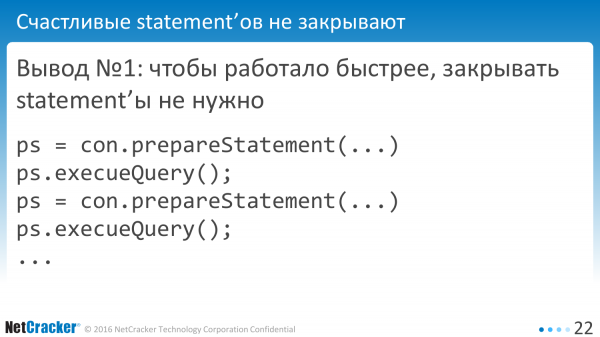
Como podemos alcançar isso?
Muito simples – não precisamos fechar statements. Escrevemos assim: "prepare" "execute".
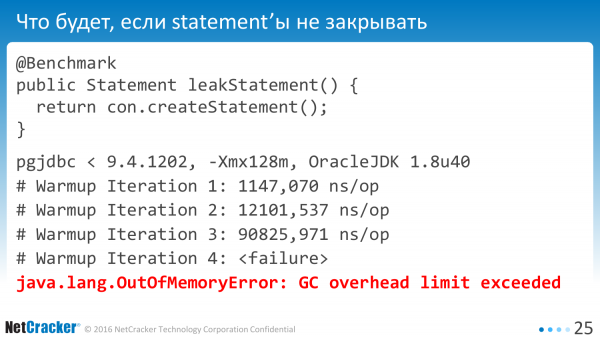
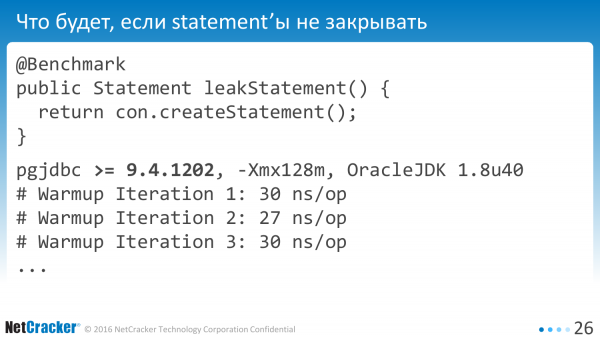
Se iniciarmos isso, é claro que algo irá transbordar em algum lugar. Se não for claro, podemos medir. Vamos escrever um benchmark, no qual teremos um método simples. Criamos um statement. Executamos em alguma versão do driver e descobrimos que ele cai rapidamente, com perda total da memória que temos disponíveis.
É claro que esses erros são fáceis de corrigir. Não vou falar sobre eles. Mas posso dizer que na nova versão funciona muito mais rápido. O método é sem objetivo, mas mesmo assim.
Como trabalhar corretamente? O que precisamos fazer para isso?
Na realidade, os aplicativos sempre fecham os statements. Todos os livros escrevem para fechá-los, caso contrário haverá vazamento de memória.
E o PostgreSQL não sabe armazenar em cache as consultas. Cada sessão precisa criar seu próprio cache.
E também não queremos gastar tempo na análise.
E como sempre temos duas opções.
A primeira opção é pegarmos e dizermos que vamos compactar tudo em PgSQL. Lá há cache. Ele cacheia tudo. Ficará maravilhoso. Observamos isso. Temos 100500 consultas. Não funciona. Não concordamos em transformar as consultas manualmente em procedimentos. Não, não.
Temos uma segunda opção – pegar e fazemos nós mesmos. Abrimos o código fonte e começamos a trabalhar. Trabalhamos, trabalhamos. Descobrimos que não é tão difícil assim.
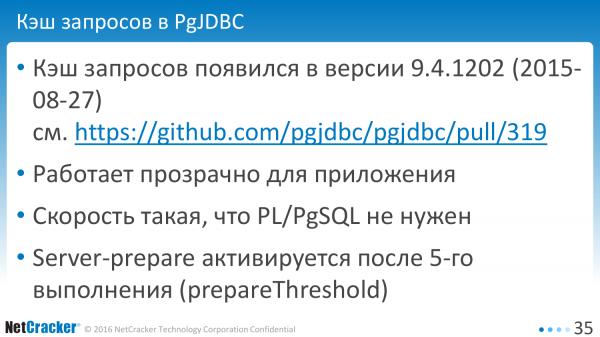
Isso apareceu em agosto de 2015. Agora temos uma versão mais moderna. E tudo está ótimo. Funciona tão bem que não mudamos nada no aplicativo. E até paramos de considerar o PgSQL, ou seja, nos serviu o suficiente para reduzir praticamente a zero todas as despesas gerais.
Assim, as instruções preparadas pelo servidor são ativadas na quinta execução para não gastar memória no banco de dados com cada consulta única.
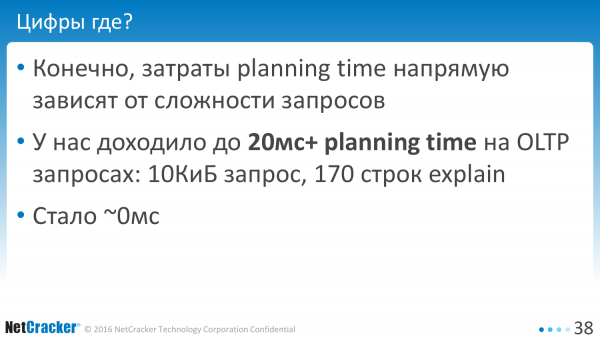
Pode-se perguntar – onde estão os números? O que você obtém? E aqui não fornecerei números, porque a cada consulta eles são diferentes.
Nossas consultas eram tais que gastávamos cerca de 20 milissegundos na análise em consultas OLTP. Ali havia 0,5 milissegundos na execução, 20 milissegundos na análise. A consulta – 10 KiB de texto, 170 linhas de plano. Esta é uma consulta OLTP. Ela solicita 1, 5, 10 linhas, às vezes mais.
Mas não queríamos gastar 20 milissegundos. Nós reduzimos isso a zero. Tudo ótimo.
O que você pode levar disso? Se você tem Java, então você pega a versão moderna do driver e fica feliz.
Se você tem alguma outra linguagem, então pense – talvez você também precise disso? Porque, do ponto de vista da linguagem final, por exemplo, se PL 8 ou você tem LibPQ, pode não ser óbvio que você está gastando tempo não na execução, mas na análise e isso vale a pena checar. Como? Tudo de graça.
Exceto que há erros, algumas particularidades. E sobre isso vamos falar agora. A maior parte será sobre arqueologia industrial, sobre o que encontramos, com o que nos deparamos.
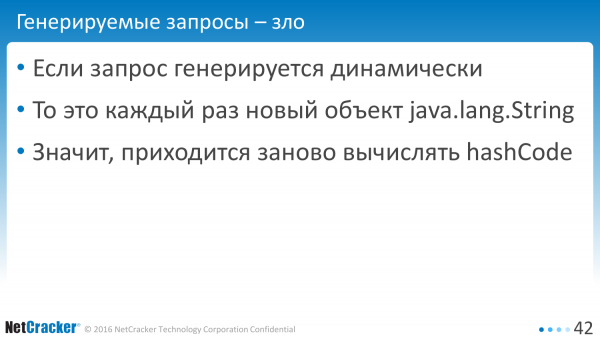
Se a consulta é gerada dinamicamente. Isso acontece. Alguém concatena strings, resultando em uma consulta SQL.
Por que isso é ruim? É ruim porque, a cada vez, acabamos com uma string diferente.
E esta linha variada precisa recalcular o hashCode. Esta é realmente uma tarefa de CPU – encontrar um longo texto de consulta mesmo em um hash existente não é tão simples. Portanto, a conclusão é clara – não gere consultas. Armazene-as em uma única variável. E aproveite.
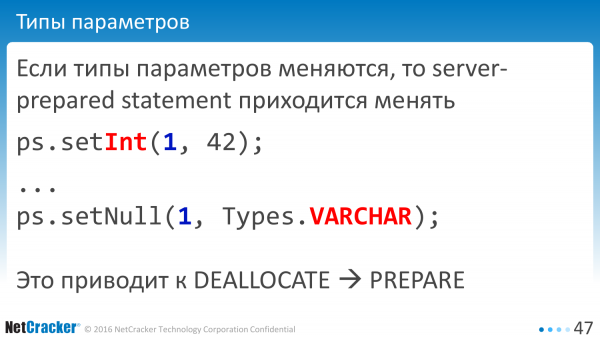
O próximo problema. Os tipos de dados são importantes. Existem ORMs que dizem que não importa qual NULL, pode ser qualquer um. Se for Int, então dizemos setInt. E se for NULL, que seja sempre VARCHAR. E qual é a diferença, afinal, qual NULL está lá? O banco de dados entenderá tudo isso sozinho. E essa lógica não funciona.
Na prática, o banco de dados não está nem um pouco indiferente. Se você disse pela primeira vez que era um número, e na segunda vez disse que era VARCHAR, não é possível reutilizar as declarações preparadas do servidor. E nesse caso, precisamos recriar nossa declaração.
Se você executa a mesma consulta, certifique-se de que os tipos de dados nas colunas não se confundam. É necessário prestar atenção ao NULL. Este é um erro comum que tivemos depois que começamos a usar PreparedStatements.
Beleza, ativamos. Pegamos, talvez, um driver. E o desempenho caiu. Tudo ficou ruim.
Como isso pode acontecer? É um bug ou uma funcionalidade? Infelizmente, não conseguimos entender se é um bug ou uma funcionalidade. Mas existe um cenário bastante simples para reproduzir esse problema. Ele nos pegou de surpresa. E envolve a seleção de literalmente uma única tabela. Nós, claro, tivemos mais consultas como essa. Geralmente, incluíam duas ou três tabelas, mas há esse cenário de reprodução. Pegue qualquer versão do seu banco e reproduza.
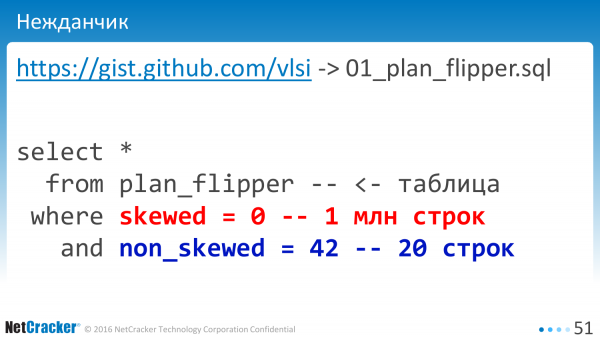
A questão é que temos duas colunas, cada uma indexada. Em uma coluna há um milhão de linhas com o valor NULL. E na outra coluna, apenas 20 linhas. Quando executamos sem variáveis ligadas, tudo funciona bem.
Se começarmos a executar com variáveis ligadas, ou seja, usamos o sinal "?" ou "$1" em nossa consulta, o que obtemos no final?
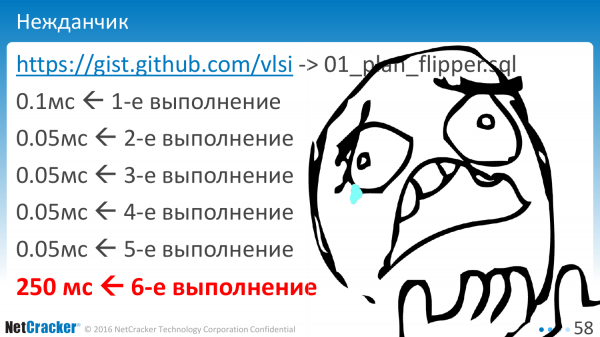
A primeira execução – como deveria ser. A segunda – um pouco mais rápida. Algo foi armazenado em cache. A terceira, quarta e quinta. Depois, acontece uma queda – e de repente assim. E o pior é que isso acontece na sexta execução. Quem sabia que eram exatamente seis execuções para entender qual é realmente o plano de execução?
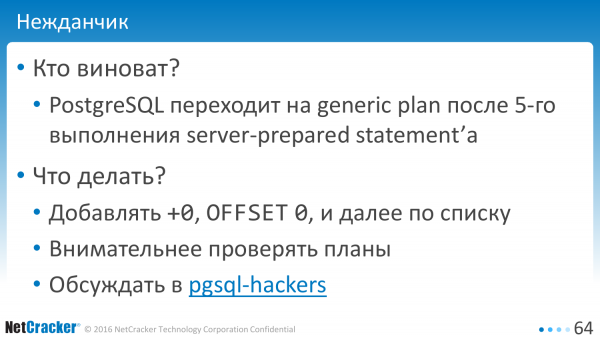
Quem é o culpado? O que aconteceu? O banco de dados contém uma otimização. E ele está otimizado para um caso genérico. Assim, a partir de certo ponto, ele passa a utilizar um plano genérico que, infelizmente, pode acabar sendo diferente. Pode ser o mesmo ou pode ser outro. E há um valor limite que leva a esse comportamento.
O que se pode fazer sobre isso? Aqui, claro, é mais difícil especular. Existe uma solução simples que usamos. É +0, OFFSET 0. Com certeza você conhece tais soluções. Simplesmente pegamos e adicionamos «+0» na consulta e tudo fica bem. Mostrarei mais tarde.
E há outra opção – analisar os planos com mais atenção. O desenvolvedor não deve apenas escrever a consulta, mas também dizer «explain analyze» 6 vezes. Se for 5, não servirá.
E há uma terceira opção – escrever uma carta para pgsql-hackers. Eu escrevi, mas, até agora, não está claro se é um bug ou uma feature.
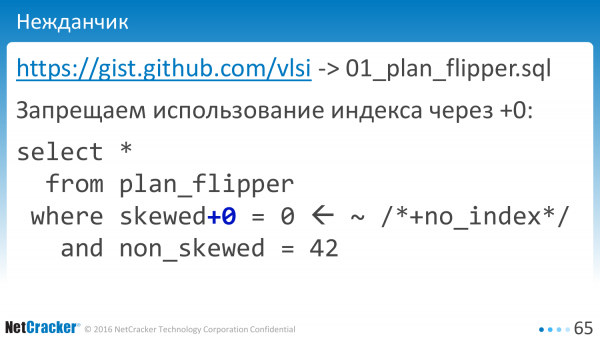
Enquanto pensamos se é um bug ou uma feature, vamos consertar isso. Pegamos nossa consulta e adicionamos «+0». Tudo fica bem. São apenas dois caracteres e nem precisamos pensar muito sobre isso. Muito simples. Nós apenas proibimos o banco de dados de usar o índice nessa coluna. Não temos um índice na coluna «+0» e, portanto, o banco de dados não usa o índice, tudo bem.
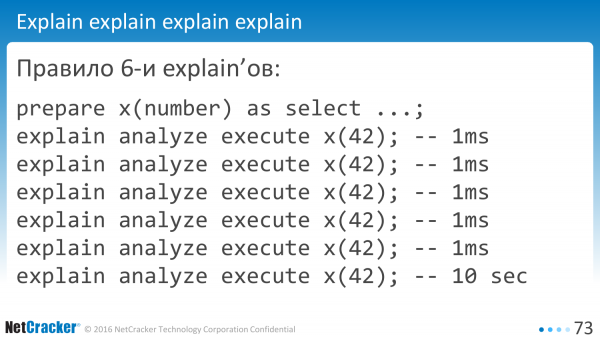
Essa é a regra dos 6 explains. Agora, nas versões atuais, é necessário fazer 6 vezes se você tiver variáveis relacionadas. Se você não tiver variáveis relacionadas, fazemos assim. E no final, essa consulta específica falha. Não é complicado.
Parece que quanto mais olhamos, mais bugs encontramos. Realmente, há bugs por toda parte.
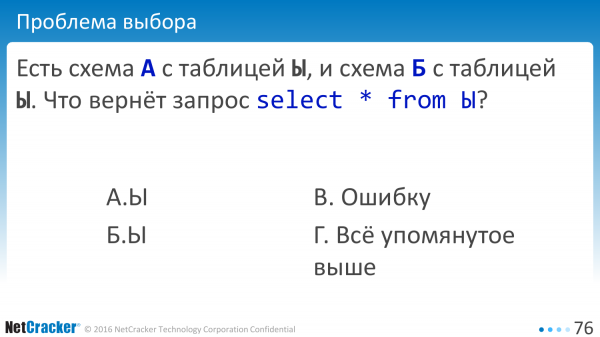
Vamos dar uma olhada mais. Por exemplo, temos dois esquemas. Esquema A com a tabela Y e esquema B com a tabela Y. A consulta – selecionar dados da tabela. O que teremos? Teremos um erro. Teremos tudo o que foi mencionado acima. A regra é essa – bug por toda parte, teremos tudo o que foi mencionado acima.
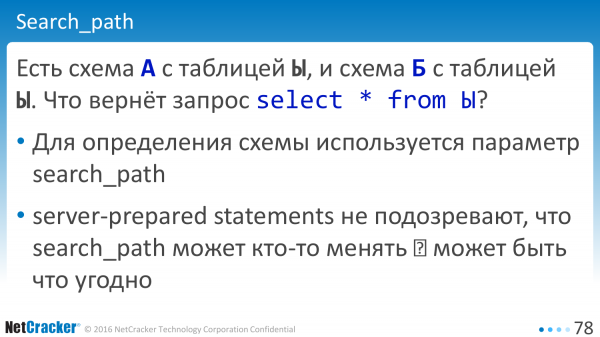
Agora a pergunta é: «Por quê?». Parece que há documentação que, se temos um esquema, existe a variável «search_path» que indica onde procurar a tabela. À prima vista, a variável existe.
Qual é o problema? O problema é que os server-prepared statements não suspeitam que alguém pode alterar o search_path. Esse valor permanece como que constante para o banco de dados. E algumas partes podem não captar os novos valores.
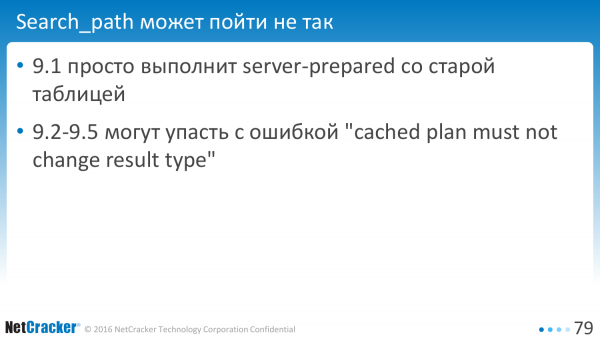
Claro, isso depende da versão em que você está testando. Depende de quão diferentes são as suas tabelas. E a versão 9.1 apenas executará as consultas antigas. Versões mais novas podem detectar um problema e informar que você tem um erro.
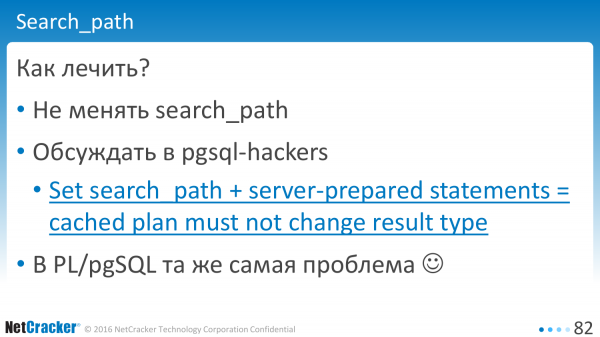
Como resolver isso? Há uma receita simples – não faça assim. Não mude o search_path enquanto a aplicação estiver em funcionamento. Se você mudar, é melhor criar uma nova conexão.
Podemos discutir, ou seja, abrir, discutir, adicionar. Talvez consigamos convencer os desenvolvedores de banco de dados que, quando alguém muda um valor, o banco de dados deve informar ao cliente: "Veja, o seu valor foi atualizado. Talvez você precise redefinir os statements, recriá-los?". Atualmente, o banco de dados se comporta de forma discreta e não informa nada sobre a mudança interna dos statements.
E eu novamente enfatizo – isso não é típico para Java. Nós veremos a mesma coisa em PL/pgSQL um a um. Mas lá irá reproduzir.
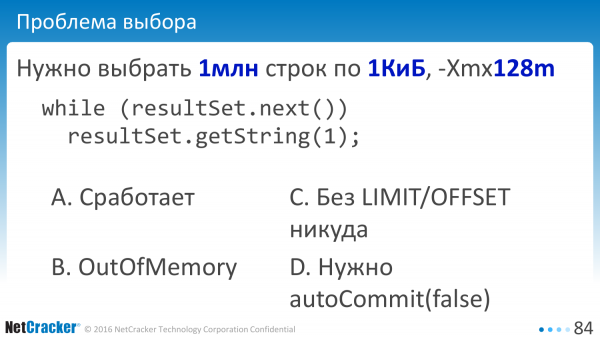
Vamos tentar escolher os dados novamente. Escolhemos, escolhemos. Temos uma tabela com um milhão de linhas. Cada linha tem um quilobyte. Aproximadamente um gigabyte de dados. E temos uma memória de trabalho na máquina Java de 128 megabytes.
Como recomendado em todos os livros, usamos processamento em streaming. Ou seja, abrimos o resultSet e lemos os dados lentamente. Isso funcionará? Não ficará sem memória? Lerá aos poucos? Vamos confiar no banco, confiar no Postgres. Não confiamos. Vamos enfrentar um OutOfMemory? Quem já enfrentou um OutOfMemory? E quem conseguiu consertar depois? Alguém conseguiu consertar.
Se você tem um milhão de linhas, não pode simplesmente selecionar. É necessário usar OFFSET/LIMIT. Quem apoia essa opção? E quem acha que devemos brincar com autoCommit?
Aqui, como de costume, a opção mais inesperada acaba sendo a correta. E se, por acaso, você desativar o autoCommit, isso ajudará. Por que isso? A ciência não sabe.
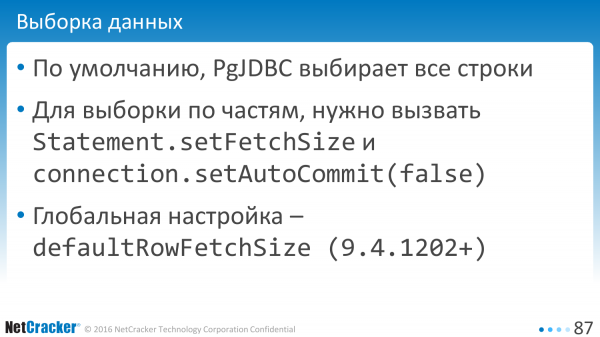
Mas por padrão, todos os clientes que se conectam ao banco de dados Postgres selecionam os dados por completo. O PgJDBC não é exceção, seleciona todas as linhas.
Há uma variação sobre o tema FetchSize, ou seja, você pode, ao nível de um statement individual, dizer que aqui, por favor, selecione os dados em grupos de 10, 50. Mas isso não funciona até você desativar o autoCommit. Desativou o autoCommit – começa a funcionar.
Mas percorrer o código e definir setFetchSize em todos os lugares é inconveniente. Por isso, criamos uma configuração que define o valor padrão para toda a conexão.
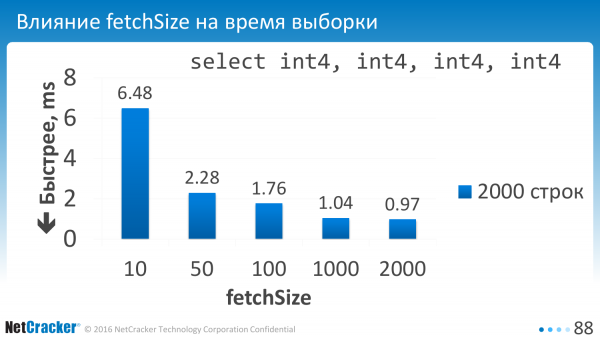
Então, nós dissemos isso. Configuramos o parâmetro. E o que temos? Se escolhemos por um pequeno número, por exemplo, 10 linhas, nossas despesas com isso são bastante altas. Portanto, esse valor deve ser em torno de cem.
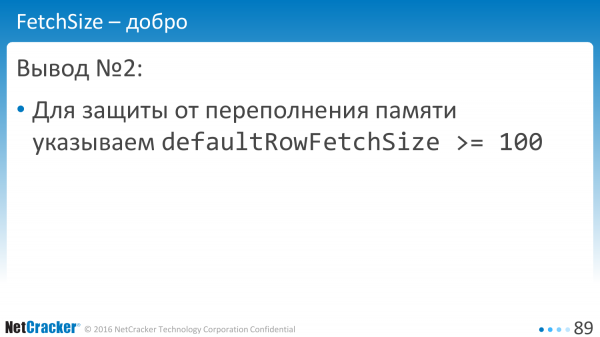
Idealmente, é claro, também deveríamos aprender a limitar em bytes, mas a receita é a seguinte: definimos defaultRowFetchSize acima de cem e ficamos felizes.
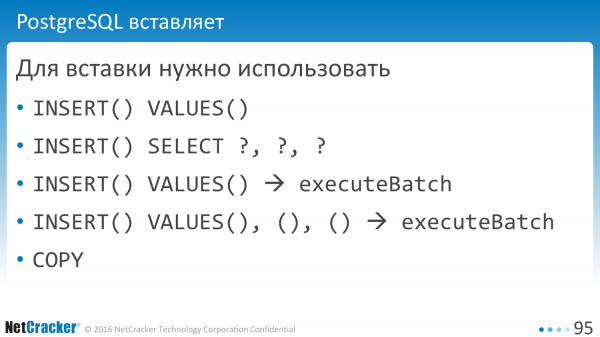
Vamos passar para a inserção de dados. A inserção é mais simples, existem diferentes opções. Por exemplo, INSERT, VALUES. Essa é uma boa opção. Podemos falar em 'INSERT SELECT'. Na prática, é a mesma coisa. Não há diferença em termos de desempenho.
Os livros dizem que devemos executar o Batch statement, os livros dizem que é possível executar comandos mais complexos com várias chaves. E no Postgres há uma função maravilhosa - podemos fazer COPY, ou seja, fazer isso mais rapidamente.

Se medirmos, podemos fazer algumas descobertas interessantes novamente. Como queremos que isso funcione? Queremos evitar parsing e não executar comandos desnecessários.
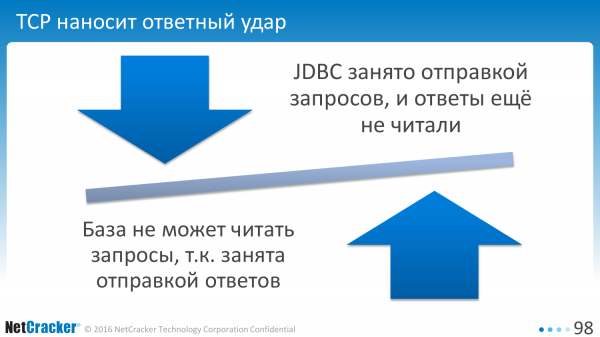
Na prática, o TCP não nos permite fazer isso. Se o cliente está ocupado enviando um pedido, o banco de dados, na tentativa de nos enviar as respostas, não lê os pedidos. No final, o cliente aguarda o banco de dados enquanto ele lê o pedido, e o banco de dados aguarda o cliente enquanto ele lê a resposta.
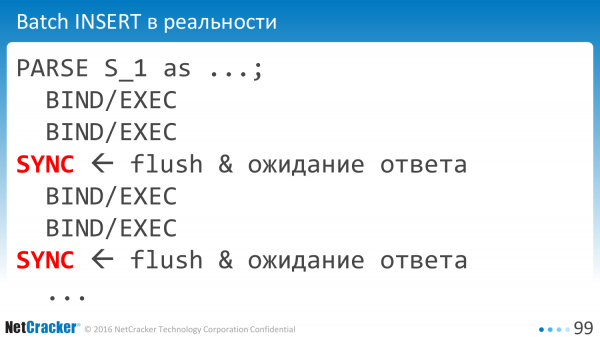
E por isso o cliente é obrigado a enviar periodicamente um pacote de sincronização. Interações de rede desnecessárias, perda de tempo adicional.
 E quanto mais os adicionamos, pior fica. O driver é bastante pessimista e os adiciona com frequência, cerca de uma vez a cada 200 linhas, dependendo do tamanho das linhas, etc.
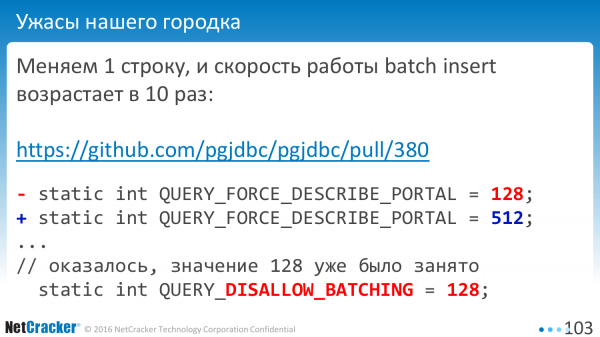
Às vezes, corrigir apenas uma linha pode acelerar tudo em 10 vezes. Isso acontece. Por quê? Como normalmente, uma constante já havia sido usada em algum lugar. E o valor '128' significava - não usar batching.
Ainda bem que isso não chegou à versão oficial. Descobrimos antes de começarmos a lançar a versão. Todos os valores que menciono são baseados em versões modernas.
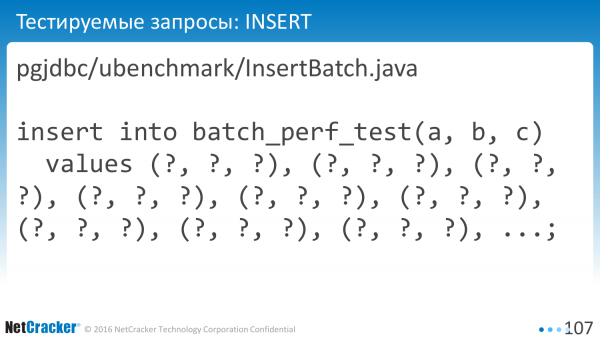
Vamos fazer uma medição. Medimos o InsertBatch simples. Medimos o InsertBatch múltiplo, ou seja, o mesmo, mas com muitas values. Um truque habilidoso. Nem todos sabem fazer isso, mas é um truque simples, muito mais fácil do que COPY.
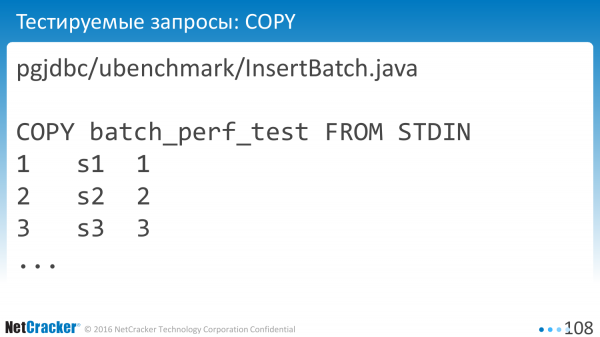
Podemos fazer COPY.
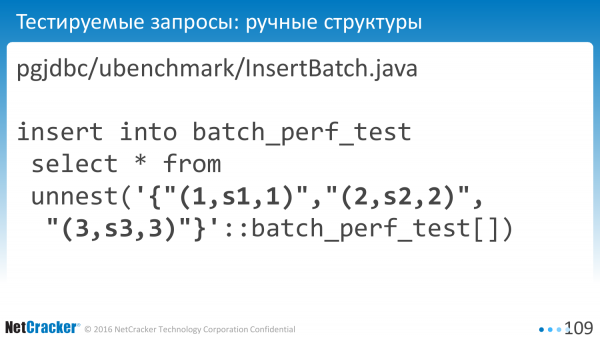
E é possível fazer isso em estruturas. Declare o tipo User default, passe um array e INSIRA diretamente na tabela.
Se você abrir o link: pgjdbc/ubenchmsrk/InsertBatch.java, verá que esse código está no GitHub. Você pode verificar especificamente quais consultas estão sendo geradas. Não é o principal.
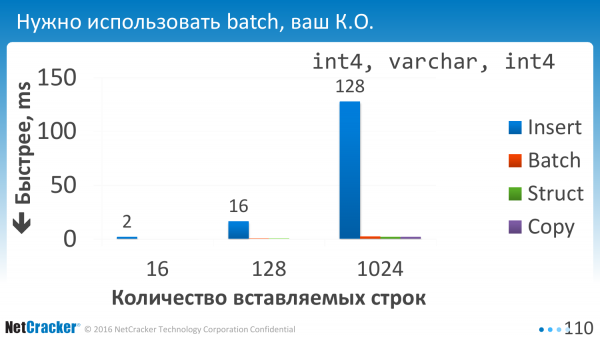
Nós executamos. E a primeira coisa que percebemos é que não usar batch é simplesmente inadmissível. Todas as opções de batching são equivalentes a zero, ou seja, o tempo de execução é praticamente zero em comparação com a execução única.
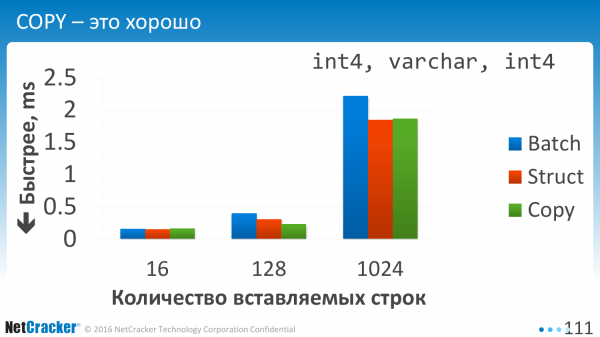
Estamos inserindo dados. É uma tabela bastante simples. Três colunas. E o que vemos aqui? Vemos que todas essas três opções são aproximadamente comparáveis. E COPY, claro, é a melhor.
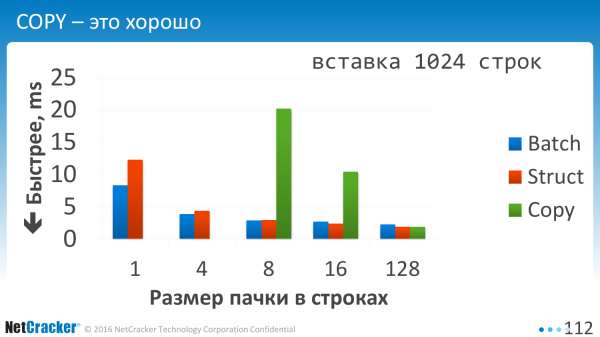
Isso é quando inserimos em partes. Quando dizemos que um valor é VALUES, dois valores são VALUES, três valores são VALUES ou se os indicamos 10 separados por vírgula. Isso é exatamente o que vemos na horizontal. 1, 2, 4, 128. É visível que o Batch Insert, que está desenhado em azul, se torna muito mais leve por causa disso. Ou seja, quando você insere um a um ou mesmo quando insere quatro, melhora duas vezes, simplesmente por termos colocado um pouco mais em VALUES. Menos operações EXECUTE.
Usar COPY para pequenos volumes é extremamente pouco promissor. Eu nem desenhei nos dois primeiros. Eles vão para os céus, ou seja, esses números verdes são para COPY.
COPY deve ser usado quando você tem um volume de dados de pelo menos mais de cem linhas. Os custos de abertura dessa conexão são altos. E, honestamente, não aprofundei nesse aspecto. Eu otimizei batch, COPY não.
O que fazemos a seguir? Medimos. Entendemos que precisamos usar ou estruturas ou um batch engenhoso que combine vários valores.
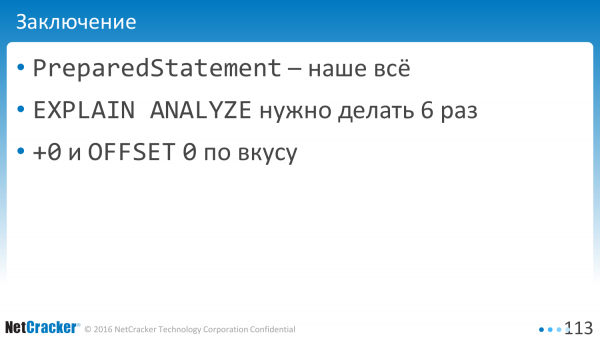
O que precisa ser destacado da apresentação de hoje?
- PreparedStatement é tudo para nós. Isso traz muitos benefícios para o desempenho. Aumenta muito o 'barril de alcatrão'.
- E precisamos fazer EXPLAIN ANALYZE 6 vezes.
- E é necessário diluir OFFSET 0, e truques como +0 para ajustar o restante da porcentagem de nossas consultas problemáticas.
Fonte: habr.com
