

Muitos que já utilizam — nosso serviço de visualização de planos PostgreSQL, talvez não estejam cientes de uma das suas supercapacidades — transformar um pedaço de log do servidor de difícil leitura…
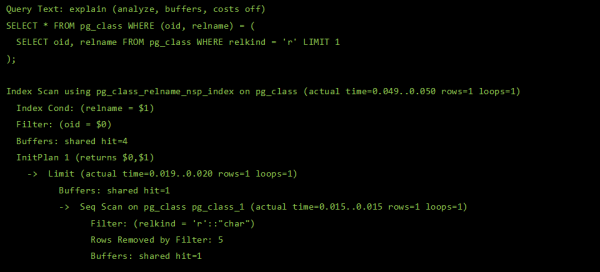
… em uma consulta bem formatada com dicas contextuais sobre os nós correspondentes do plano:
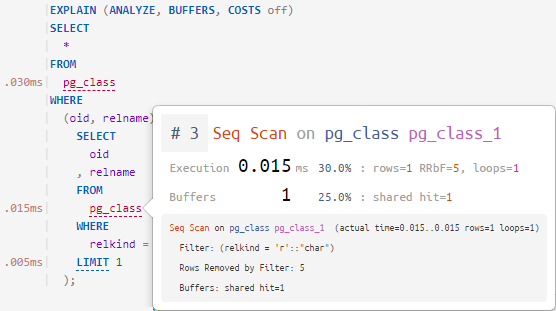
Nesta interpretação da segunda parte de sua vou contar como conseguimos fazer isso.
Com a transcrição da primeira parte, dedicada aos problemas típicos de desempenho das consultas e suas soluções, você pode se familiarizar no artigo .
Primeiro vamos nos concentrar na formatação — e vamos formatar não o plano, que já está bonito e compreensível, mas sim a consulta.
Achamos que assim, com essa 'cama' desformatada, a consulta extraída do log parece muito feia e, portanto, — inconveniente.
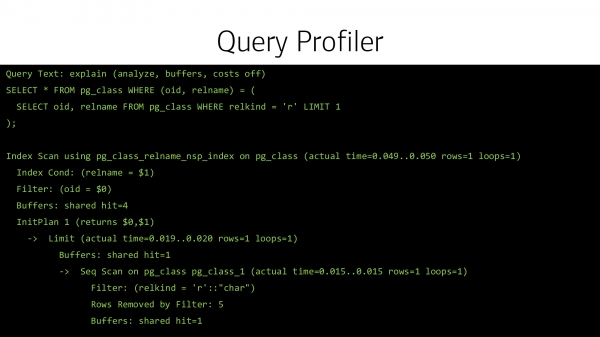
Especialmente quando os desenvolvedores colam o corpo da consulta dentro do código (isso, claro, é um antipadrão, mas acontece) em uma única linha. Que horror!
Vamos desenhar isso de forma mais bonita.
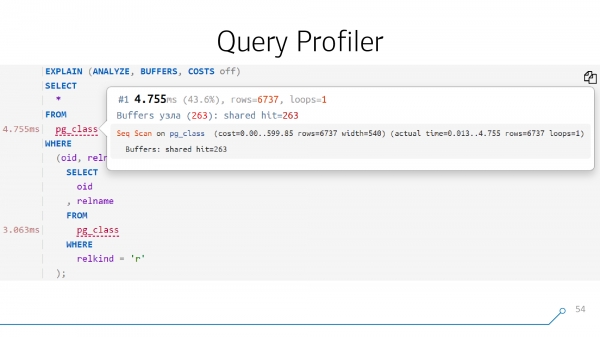
E se conseguirmos desenhar isso de maneira atraente, ou seja, analisar e montar novamente o corpo da consulta, poderemos então adicionar uma dica a cada objeto dessa consulta — sobre o que aconteceu no ponto correspondente do plano.
Árvore sintática da consulta
Para isso, precisamos primeiro analisar a consulta.
Como nosso , fizemos um módulo, você pode . Na verdade, isso é uma extensão dos 'bindings' para as entranhas do próprio parser do PostgreSQL. Ou seja, apenas a gramática compilada binariamente e com bindings do lado do NodeJS. Usamos módulos de terceiros como base — não há grande mistério aqui.
Passamos o corpo da consulta como entrada para nossa função — e na saída obtemos a árvore sintática analisada na forma de um objeto JSON.
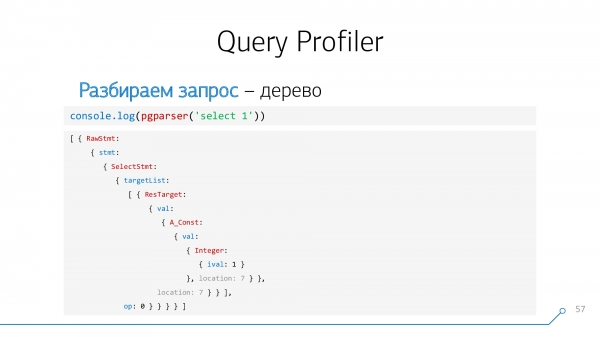
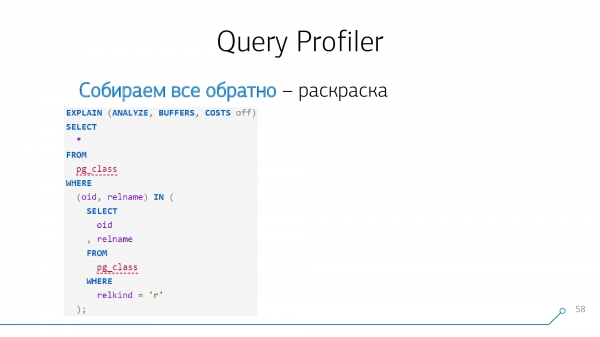
Agora, podemos percorrer essa árvore de trás para frente e reconstruir a consulta com os recuos, formatação e coloração que desejamos. Não, isso não é configurável, mas achamos que assim será mais conveniente.
Correspondência dos nós da consulta e do plano
Agora vamos ver como podemos combinar o plano que analisamos no primeiro passo e a consulta que analisamos no segundo.
Vamos pegar um exemplo simples — temos uma consulta que forma um CTE e lê dela duas vezes. Ele gera um plano assim.
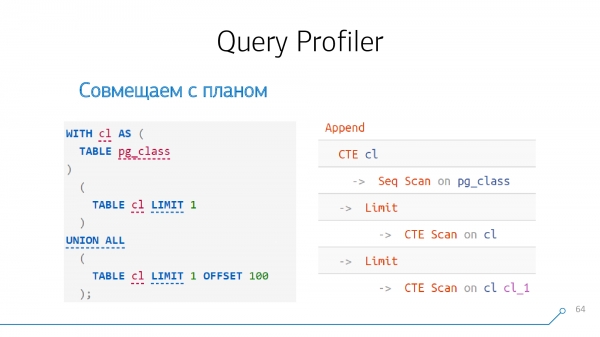
CTE
Se olharmos atentamente para ele, até a versão 12 (ou a partir dela com a palavra-chave MATERIALIZED) a formação .
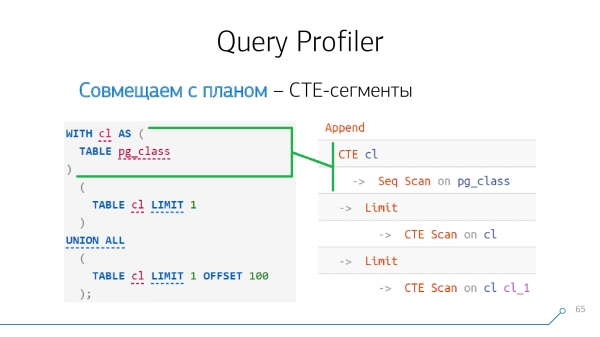
E, portanto, se vemos em algum lugar na consulta a geração de CTE e em algum lugar no plano um nó CTE, esses nós claramente "colidem" entre si, podemos imediatamente combiná-los.
A tarefa "com estrela": os CTE podem ser aninhados.
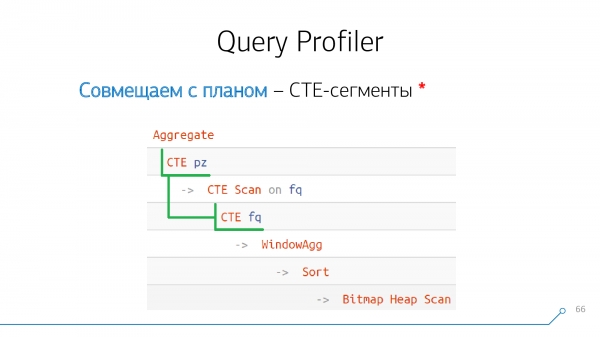
Eles podem ser muito mal aninhados, e até com nomes iguais. Por exemplo, você pode dentro de CTE A fazer CTE X, e no mesmo nível dentro CTE B fazer novamente CTE X:
WITH A AS (
  WITH X AS (...)
  SELECT ...
)
, B AS (
  WITH X AS (...)
  SELECT ...
)
...
Na correspondência, você deve entender isso. Compreender isso "com os olhos" — mesmo vendo o plano, mesmo vendo o corpo da consulta — é muito difícil. Se você tem uma geração de CTE complicada, aninhada, e consultas grandes — então se torna completamente inconsciente.
UNION
Se temos na consulta a palavra-chave UNION [ALL] (operador que une duas seleções), então no plano corresponde a um nó Anexar, ou algum União Recursiva.
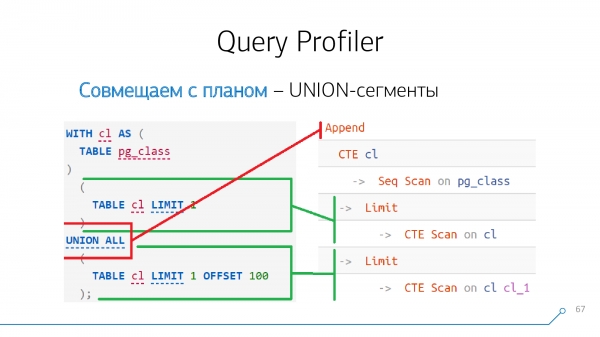
O que "está em cima" é o primeiro descendente do nosso nó, o que "está embaixo" — o segundo. Se através de UNION nós "colamos" vários blocos de uma vez, então UNION -o nó ainda será apenas um, mas seus filhos não serão dois, mas muitos — na ordem em que aparecem, respectivamente: Anexar(...) -- #1 UNION ALL (...) -- #2 UNION ALL (...) -- #3
  Append
  -> ... #1
  -> ... #2
  -> ... #3
: dentro da geração de seleção recursiva (
A tarefa "com estrela"WITH RECURSIVE) também pode haver mais de um. Mas sempre é recursivo apenas o último bloco após o último UNION. Tudo que está acima — isso é um, mas outro UNIONWITH RECURSIVE T AS( (...) -- #1 UNION ALL (...) -- #2, aqui termina a geração do estado inicial da recursão UNION ALL (...) -- #3, apenas este bloco é recursivo e pode conter referências a T ) ... UNION:
Esses exemplos também precisam ser "desmontados". Neste exemplo, vemos que -segmentos em nossa consulta foram 3 unidades. Portanto, um UNIONcorresponde a UNION -nó, e o outro — AnexarLeitura e gravação de dados União Recursiva.
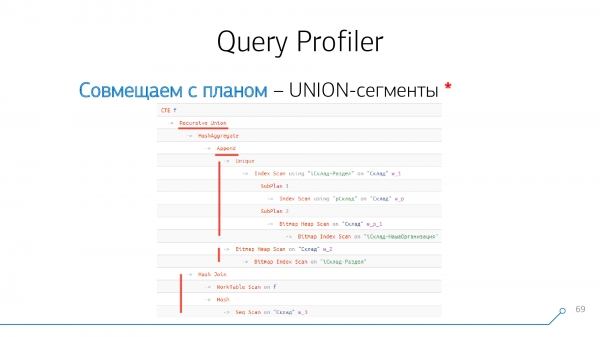
Agora que desmontamos, sabemos qual parte da consulta corresponde a qual parte do plano. E nessas partes podemos facilmente encontrar os objetos que são "lidos".
Do ponto de vista da consulta, não sabemos — se é uma tabela ou CTE, mas são indicados pelo mesmo nó.
Do ponto de vista da consulta, não sabemos se é uma tabela ou CTE, mas são indicados pelo mesmo nó. Variedade. E no plano, a "leitura" também é um conjunto bastante limitado de nós:
Escaneamento Sequencial em [tbl]Varredura de Bitmap Heap em [tbl]Índice [Somente] Escanear [Para Trás] usando [idx] em [tbl]Escaneamento CTE em [cte]Inserir/Atualizar/Excluir em [tbl]
Sabemos a estrutura do plano e da consulta, sabemos a correspondência dos blocos, sabemos os nomes dos objetos — fazemos a correspondência inequívoca.
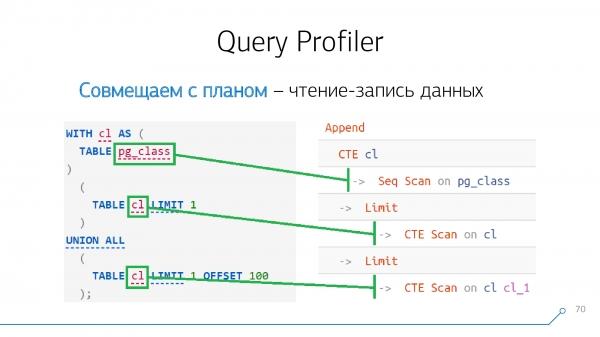
Novamente, a tarefa "com a estrela". Pegamos a consulta, executamos, não temos aliases — apenas lemos duas vezes de uma única CTE.
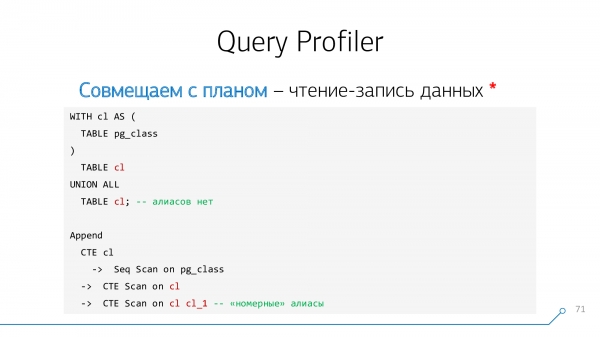
Olhamos para o plano — qual é o problema? Por que temos um alias aparecendo? Não o pedimos. De onde veio esse "número"?
O PostgreSQL o adiciona automaticamente. É preciso entender que um alias assim não tem nenhum significado para nós em termos de correspondência com o plano, ele foi apenas adicionado aqui. Não vamos prestar atenção a ele.
Segundo a tarefa "com a estrela": se estamos fazendo uma leitura de uma tabela particionada, teremos um nó Anexar ou Mesclar Adicionar, que consistirá em um grande número de "filhos", e cada um deles será algum tipo de Scanda tabela-seção: Escaneamento Sequencial, Varredura de Bitmap Heap ou Index Scan.Mas, de qualquer forma, esses "filhos" não serão consultas complexas — é assim que esses nós podem ser diferenciados de Anexar quando UNION.
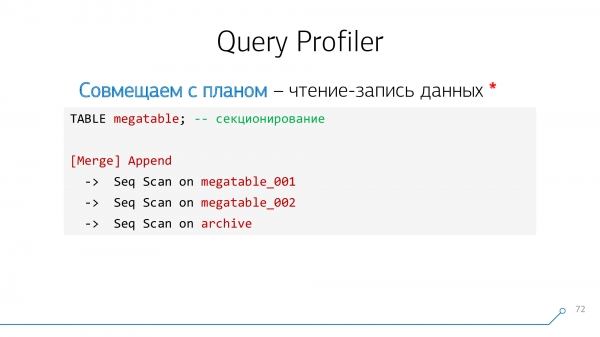
Esses nós também entendemos, agrupamos "em um único lugar" e dizemos: "tudo o que você leu da megatable — está aqui e desce pela árvore".
"Nós simples de obtenção de dados
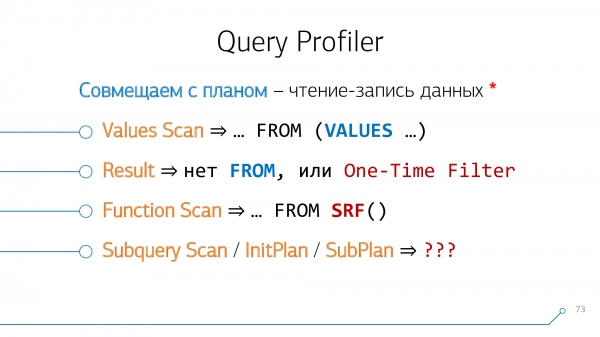
Verificação de Valores no plano corresponde VALUES na consulta.
Resultado — esta é uma consulta sem FROM parece SELECT 1.Ou quando você tem uma expressão falsa garantida em WHERE-bloco (então surge o atributo One-Time Filter):
EXPLAIN ANALYZE
SELECT * FROM pg_class WHERE FALSE; -- ou 0 = 1
Resultado (custo=0.00..0.00 linhas=0 largura=230) (tempo real=0.000..0.000 linhas=0 loops=1)
Filtro One-Time: falso
Escaneamento de Função "mapeiam-se" para as SRF homônimas.
Mas com as subconsultas tudo é mais complicado — infelizmente, nem sempre elas se transformam em PlanoInicial/SubPlano. Às vezes, elas se transformam em ... Join ou ... Anti Join,, especialmente quando você escreve algo como WHERE NOT EXISTS .... E daí, combiná-las nem sempre é possível — no texto do plano, os operadores correspondentes aos nós do plano não estão presentes.
Novamente, a tarefa "com a estrela": várias VALUES na consulta. Nesse caso, também no plano você receberá vários nós Verificação de Valores.
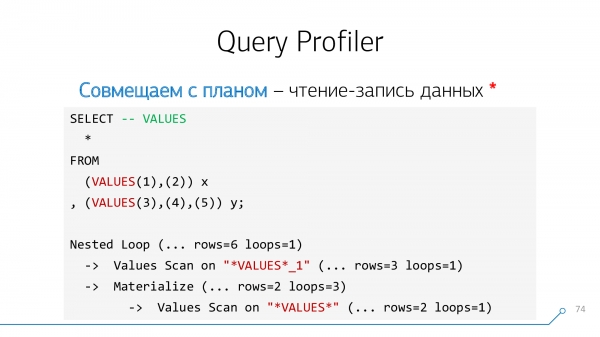
Diferenciá-los um do outro será ajudado por sufixos "numéricos" — eles são adicionados de acordo com a ordem da correspondência dos VALUES-blocos ao longo da consulta de cima para baixo.
Processamento de dados
Parece que revisamos tudo na nossa consulta — resta apenas Limite.
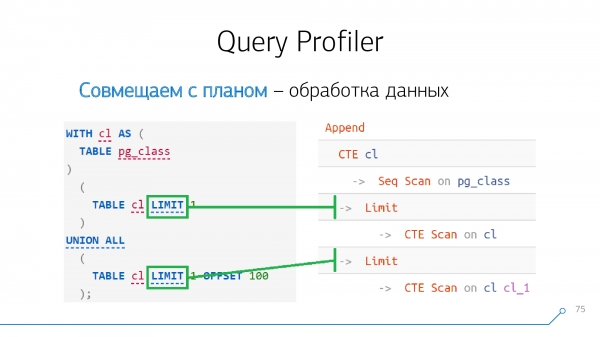
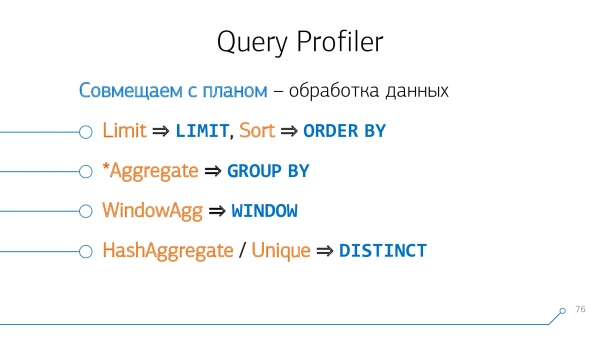
Mas isso é simples — nós como esses Limite, Ordenar, Agregado, WindowAgg, Único "mapeiam-se" um-a-um para os operadores correspondentes na consulta, se eles estiverem lá. Aqui não há "estrelas" nem complexidades.
JOIN
Dificuldades surgem quando queremos combinar JOIN entre si. Isso nem sempre é possível, mas pode ser feito.
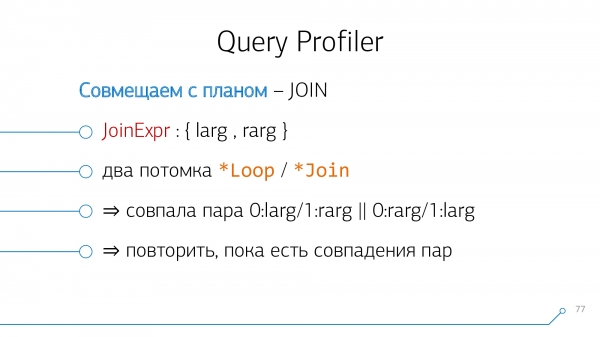
Do ponto de vista do analisador de consultas, temos um nó JoinExpr, que possui exatamente dois filhos - esquerdo e direito. Isso é, respectivamente, o que está "acima" do seu JOIN e o que está "abaixo" dele na consulta.
E do ponto de vista do plano, isso são dois filhos de algum * Loop/* Junte-se-nó. Nested Loop, Hash Anti Join,… — algo assim.
Vamos usar uma lógica simples: se temos tabelas A e B que se "juntam" entre si no plano, na consulta elas podem estar dispostas de duas maneiras: A-JOIN-B, ou B-JOIN-A. Vamos tentar combiná-las assim, depois tentar combiná-las ao contrário, e assim até que esses pares se esgotem.
Vamos pegar nossa árvore sintática, pegar nosso plano, olhá-los… não parecem semelhantes!
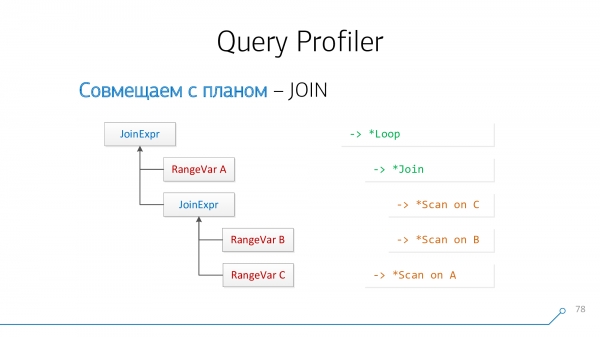
Reestruturamos na forma de gráficos — ah, já começa a parecer algo!
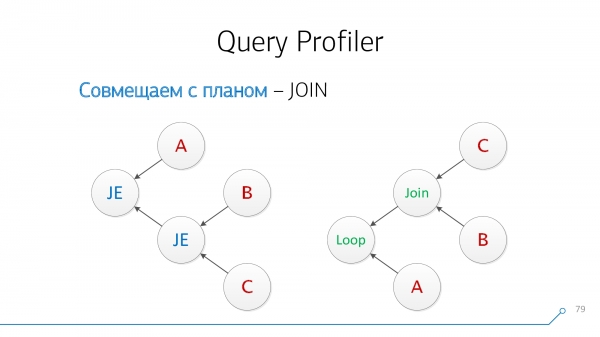
Vamos prestar atenção que temos nós que têm filhos B e C ao mesmo tempo — não nos importa a ordem. Vamos combiná-los e inverter a imagem do nó.
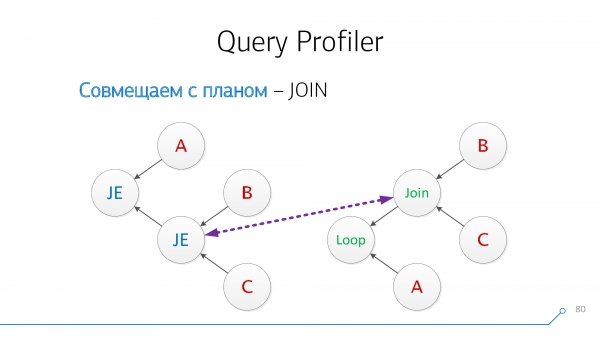
Vamos olhar novamente. Agora temos nós com filhos A e o par (B + C) — vamos combiná-los também.
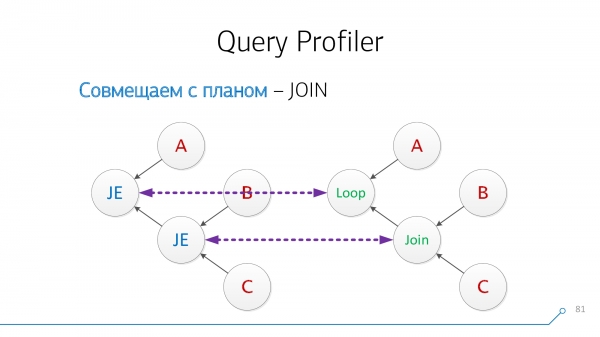
Ótimo! Parece que temos esses dois JOIN da consulta com nós do plano combinados com sucesso.
Infelizmente, essa tarefa nem sempre é resolvível.
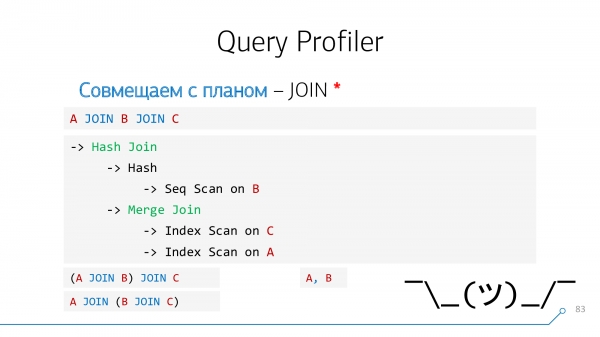
Por exemplo, se na consulta A JOIN B JOIN C, e no plano os nós "extremos" A e C se conectaram primeiro. E na consulta não há tal operador, não temos nada para destacar, nada a que vincular a dica. A mesma coisa acontece com a "vírgula", quando você escreve A, B.
Mas, na maioria dos casos, quase todos os nós podem ser "desfeitos" e obter essa perfuração à esquerda por tempo — literalmente, como no Google Chrome, quando você analisa o código JavaScript. Você vê quanto tempo cada linha e cada operador "foram executados".
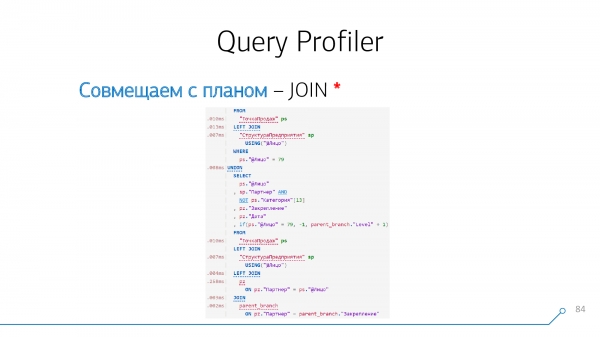
E para que seja mais fácil para você usar tudo isso, nós criamos um armazenamento , onde você pode salvar e depois encontrar seus planos junto com consultas associadas ou compartilhar um link com alguém.
Se você apenas precisa trazer uma consulta ilegível para um formato adequado, use .
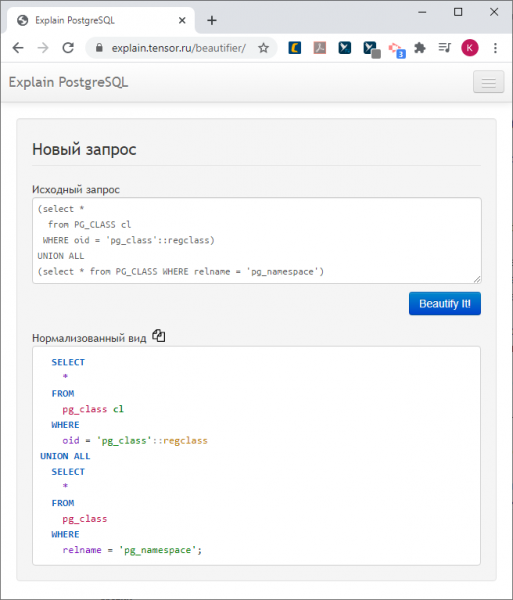
Fonte: habr.com
