

Numerosos aplicativos e sistemas de virtualização Enterprise possuem seus próprios mecanismos para construir soluções de alta disponibilidade. Em particular, o Oracle RAC (Oracle Real Application Cluster) consiste em um cluster de dois ou mais servidores de banco de dados Oracle que trabalham em conjunto para balancear a carga e garantir a alta disponibilidade em nível de servidor/aplicativo. Para operar nesse modo, é necessário um armazenamento compartido, normalmente na forma de um sistema de armazenamento de dados (SCD).
Como já discutimos em um de nossos , o próprio SCD, apesar de ter componentes duplicados (incluindo controladores), ainda possui pontos de falha – principalmente na forma de um único conjunto de dados. Portanto, para construir uma solução Oracle com requisitos elevados de confiabilidade, o esquema "N servidores – um SCD" precisa ser aprimorado.
Primeiramente, é claro, é necessário definir quais riscos estamos tentando mitigar. Neste artigo, não abordaremos a proteção contra ameaças do tipo "a meteorito caiu". Assim, a construção de uma solução de recuperação de desastres com localização geográfica distribuída ficará para um dos próximos artigos. Aqui, discutiremos a chamada solução de recuperação de desastres Cross-Rack, onde a proteção é construída no nível dos racks de servidores. Os próprios racks podem estar localizados em um único ambiente ou em diferentes locais, geralmente dentro de um mesmo edifício.
Esses racks devem conter todo o conjunto necessário de hardware e software que permita o funcionamento dos bancos de dados Oracle independentemente do estado do "vizinho". Em outras palavras, usando a solução de recuperação de desastres Cross-Rack, eliminamos riscos em caso de falha:
- Servidores de aplicativo Oracle
- Sistemas de armazenamento
- Sistemas de comutação
- Falha total de todo o equipamento no rack:
- Falha de energia
- Falha do sistema de refrigeração
- Fatores externos (humanos, naturais, etc.)
A duplicação de servidores Oracle implica o próprio princípio de funcionamento do Oracle RAC e é realizada por meio de um aplicativo. A duplicação de sistemas de comutação também não apresenta problemas. No entanto, a duplicação do sistema de armazenamento é mais complicada.
A opção mais simples é a replicação de dados do sistema de armazenamento principal para o secundário. Sincronizada ou assíncrona, dependendo das capacidades do armazenamento. Com a replicação assíncrona, surge imediatamente a questão de garantir a consistência dos dados em relação ao Oracle. Mas mesmo que haja integração programática com o aplicativo, em qualquer caso, após uma falha no armazenamento principal, será necessário a intervenção manual dos administradores para transferir o cluster para o armazenamento de backup.
Uma opção mais complexa são os 'virtualizadores' de armazenamento programáticos e/ou de hardware, que eliminam problemas de consistência e intervenção manual. No entanto, a complexidade de implementação e administração subsequente, além do custo exorbitante de tais soluções, afastam muitos.
Para cenários como a recuperação de desastres Cross-Rack, a solução All Flash AccelStor NeoSapphire™ é perfeita. Usando a arquitetura Shared-Nothing. Este modelo consiste em um sistema de armazenamento em duas unidades que utiliza sua própria tecnologia FlexiRemap® para operar com unidades flash. Graças a O NeoSapphire™ H710 pode fornecer desempenho de até 600K IOPS@4K de escrita aleatória e 1M+ IOPS@4K de leitura aleatória, o que é inatingível ao usar sistemas de armazenamento baseados em RAID clássicos.
Mas a principal característica do NeoSapphire™ H710 é a implementação de duas unidades em gabinetes separados, cada uma com sua própria cópia de dados. A sincronização das unidades é realizada por meio de uma interface externa InfiniBand. Com essa arquitetura, é possível colocar as unidades em locais diferentes a uma distância de até 100m, possibilitando assim a solução Cross-Rack de recuperação de desastres. Ambas as unidades operam completamente em modo síncrono. Do lado dos hosts, o H710 aparece como um sistema de armazenamento de dois controladores comum. Portanto, não há necessidade de opções de software e hardware adicionais nem de configurações especialmente complexas.
Se compararmos todas as soluções de recuperação de desastres Cross-Rack mencionadas acima, a da AccelStor se destaca claramente das demais:
AccelStor NeoSapphire™ Arquitetura Shared Nothing
Virtualizador de armazenamento programático ou de hardware
Solução baseada em replicação
Acessibilidade
Falha do servidor
Sem Tempo de Inatividade
Sem Tempo de Inatividade
Sem Tempo de Inatividade
Falha do switch
Sem Tempo de Inatividade
Sem Tempo de Inatividade
Sem Tempo de Inatividade
Falha do sistema de armazenamento
Sem Tempo de Inatividade
Sem Tempo de Inatividade
Tempo de Inatividade
Falha de todo o armário
Sem Tempo de Inatividade
Sem Tempo de Inatividade
Tempo de Inatividade
Custo e complexidade
Custo da solução
Baixo*
Alta
Alta
Complexidade de implementação
Baixo
Alta
Alta
*AccelStor NeoSapphire™ é, de fato, um array All Flash que, por definição, não tem um custo muito baixo, especialmente considerando sua capacidade duas vezes maior. No entanto, ao comparar o custo total da solução com soluções similares de outros fornecedores, o custo pode ser considerado baixo.
A topologia de conexão entre os servidores de aplicação e os nós do array All Flash será a seguinte:
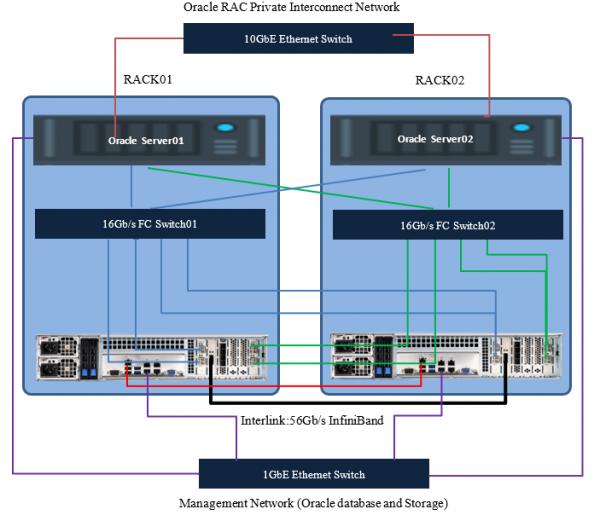
Ao planejar a topologia, também é altamente recomendável duplicar os switches de gerenciamento e de interconexão dos servidores.
Aqui e adiante, falaremos sobre a conexão via Fibre Channel. No caso de uso de iSCSI, será tudo o mesmo, com algumas adaptações quanto aos tipos de switches utilizados e um pouco diferentes configurações do array.
Trabalho preparatório no array
Equipamento e software utilizados
Especificações dos servidores e switches
Componentes
Descrição
Servidores Oracle Database 11g
Dois
Sistema operacional do servidor
Oracle Linux
Versão do banco de dados Oracle
11g (RAC)
Processadores por servidor
Dois processadores Intel® Xeon® CPU E5-2667 v2 @ 3.30GHz com 16 núcleos cada
Memória física por servidor
128GB
Rede FC
FC de 16Gb/s com multipath
FC HBA
Emulex Lpe-16002B
Portas públicas dedicadas de 1GbE para gerenciamento de cluster
Adaptador ethernet Intel RJ45
Switch FC de 16Gb/s
Brocade 6505
Portas privadas dedicadas de 10GbE para sincronização de dados
Intel X520
Especificação do array All Flash AccelStor NeoSapphire™
Componentes
Descrição
Sistema de armazenamento
Modelo de alta disponibilidade NeoSapphire™: H710
Versão da imagem
4.0.1
Número total de unidades
48
Tamanho da unidade
1.92TB
Tipo de unidade
SSD
Portas de destino FC
16x portas de 16Gb (8 por nó)
Portas de gerenciamento
O cabo ethernet de 1GbE conectando-se aos hosts através de um switch ethernet
Porta de heartbeat
O cabo ethernet de 1GbE conectando entre dois nós de armazenamento
Porta de sincronização de dados
Cabo InfiniBand de 56Gb/s
Antes de usar o array, é necessário inicializá-lo. Por padrão, o endereço de gerenciamento de ambos os nós é o mesmo (192.168.1.1). É necessário conectar-se a eles um de cada vez para definir novos (agora diferentes) endereços de gerenciamento e configurar a sincronização de tempo, após o que as portas de gerenciamento podem ser conectadas a uma única rede. A seguir, os nós são agrupados em um par HA através da atribuição de sub-redes para conexões Interlink.
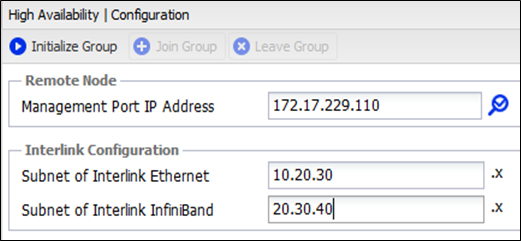
Após a conclusão da inicialização, é possível gerenciar o array a partir de qualquer nó.
Em seguida, criamos os volumes necessários e os publicamos para os servidores de aplicação.
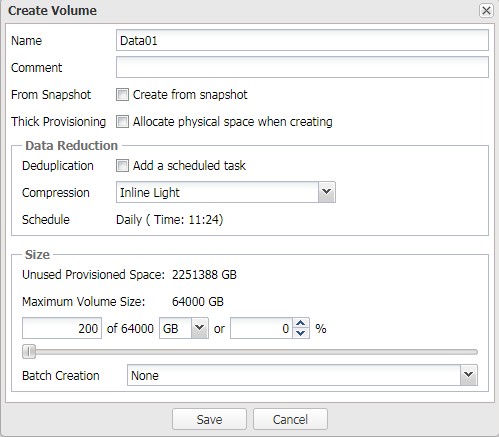
É altamente recomendado criar vários volumes para Oracle ASM, pois isso aumentará o número de targets para os servidores, o que, em última análise, melhorará o desempenho geral (mais detalhes sobre filas em outra seção). ).
Configuração de teste
Nome do volume de armazenamento
Tamanho do volume
Data01
200GB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Algumas explicações sobre os modos de operação do array e os processos envolvidos em situações não padronizadas
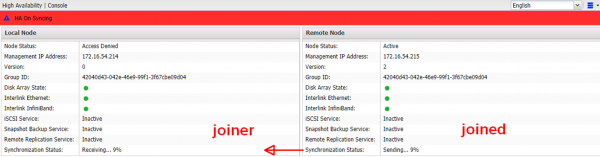
Cada conjunto de dados de um nó possui um parâmetro denominado "número da versão". Após a inicialização, ele é igual a 1. Se, por algum motivo, o número da versão diferir, sempre ocorre a sincronização dos dados da versão mais alta para a mais baixa, após a qual o número da versão mais baixa é ajustado, ou seja, isso significa que as cópias são idênticas. As razões pelas quais as versões podem ser diferentes são:
- Reinicialização programada de um dos nós
- Falha em um dos nós devido a uma interrupção repentina (energia, superaquecimento, etc.).
- Interrupção da conexão InfiniBand com impossibilidade de sincronização
- Falha em um dos nós devido a corrupção de dados. Aqui será necessário criar um novo grupo HA e realizar a sincronização completa do conjunto de dados.
De qualquer forma, o nó que permanece online aumenta seu número de versão em uma unidade, para que, após a restauração da conexão, possa sincronizar seu conjunto de dados.
Se houver uma interrupção na conexão pelo link Ethernet, o Heartbeat muda temporariamente para InfiniBand e retorna em 10 segundos após a restauração.
Configuração de hosts
Para garantir a tolerância a falhas e aumentar o desempenho, é necessário ativar o suporte a MPIO para o array. Para isso, adicione as linhas ao arquivo /etc/multipath.conf e reinicie o serviço multipath
Texto ocultodevices {
device {
vendor "AStor"
path_grouping_policy "group_by_prio"
path_selector "queue-length 0"
path_checker "tur"
features "0"
hardware_handler "0"
prio "const"
failback immediate
fast_io_fail_tmo 5
dev_loss_tmo 60
user_friendly_names yes
detect_prio yes
rr_min_io_rq 1
no_path_retry 0
}
}
Além disso, para que o ASM funcione com MPIO através do ASMLib, é necessário alterar o arquivo /etc/sysconfig/oracleasm e, em seguida, executar /etc/init.d/oracleasm scandisks
Texto oculto
# ORACLEASM_SCANORDER: Matching patterns to order disk scanning
ORACLEASM_SCANORDER="dm"
# ORACLEASM_SCANEXCLUDE: Matching patterns to exclude disks from scan
ORACLEASM_SCANEXCLUDE="sd"
Nota
Se não houver interesse em usar o ASMLib, é possível utilizar regras UDEV, que são a base para o ASMLib.
A partir da versão 12.1.0.2 do Oracle Database, a opção está disponível para instalação como parte do software ASMFD.
É essencial garantir que os discos criados para o Oracle ASM estejam alinhados ao tamanho do bloco com o qual o array opera fisicamente (4K). Caso contrário, podem ocorrer problemas de desempenho. Portanto, é necessário criar volumes com os parâmetros adequados:
parted /dev/mapper/device-name mklabel gpt mkpart primary 2048s 100% align-check optimal 1
Distribuição de bancos de dados nos volumes criados para nossa configuração de teste
Nome do volume de armazenamento
Tamanho do volume
Mapeamento de LUNs de Volume
Detalhe do Dispositivo de Volume ASM
Tamanho da Unidade de Alocação
Data01
200GB
Mapear todos os volumes de armazenamento para todos os ports de dados do sistema de armazenamento
Redundância: Normal
Nome: DGDATA
Finalidade: Arquivos de dados
4MB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Redundância: Normal
Nome: DGGRID1
Finalidade: Grid: CRS e Votação
4MB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Redundância: Normal
Nome: DGGRID2
Finalidade: Grid: CRS e Votação
4MB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redundância: Normal
Nome: DGREDO1
Finalidade: Log de redo da thread 1
4MB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redundância: Normal
Nome: DGREDO2
Finalidade: Log de redo da thread 2
4MB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Configurações do banco de dados
- Tamanho do bloco = 8K
- Espaço de swap = 16GB
- Desativar AMM (Gerenciamento Automático de Memória)
- Desativar Transparent Huge Pages
Outras configurações
# vi /etc/sysctl.conf
✓ fs.aio-max-nr = 1048576
✓ fs.file-max = 6815744
✓ kernel.shmmax 103079215104
✓ kernel.shmall 31457280
✓ kernel.shmmn 4096
✓ kernel.sem = 250 32000 100 128
✓ net.ipv4.ip_local_port_range = 9000 65500
✓ net.core.rmem_default = 262144
✓ net.core.rmem_max = 4194304
✓ net.core.wmem_default = 262144
✓ net.core.wmem_max = 1048586
✓ vm.swappiness=10
✓ vm.min_free_kbytes=524288 # não configure isso se estiver usando Linux x86
✓ vm.vfs_cache_pressure=200
✓ vm.nr_hugepages = 57000
# vi /etc/security/limits.conf
✓ grid soft nproc 2047
✓ grid hard nproc 16384
✓ grid soft nofile 1024
✓ grid hard nofile 65536
✓ grid soft stack 10240
✓ grid hard stack 32768
✓ oracle soft nproc 2047
✓ oracle hard nproc 16384
✓ oracle soft nofile 1024
✓ oracle hard nofile 65536
✓ oracle soft stack 10240
✓ oracle hard stack 32768
✓ soft memlock 120795954
✓ hard memlock 120795954
sqlplus “/as sysdba”
alter system set processes=2000 scope=spfile;
alter system set open_cursors=2000 scope=spfile;
alter system set session_cached_cursors=300 scope=spfile;
alter system set db_files=8192 scope=spfile;
Teste de resistência à falha
Para demonstração foi utilizado o HammerDB para simular carga OLTP. Configuração do HammerDB:
Número de Armazéns
256
Total de Transações por Usuário
1000000000000
Usuários Virtuais
256
O resultado foi 2.1M TPM, que está longe do limite de desempenho do array , mas é o “teto” para a atual configuração de hardware dos servidores (principalmente devido aos processadores) e sua quantidade. O objetivo deste teste ainda é demonstrar a resistência do sistema como um todo, e não alcançar máximos de desempenho. Portanto, vamos apenas partir deste número.
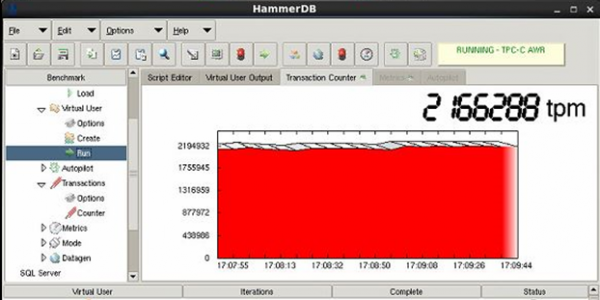
Teste de falha de uma das nós
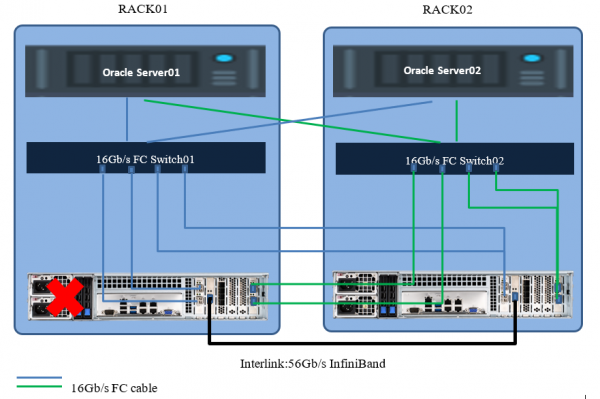
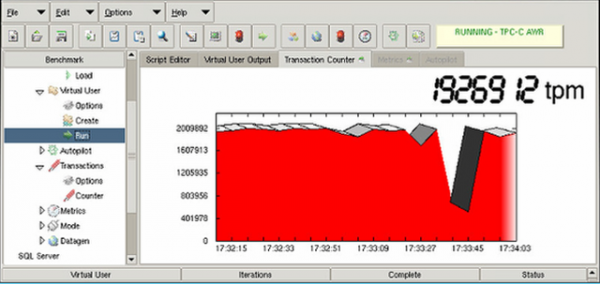
Os hosts perderam parte dos caminhos para o armazenamento, continuando a operar através dos que restaram com o segundo nó. O desempenho caiu por alguns segundos devido à reconfiguração dos caminhos, e em seguida voltou aos níveis normais. Não houve interrupção no serviço.
Teste de falha do armário com todo o equipamento
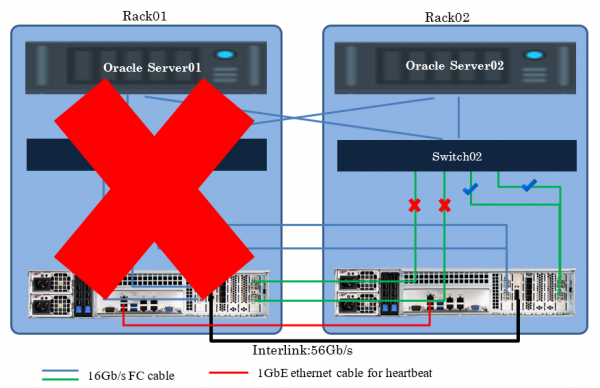
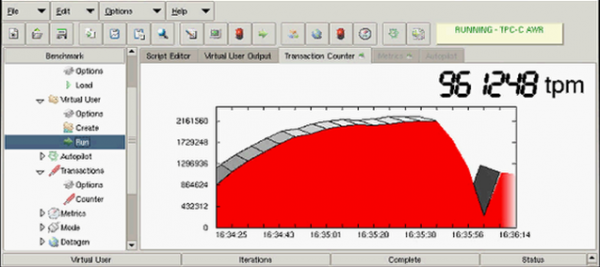
Neste caso, o desempenho também caiu por alguns segundos devido à reconfiguração dos caminhos, e depois voltou a metade do valor original. O resultado caiu para metade do inicial devido à inatividade de um servidor de aplicativos. Também não houve interrupção no serviço.
Se houver necessidades para implementar uma solução de recuperação de desastres Cross-Rack com alta disponibilidade para Oracle a um custo razoável e com poucos esforços de implantação/administrativo, a colaboração entre Oracle RAC e a arquitetura será uma das melhores opções. No lugar do Oracle RAC, pode haver qualquer outro software que suporte a clustering, como os mesmos bancos de dados ou sistemas de virtualização, por exemplo. O princípio de construção da solução permanecerá o mesmo. E o indicador final é um valor zero para RTO e RPO.
Fonte: habr.com
