

A tradução do artigo foi preparada especialmente para os alunos do curso .
Nas últimas semanas, nós com adicionamos ao formato binário de transmissão, complementando o já existente formato de arquivo de acesso aleatório / IPC. Temos implementações em Java e C++ e bindings para Python. Neste artigo, explicarei como funciona o formato e mostrarei como é possível alcançar uma taxa de transferência de dados muito alta para DataFrames pandas.
Transmissão de dados em colunas
Uma pergunta comum que recebo dos usuários do Arrow é sobre o alto custo de transferir grandes conjuntos de dados em formato de linha ou registro para um formato colunar. Para conjuntos de dados de vários gigabytes, a transposição na memória ou no disco pode ser uma tarefa impossível.
Para a transmissão de dados, independentemente de os dados de origem serem em linha ou coluna, uma das opções é enviar pequenos pacotes de linhas, cada um contendo a configuração em colunas.
No Apache Arrow, a coleção de arrays colunares na memória, representando um bloco de tabela, é chamada de lote de registros (record batch). Para representar uma única estrutura de dados de uma tabela lógica, pode-se juntar vários lotes de registros.
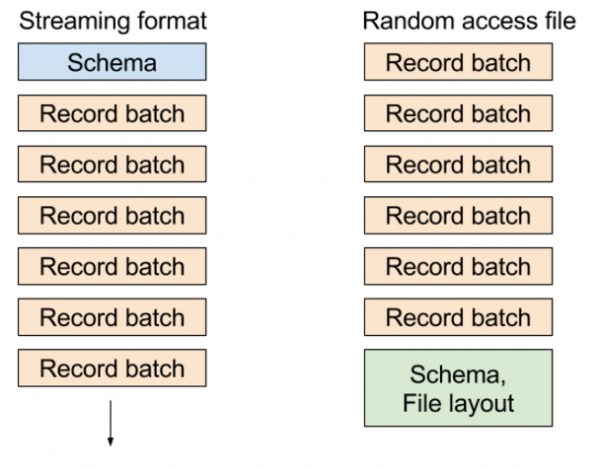
No formato de arquivo existente de "acesso aleatório", gravamos metadados que contêm o esquema da tabela e a localização dos blocos no final do arquivo, permitindo que você selecione qualquer lote de registros ou qualquer coluna do conjunto de dados de forma extremamente barata. No formato de transmissão, enviamos uma série de mensagens: o esquema, seguido de um ou mais lotes de registros.
Os diferentes formatos parecem aproximadamente como apresentado nesta figura:
Transmissão de dados no PyArrow: aplicação
Para mostrar como isso funciona, criarei um exemplo de conjunto de dados que representa um bloco de transmissão:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })
Agora, vamos supor que queremos gravar 1 GB de dados, consistindo de blocos de 1 MB cada, totalizando 1024 blocos. Para começar, vamos criar o primeiro DataFrame de 1 MB com 16 colunas:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Em seguida, eu os converto para pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Agora vou criar um fluxo de saída que será escrito na memória e criar StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Em seguida, gravaremos 1024 chunks, que totalizarão 1GB de dados:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Como escrevemos na RAM, conseguiremos obter todo o fluxo em um único buffer:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Como esses dados estão na memória, a leitura dos pacotes de registros Arrow resulta em uma operação zero-copy. Eu abro o StreamReader e leio os dados em pyarrow.Table, e então os converto em DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
Tudo isso é ótimo, mas você pode ter algumas perguntas. Quão rápido isso acontece? Como o tamanho do chunk afeta o desempenho da obtenção do DataFrame pandas?
Desempenho da transmissão de dados
À medida que o tamanho do chunk da transmissão diminui, o custo de reconstrução do quadro colunar contínuo do DataFrame em pandas aumenta devido a esquemas de acesso à memória cache ineficientes. Também há algumas sobrecargas devido ao trabalho com estruturas de dados C++ e seus buffers de memória.
Para 1MB, como indicado acima, no meu laptop (Quad-core Xeon E3-1505M) obtivemos:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 loops, best of 3: 129 ms per loop
Isso resulta em uma largura de banda efetiva de 7.75 GB/s para restaurar um DataFrame de 1GB a partir de 1024 chunks de 1MB. O que acontece se usarmos chunks maiores ou menores? Aqui estão os resultados:
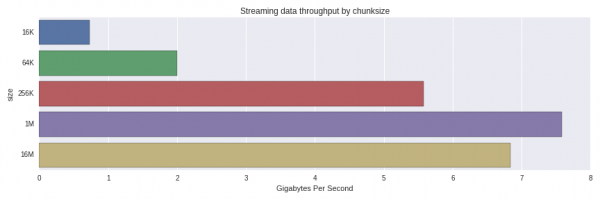
O desempenho diminui significativamente de 256K para 64K chunks. Fiquei surpreso ao ver que chunks de 1MB eram processados mais rapidamente do que 16MB. É necessário fazer uma investigação mais detalhada para entender se isso é uma distribuição normal ou se há algo mais em jogo.
Na implementação atual do formato, os dados não são comprimidos, então o tamanho na memória e "nos cabos" é aproximadamente o mesmo. No futuro, a compressão pode se tornar uma opção adicional.
Resultado
A transmissão de dados em colunas pode ser uma maneira eficaz de transferir grandes conjuntos de dados para ferramentas analíticas em colunas, como o pandas, através de pequenos blocos. Serviços de dados que utilizam armazenamento orientado a linhas podem transmitir e transpor pequenos blocos de dados que são mais amigáveis para o cache L2 e L3 do seu processador.
Código completo
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Fonte: habr.com
