

Olá, Habr.
Recentemente, eu sobre quais parâmetros usamos com mais frequência em nossa equipe para Kafka Producer e Consumer, a fim de nos aproximarmos da entrega garantida. Neste artigo, quero explicar como organizamos a reprocessamento de eventos recebidos do Kafka em resultado da indisponibilidade temporária de um sistema externo.
Aplicativos modernos operam em um ambiente muito complexo. A lógica de negócios, envolta em uma pilha tecnológica moderna, funcionando em uma imagem Docker, que é gerenciada por um orquestrador como Kubernetes ou OpenShift, e se comunicando com outros aplicativos ou soluções empresariais através de uma cadeia de roteadores físicos e virtuais. Em tal ambiente, sempre pode haver algo que quebre, portanto o reprocessamento de eventos em caso de indisponibilidade de um dos sistemas externos é uma parte importante dos nossos processos de negócios.
Como era antes do Kafka
Anteriormente, no projeto, utilizávamos IBM MQ para entrega assíncrona de mensagens. Quando ocorria algum erro no processo de funcionamento do serviço, a mensagem recebida poderia ser colocada em uma dead-letter-queue (DLQ) para posterior análise manual. A DLQ era criada ao lado da fila de entrada, e a realocação da mensagem ocorria dentro do IBM MQ.
Se o erro era temporário e conseguíamos identificá-lo (por exemplo, ResourceAccessException durante uma chamada HTTP ou MongoTimeoutException durante uma consulta no MongoDb), então entrava em vigor a estratégia de tentativas. Independentemente da ramificação da lógica do aplicativo, a mensagem original era realocada para uma fila sistêmica para envio adiado ou para um aplicativo separado que havia sido criado há muito tempo para reenviar mensagens. Nesse caso, o número da tentativa de reenvio era gravado no cabeçalho da mensagem, vinculado ao intervalo de atraso ou ao fim da estratégia a nível de aplicativo. Se chegássemos ao fim da estratégia, mas o sistema externo ainda estivesse indisponível, a mensagem seria colocada na DLQ para análise manual.
Busca pela solução
, pode-se encontrar o seguinte . Em resumo, propõe-se criar um tópico para cada intervalo de atraso e implementar, do lado do aplicativo, Consumers que lerão mensagens com o atraso necessário.
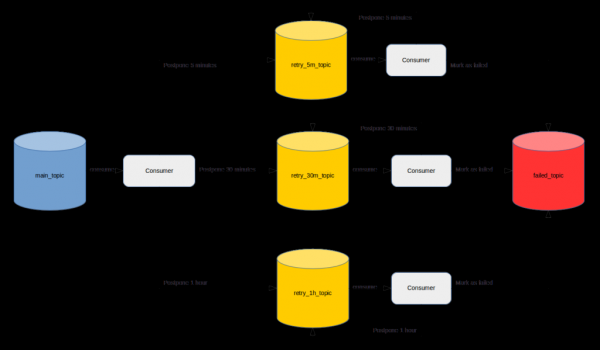
Apesar de haver muitos comentários positivos, não me parece totalmente satisfatório. Principalmente porque o desenvolvedor, além de implementar os requisitos de negócios, terá que investir muito tempo na implementação do mecanismo descrito.
Além disso, se o gerenciamento de acesso estiver habilitado no cluster Kafka, será necessário dedicar algum tempo para criar tópicos e garantir os acessos necessários a eles. Além disso, será preciso escolher o parâmetro correto retention.ms para cada um dos tópicos de retry, para que as mensagens consigam ser reenviadas a tempo e não desapareçam. A implementação e a solicitação de acessos terão que ser repetidas para cada serviço existente ou novo.
Vamos agora ver quais mecanismos de reprocessamento de mensagens o Spring nos oferece em geral e o spring-kafka em particular. O spring-kafka tem uma dependência transitiva do spring-retry, que fornece abstrações para gerenciar diferentes BackOffPolicy. É uma ferramenta bastante flexível, mas sua desvantagem significativa é o armazenamento de mensagens para reenvio na memória da aplicação. Isso significa que a reinicialização da aplicação devido a uma atualização ou a um erro durante a execução resultará na perda de todas as mensagens que estão aguardando reprocessamento. Como este ponto é crítico para o nosso sistema, não continuamos a explorá-lo.
O próprio spring-kafka oferece várias implementações de ContainerAwareErrorHandler, por exemplo, , que permite que, sem deslocar o offset em caso de erro, a mensagem seja processada mais tarde. A partir da versão spring-kafka 2.3, surgiu a possibilidade de definir BackOffPolicy.
Esta abordagem permite que as mensagens reprocessadas sobrevivam à reinicialização da aplicação, mas o mecanismo DLQ ainda está ausente. Foi essa opção que escolhemos no início de 2019, otimistamente acreditando que o DLQ não seria necessário (tivemos sorte e ele realmente não foi necessário durante vários meses de operação da aplicação com esse sistema de reprocessamento). Erros temporários resultaram na ativação do SeekToCurrentErrorHandler. Os demais erros eram registrados no log, resultavam no deslocamento do offset, e o processamento continuava com a próxima mensagem.
Solução final
A implementação baseada em SeekToCurrentErrorHandler nos levou a desenvolver nosso próprio mecanismo para reenvio de mensagens.
Acima de tudo, queríamos aproveitar a experiência existente e expandi-la de acordo com a lógica do aplicativo. Para um aplicativo com lógica linear, seria ideal interromper a leitura de novas mensagens por um curto período determinado na estratégia de tentativas. Para outros aplicativos, gostaríamos de ter um único ponto que garantisse a execução da estratégia de tentativas. Além disso, esse único ponto deve ter a funcionalidade de DLQ para ambas as abordagens.
A própria estratégia de tentativas deve ser armazenada no aplicativo que é responsável por obter o próximo intervalo em caso de um erro temporário.
Parar o Consumer para aplicativos com lógica linear
Ao trabalhar com spring-kafka, o código para parar o Consumer pode parecer assim:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // para DLQ
    }
No exemplo, retryAt é o tempo em que o MessageListenerContainer deve ser reiniciado, se ainda estiver em execução. O reinício ocorrerá em uma thread separada, iniciada no TaskScheduler, cuja implementação também é fornecida pelo spring.
O valor de retryAt é encontrado da seguinte forma:
- Buscamos o valor do contador de tentativas.
- De acordo com o valor do contador, buscamos o intervalo de atraso atual na estratégia de tentativas. A estratégia é declarada no próprio aplicativo, para seu armazenamento escolhemos o formato JSON.
- O intervalo encontrado no array JSON contém o número de segundos após os quais a reprocessamento deve ser repetido. Esse número de segundos é adicionado ao tempo atual, formando o valor para retryAt.
- Se o intervalo não for encontrado, o valor de retryAt será null e a mensagem será enviada para a DLQ para análise manual.
Com essa abordagem, resta apenas manter a contagem de chamadas repetidas para cada mensagem que está atualmente em processamento, por exemplo, na memória do aplicativo. Manter o contador de tentativas na memória não é crítico para essa abordagem, uma vez que um aplicativo com lógica linear não pode realizar o processamento como um todo. Ao contrário do spring-retry, a reinicialização do aplicativo não resultará na perda de todas as mensagens para reprocessamento, mas simplesmente relançará a estratégia.
Essa abordagem ajuda a aliviar a carga sobre o sistema externo, que pode estar indisponível devido a uma carga muito grande. Em outras palavras, além do reprocessamento, conseguimos implementar o padrão. .
No nosso caso, o limite de erro é de apenas 1, e para minimizar o tempo de inatividade do sistema devido a uma interrupção temporária na rede, usamos uma estratégia de tentativas de chamadas muito granular com pequenos intervalos de atraso. Isso pode não ser adequado para todas as aplicações do grupo, portanto, a relação entre o limite de erro e o tamanho do intervalo precisa ser ajustada com base nas características do sistema.
Um aplicativo separado para processar mensagens de aplicativos com lógica não determinística.
Aqui está um exemplo de código que envia uma mensagem para tal aplicativo (Retryer), que reenvia para o tópico DESTINATION ao atingir o tempo RETRY_AT:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
Do exemplo, pode-se ver que muitas informações são transmitidas nos cabeçalhos. O valor RETRY_AT está presente da mesma forma que para o mecanismo de repetição através da parada do Consumer. Além do DESTINATION e RETRY_AT, também transmitimos:
- GROUP_ID, pelo qual agrupamos mensagens para análise manual e facilitamos a busca.
- ORIGINAL_PARTITION, para tentar manter o mesmo Consumer para reprocessamento. Este parâmetro pode ser nulo, caso em que uma nova partition será obtida pela chave record.key() da mensagem original.
- Valor atualizado de COUNTER, para seguir a estratégia de reenvios.
- SEND_TO — constante que indica se a mensagem deve ser reenviada para reprocessamento ao atingir RETRY_AT ou colocada em DLQ.
- REASON — a razão pela qual o processamento da mensagem foi interrompido.
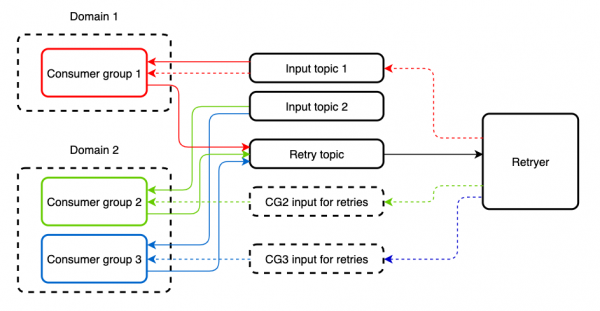
Retryer armazena mensagens para reenvio e análise manual no PostgreSQL. Um cron job é acionado para encontrar mensagens cujo RETRY_AT já foi atingido e enviá-las de volta para a partition ORIGINAL_PARTITION do tópico DESTINATION com a chave record.key().
Após o envio, as mensagens são removidas do PostgreSQL. A análise manual das mensagens ocorre em uma interface simples, que interage com o Retryer através da API REST. Suas principais características incluem reenvio ou remoção de mensagens da DLQ, visualização de informações de erro e busca de mensagens, por exemplo, por nome de erro.
Como o controle de acesso está ativado em nossos clusters, é necessário solicitar permissões adicionais para o tópico que o Retryer escuta e permitir que o Retryer escreva no tópico DESTINATION. Isso é inconveniente, mas, ao contrário da abordagem de tópico por intervalo, temos uma DLQ completa e uma interface para gerenciá-la.
Existem situações em que o tópico de entrada é lido por vários grupos de consumidores diferentes, cujos aplicativos implementam diferentes lógicas. O reprocessamento de uma mensagem através do Retryer para um desses aplicativos resultará em um duplicado para o outro. Para se proteger contra isso, criamos um tópico separado para reprocessamento. O tópico de entrada e o tópico de retry podem ser lidos pelo mesmo Consumer sem restrições.
Por padrão, essa abordagem não fornece a funcionalidade de um disjuntor, mas ela pode ser adicionada ao aplicativo usando ou o novo , envolvendo os pontos de chamada dos serviços externos nas abstrações correspondentes. Além disso, há a possibilidade de escolher a estratégia para o padrão, o que também pode ser útil. Por exemplo, em spring-cloud-netflix isso pode ser um thread pool ou um semáforo.
Saída
Como resultado, temos um aplicativo separado que permite repetir o processamento de mensagens quando um sistema externo está temporariamente indisponível.
Uma das principais vantagens do aplicativo é que sistemas externos operando no mesmo cluster Kafka podem utilizá-lo sem grandes adaptações de sua parte! O aplicativo precisa apenas acessar o tópico de retry, preencher alguns cabeçalhos Kafka e enviar a mensagem para o Retryer. Não é necessário implantar nenhuma infraestrutura adicional. Para reduzir o número de mensagens deslocadas entre o aplicativo e o Retryer, isolamos os aplicativos com lógica linear e implementamos a reprocessamento através da pausa do Consumer.
Fonte: habr.com
