

Nota de tradução: este é um tradução do post mortem público do blog de engenharia da empresa . Nele, descreve-se o problema com o conntrack no cluster Kubernetes, que levou a uma interrupção parcial de alguns serviços em produção.
Este artigo pode ser útil para quem deseja saber um pouco mais sobre post mortems ou prevenir alguns problemas potenciais com DNS no futuro.
Não é DNS
Não pode ser que seja DNS
Era DNS
Um pouco sobre post mortems e processos na Preply
No post mortem, descreve-se uma falha de operação ou qualquer evento em produção. O post mortem inclui uma cronologia de eventos, descrição do impacto no usuário, causa raiz, ações e lições aprendidas.
Nas reuniões semanais com pizza, em um círculo de equipe técnica, compartilhamos diversas informações. Uma das partes mais importantes dessas reuniões são os post mortems, que geralmente são acompanhados de apresentações em slides e uma análise mais profunda do incidente ocorrido. Apesar de não 'aplaudirmos' após os post mortems, nos esforçamos para promover uma cultura de 'sem culpa' (). Acreditamos que escrever e apresentar post mortems pode nos ajudar (e não só) a prevenir incidentes semelhantes no futuro, é por isso que os compartilhamos.
As pessoas envolvidas no incidente devem sentir que podem falar sobre ele em detalhes, sem medo de punição ou retaliação. Nada de reprovação! A escrita do post mortem não é uma punição, mas uma oportunidade de aprendizado para toda a empresa.
Problemas de DNS no Kubernetes. Post mortem
Data: 28.02.2020
Autores: Amet U., Andrei S., Igor K., Alexey P.
Status: Concluído
Resumindo: Indisponibilidade parcial do DNS (26 min) para alguns serviços no cluster Kubernetes
Impacto: 15000 eventos perdidos para os serviços A, B e C
Causa raiz: O Kube-proxy não conseguiu remover corretamente a antiga entrada da tabela conntrack, portanto, alguns serviços ainda tentaram se conectar a pods inexistentes
E0228 20:13:53.795782 1 proxier.go:610] Falha ao excluir kube-system/kube-dns:dns endpoint connections, erro: erro ao excluir as entradas do conntrack para o par UDP {100.64.0.10, 100.110.33.231}, erro: comando do conntrack retornou: ...Gatilho: Devido à baixa carga dentro do cluster Kubernetes, o CoreDNS-autoscaler reduziu o número de pods no deployment de três para dois
Solução: Um novo deploy da aplicação iniciou a criação de novos nós, o CoreDNS-autoscaler adicionou mais pods para atender ao cluster, o que provocou a reescrita da tabela conntrack
Detecção: A monitoração do Prometheus detectou um grande número de erros 5xx para os serviços A, B e C e acionou uma chamada para os engenheiros de plantão
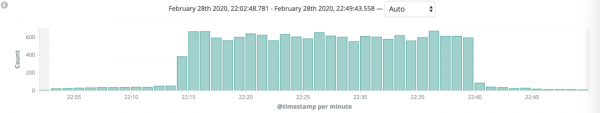
Erros 5xx no Kibana
Ações
Ação
Tipo
Responsável
Tarefa
Desativar autoscaler para CoreDNS
prev.
Amet U.
DEVOPS-695
Configurar servidor DNS cache
reduz.
Max V.
DEVOPS-665
Configurar monitoração conntrack
prev.
Amet U.
DEVOPS-674
Lições aprendidas
O que correu bem:
- A monitoração funcionou claramente. A resposta foi rápida e organizada
- Não enfrentamos nenhum limite nos nós
O que não foi bem:
- A verdadeira causa raiz ainda é desconhecida, parece ser no conntrack
- Todas as ações corrigem apenas as consequências, não a causa raiz (bug)
- Sabíamos que mais cedo ou mais tarde poderíamos ter problemas com DNS, mas não priorizamos as tarefas
Onde tivemos sorte:
- Um novo deploy acionou o CoreDNS-autoscaler, que reescreveu a tabela conntrack
- Esse bug afetou apenas uma parte dos serviços
Cronologia (EET)
Tempo
Ação
22:13
O CoreDNS-autoscaler reduziu o número de pods de três para dois
22:18
Os engenheiros de plantão começaram a receber chamadas do sistema de monitoração
22:21
Os engenheiros de plantão começaram a investigar a causa dos erros
22:39
Os engenheiros de plantão começaram a reverter um dos últimos serviços para a versão anterior
22:40
Os erros 5xx deixaram de aparecer, a situação estabilizou
- Tempo até a detecção: 4 min
- Tempo até a ação: 21 min
- Tempo até a correção: 1 min
Informações adicionais
- Logs do CoreDNS:
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Reduzido o conjunto de réplicas coredns-6cbb6646c9 para 2 - Links para Kibana (cortado), Grafana (cortado)
Para minimizar o uso da CPU, o kernel Linux utiliza uma coisa chamada conntrack. Resumidamente, é uma ferramenta que contém uma lista de entradas NAT, que são armazenadas em uma tabela especial. Quando um próximo pacote chega do mesmo pod para o mesmo pod como antes, o IP final não será recalculado, mas será retirado da tabela conntrack.
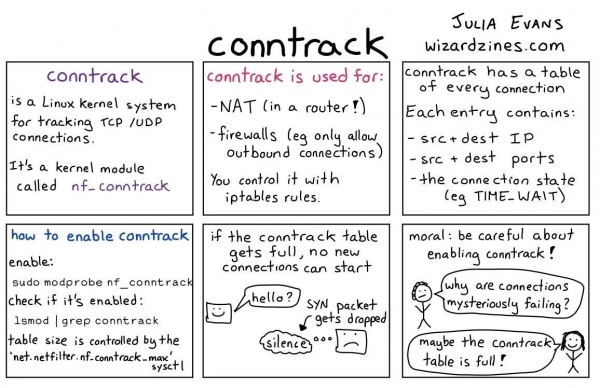
Como funciona o conntrack
Resultados
Este foi um exemplo de um dos nossos post-mortems com alguns links úteis. Especificamente neste artigo, compartilhamos informações que podem ser valiosas para outras empresas. É por isso que não temos medo de cometer erros e é por isso que tornamos um de nossos post-mortems público. Aqui estão mais alguns post-mortems públicos interessantes:
- GitLab:
- Dropbox:
- Spotify:
- Muitos outros deste e repositório
- Além disso post-mortem público com o SRE Book
Fonte: habr.com
