

Esta história é sobre como usamos contêineres em um ambiente de produção, especialmente sob Kubernetes. O artigo se dedica à coleta de métricas e logs de contêineres, bem como à criação de imagens.
Somos da empresa fintech Exness, que desenvolve serviços para negociação online e produtos fintech para B2B e B2C. Em nosso R&D, temos várias equipes, e no departamento de desenvolvimento, somos mais de 100 funcionários.
Apresentamos a equipe responsável pela plataforma de coleta e execução de código por nossos desenvolvedores. Em particular, somos responsáveis pela coleta, armazenamento e fornecimento de métricas, logs e eventos de aplicações. Atualmente, operamos cerca de três mil contêineres Docker em um ambiente de produção, mantemos nosso armazenamento de big data com 50 TB e fornecemos soluções arquitetônicas que são construídas em torno de nossa infraestrutura: Kubernetes, Rancher e vários provedores de nuvem pública.
Nossa motivação
O que está pegando fogo? Ninguém consegue responder. Onde está o foco? Difícil entender. Quando pegou fogo? É possível descobrir, mas não imediatamente.
Por que alguns contêineres caem enquanto outros permanecem? Qual contêiner causou isso? Afinal, por fora os contêineres são iguais, mas por dentro cada um possui seu próprio Neo.
Nossos desenvolvedores são caras competentes. Eles criam bons serviços que trazem lucro para a empresa. Mas ocorrem falhas, quando os contêineres com aplicações ficam desordenados. Um contêiner consome muita CPU, outro consome rede, o terceiro realiza operações de entrada e saída, e o quarto faz algo incompreensível com os sockets. Tudo isso falha, e o barco afunda.
Agentes
Para entender o que está acontecendo internamente, decidimos instalar agentes diretamente nos contêineres.
Esses agentes são programas controladores que mantêm os contêineres em um estado que não os deixe quebrar uns aos outros. Os agentes são padronizados, e isso permite padronizar a abordagem de manutenção dos contêineres.
No nosso caso, os agentes devem fornecer logs em um formato padrão, etiquetados e com controle de taxa. Eles também devem nos fornecer métricas padronizadas, expansíveis do ponto de vista de aplicações de negócios.
Sob os agentes, também entendemos utilitários para operação e manutenção, que podem trabalhar em diferentes sistemas de orquestração, suportando diferentes imagens (Debian, Alpine, CentOS, etc.).
Finalmente, os agentes devem manter um CI/CD simples, incluindo arquivos Docker. Caso contrário, o sistema criará problemas, pois os contêineres começarão a ser entregues em "trilhos" defeituosos.
O processo de construção e a configuração da imagem alvo
Para garantir que tudo seja padronizado e gerenciável, é necessário seguir algum processo de construção padrão. Portanto, decidimos construir contêineres com contêineres — uma verdadeira recursão.
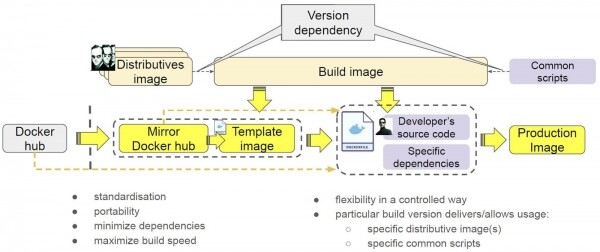
Aqui, os contêineres são representados por contornos sólidos. Também decidimos incluir distribuições neles, para que "a vida não pareça tão doce". Vamos explicar abaixo por que isso foi feito.
O resultado foi uma ferramenta de construção — um contêiner de versão específica que referencia versões específicas de distribuições e versões específicas de scripts.
Como aplicamos isso? Temos o Docker Hub, onde está o contêiner. O espelhamos dentro do nosso sistema para nos livrarmos de dependências externas. Assim, conseguimos um contêiner marcado em amarelo. Criamos um modelo para instalar todas as distribuições e scripts necessários no contêiner. Depois, montamos a imagem pronta para uso: os desenvolvedores adicionam seu código e algumas dependências especiais.
Quais são as vantagens dessa abordagem?
- Em primeiro lugar, controle total de versão das ferramentas de construção – contêiner de construção, versões de scripts e distribuições.
- Em segundo lugar, conseguimos padronização: criamos modelos, imagens intermediárias e prontas para uso de forma idêntica.
- Em terceiro lugar, os contêineres nos proporcionam portabilidade. Hoje usamos Gitlab, e amanhã poderemos mudar para TeamCity ou Jenkins e ainda assim executar nossos contêineres da mesma forma.
- Em quarto lugar, minimização de dependências. Não é por acaso que incluímos distribuições no contêiner, pois isso evita o download delas a cada vez da Internet.
- Em quinto lugar, a velocidade de construção aumentou – a presença de cópias locais das imagens evita gastar tempo em downloads, já que existe uma imagem local.
Em outras palavras, alcançamos um processo de construção controlado e flexível. Usamos as mesmas ferramentas para construir quaisquer contêineres com versionamento completo.
Como funciona nosso procedimento de construção?
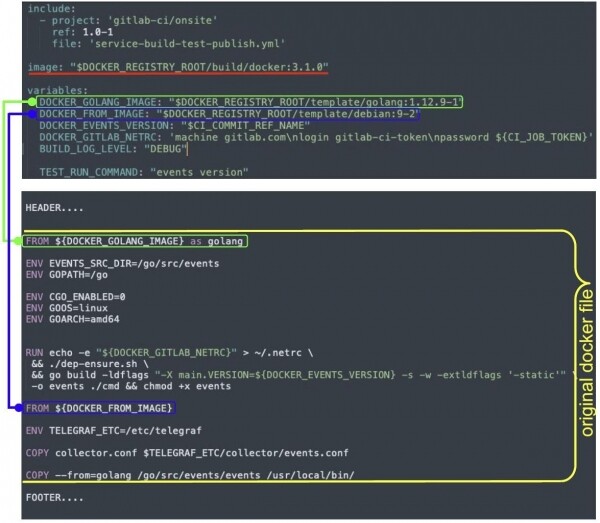
A construção é iniciada com um único comando, e o processo é executado em uma imagem (destacada em vermelho). O desenvolvedor possui um arquivo Docker (destacado em amarelo), e o renderizamos substituindo as variáveis pelos valores. E, ao mesmo tempo, adicionamos headers e footers — são nossos agentes.
O header adiciona distribuições das imagens correspondentes. O footer instala nossos serviços, configura o início da carga de trabalho, logging e outros agentes, substituindo o entrypoint, etc.
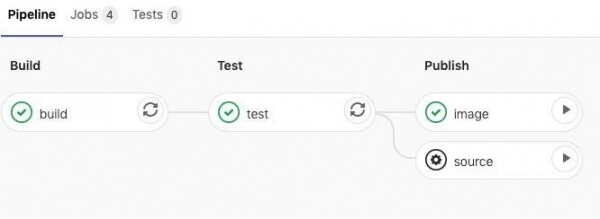
Pensamos muito se deveríamos usar um supervisor. No fim, decidimos que precisaríamos dele. Escolhemos o S6. O supervisor fornece gerenciamento de contêiner: permite conectar-se a ele em caso de falha do processo principal e possibilita o gerenciamento manual do contêiner sem a necessidade de recriá-lo. Logs e métricas são processos executados dentro do contêiner. Também precisamos controlá-los de alguma forma, e fazemos isso com a ajuda do supervisor. Por fim, o S6 cuida da manutenção, tratamento de sinais e outras tarefas.
Como utilizamos diferentes sistemas de orquestração, após a construção e o início, o contêiner deve entender em qual ambiente se encontra e agir de acordo. Por exemplo:
Isso nos permite construir uma imagem e executá-la em diferentes sistemas de orquestração, sendo que a execução levará em conta as particularidades desse sistema de orquestração.
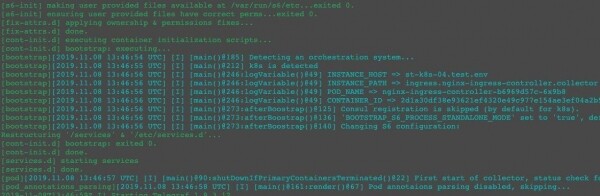
Para o mesmo contêiner, obtemos diferentes árvores de processos no Docker e Kubernetes:
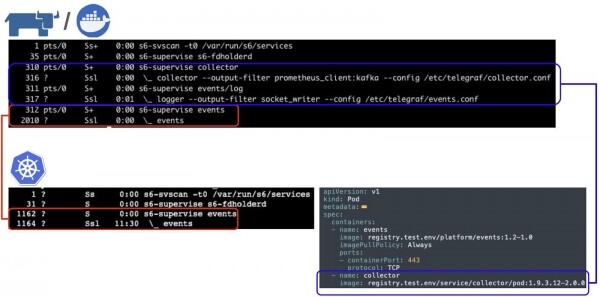
A carga útil é executada sob o supervisor S6. Observe o collector e os events — são nossos agentes responsáveis pelos logs e métricas. No Kubernetes, eles não existem, mas no Docker existem. Por quê?
Se olharmos a especificação do "pod" (daqui em diante – pod do Kubernetes), veremos que o contêiner events é executado no pod, onde há um contêiner collector separado, que desempenha a função de coletar métricas e logs. Podemos utilizar os recursos do Kubernetes: iniciar contêineres em um único pod, em um único espaço de processos e/ou rede. Efetivamente, implementar nossos agentes e executar algumas funções. E se esse mesmo contêiner for iniciado no Docker, ele terá todas as mesmas capacidades, ou seja, poderá fornecer logs e métricas, pois os agentes serão executados dentro dele.
Métricas e logs
A entrega de métricas e logs é uma tarefa complexa. Sua resolução envolve vários aspectos.
A infraestrutura é criada para executar cargas úteis, e não para a entrega massiva de logs. Isso significa que esse processo deve ser realizado com requisitos mínimos de recursos dos contêineres. Estamos empenhados em ajudar nossos desenvolvedores: "Pegue um contêiner do Docker Hub, execute-o, e conseguiremos entregar os logs."
O segundo aspecto é a limitação do volume de logs. Se em vários contêineres ocorrer uma situação de pico no volume de logs (um aplicativo em loop imprime stack-trace), a carga sobre a CPU, canais de comunicação e o sistema de processamento de logs aumenta, e isso impacta o desempenho do host como um todo e outros contêineres no host, levando ocasionalmente ao 'quebra' do host.
O terceiro aspecto é a necessidade de suportar o maior número possível de metodologias de coleta de métricas desde o início. Isso inclui leitura de arquivos e consultas a pontos finais do Prometheus, até o uso de protocolos específicos de aplicativos.
E o último aspecto é a necessidade de minimizar o consumo de recursos.
Escolhemos uma solução open-source em Go chamada Telegraf. Este é um conector versátil que suporta mais de 140 tipos de canais de entrada (input plugins) e 30 tipos de saída (output plugins). Nós o aprimoramos e agora vamos explicar como ele é utilizado entre nós no exemplo do Kubernetes.
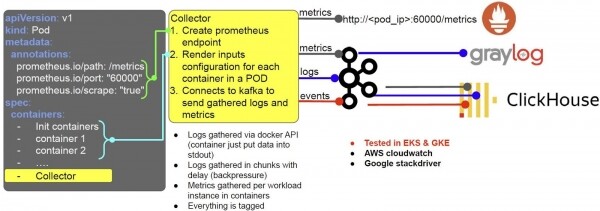
Suponhamos que um desenvolvedor implante uma carga de trabalho, e o Kubernetes receba um pedido para criar um pod. Nesse momento, para cada pod, um contêiner chamado Collector é criado automaticamente (usamos um webhook de mutação). O Collector é nosso agente. Ao iniciar, este contêiner se configura para operar com o Prometheus e o sistema de coleta de logs.
- Para isso, ele utiliza anotações do pod, e dependendo do seu conteúdo, cria, por exemplo, um ponto final do Prometheus;
- Com base na especificação do pod e nas configurações específicas dos contêineres, determina como entregar os logs.
Coletamos logs através da API do Docker: os desenvolvedores precisam apenas colocá-los em stdout ou stderr, e o Collector se encarregará do restante. Os logs são coletados em partes com algum atraso para evitar uma possível sobrecarga do host.
As métricas são coletadas com base nas instâncias de carga de trabalho (processos) nos contêineres. Tudo é marcado com tags: namespace, pod e assim por diante, e então é convertido para o formato do Prometheus – tornando-se disponível para coleta (exceto logs). Além disso, logs, métricas e eventos são enviados para Kafka e além:
- Os logs estão disponíveis no Graylog (para análise visual);
- Logs, métricas e eventos são enviados ao Clickhouse para armazenamento a longo prazo.
Da mesma forma, tudo funciona na AWS, mas substituímos Graylog com Kafka pelo Cloudwatch. Enviamos os logs para lá, e tudo fica muito conveniente: é fácil entender a que cluster e contêiner eles pertencem. O mesmo se aplica ao Google Stackdriver. Portanto, nosso esquema funciona tanto on-premise com Kafka quanto na nuvem.
Se não temos Kubernetes com pods, o esquema se torna um pouco mais complicado, mas ainda opera pelos mesmos princípios.
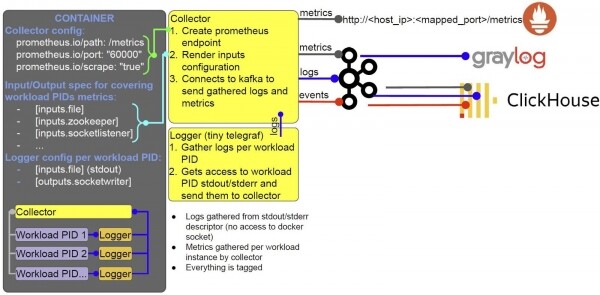
Dentro do contêiner, processos idênticos são executados, orquestrados pelo S6. Todos os mesmos processos estão rodando dentro de um único contêiner.
Como resultado,
Criamos uma solução integrada para construir e implantar imagens, com opções para coletar e entregar logs e métricas:
- Desenvolvemos uma abordagem padronizada para a construção de imagens e, com isso, templates de CI;
- Os agentes para coleta de dados são nossas extensões Telegraf. Testamos bem em produção;
- Utilizamos um webhook de mutação para implementar contêineres com agentes em pods;
- Integramos à ecossistema Kubernetes/Rancher;
- Podemos executar os mesmos contêineres em diferentes sistemas de orquestração e obter os resultados esperados;
- Criamos uma configuração totalmente dinâmica para gerenciamento de contêineres.
Coautor: Ilya Prudnikov
Fonte: habr.com
