

O futuro chegou, as tecnologias de inteligência artificial e aprendizado de máquina já estão sendo utilizadas com sucesso por suas lojas favoritas, empresas de transporte e até mesmo fazendas que criam perus.
E se algo existe, então já deve haver algo na internet sobre isso... um projeto aberto! Veja como o Open Data Hub ajuda a escalar novas tecnologias e evitar dificuldades em sua implementação.
Apesar de todas as vantagens da inteligência artificial (artificial Intelligence, AI) e do aprendizado de máquina (machine learning, ML), as organizações frequentemente enfrentam dificuldades em escalar essas tecnologias. Os principais problemas geralmente são os seguintes:
- Troca de informações e colaboração – trocar informações sem esforço e colaborar em iterações rápidas é praticamente impossível.
- Acesso a dados – para cada tarefa, ele precisa ser construído do zero e manualmente, o que consome muito tempo.
- Acesso sob demanda – não há como obter acesso sob demanda a ferramentas e plataformas de aprendizado de máquina, bem como à infraestrutura computacional.
- Produção – os modelos permanecem em estágio de protótipo e não são levados à produção.
- Rastrear e explicar os resultados do AI – a reprodutibilidade, rastreamento e explicação dos resultados do AI/ML são difíceis.
Se não resolvidos, esses problemas afetam negativamente a velocidade, eficiência e produtividade dos valiosos especialistas em processamento e análise de dados. Isso leva à frustração, descontentamento no trabalho e, por fim, as expectativas do negócio em relação ao AI/ML se vão ao chão.
A responsabilidade por resolver esses problemas recai sobre os profissionais de TI, que devem fornecer aos analistas de dados – isso mesmo, algo como uma nuvem. Em termos mais amplos, é necessário ter uma plataforma que ofereça liberdade de escolha e acesso fácil e conveniente. Além disso, deve ser rápida, facilmente reconfigurável, escalável sob demanda e resistente a falhas. Construir essa plataforma com tecnologias de código aberto ajuda a evitar a dependência do fornecedor e a manter uma vantagem estratégica de longo prazo em termos de controle de custos.
Há alguns anos, algo semelhante aconteceu no desenvolvimento de aplicativos e levou ao surgimento de microsserviços, ambientes de nuvem híbridos, automação de TI e processos ágeis. Para lidar com tudo isso, os profissionais de TI começaram a usar contêineres, Kubernetes e nuvens híbridas abertas.
Agora, essa experiência é aplicada para responder aos desafios da IA. Por isso, os profissionais de TI estão criando plataformas que se baseiam em contêineres, permitem a criação de serviços de IA/ML dentro de processos ágeis, aceleram inovações e são construídas com foco na nuvem híbrida.
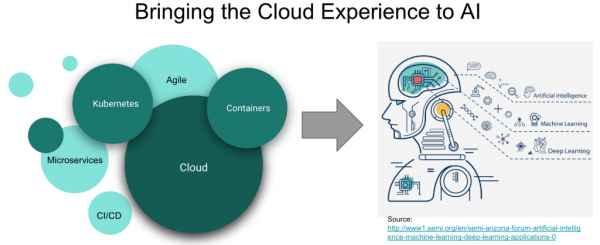
A construção dessa plataforma começará com o Red Hat OpenShift, nossa plataforma de contêineres Kubernetes para nuvem híbrida, que possui um ecossistema de soluções ML de software e hardware em rápido crescimento (NVIDIA, H2O.ai, Starburst, PerceptiLabs, etc.). Alguns dos clientes da Red Hat, como BMW Group, ExxonMobil e outros, já implementaram cadeias de ferramentas ML em contêineres e processos DevOps baseados nesta plataforma e em seu ecossistema, para colocar suas arquiteturas ML em modo de produção industrial e acelerar o trabalho dos analistas de dados.
Outra razão pela qual lançamos o projeto Open Data Hub é demonstrar um exemplo de arquitetura baseada em vários projetos de código aberto e mostrar como implementar todo o ciclo de vida de uma solução de ML na plataforma OpenShift.
Projeto Open Data Hub
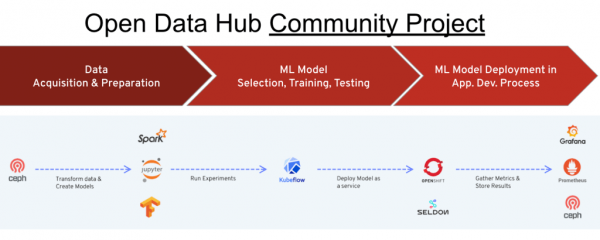
É um projeto de código aberto que evolui dentro da comunidade de desenvolvimento adequada e implementa todo o ciclo de operações – desde o upload e transformação de dados brutos até a formação, treinamento e manutenção do modelo – ao resolver problemas de IA/ML com contêineres e Kubernetes na plataforma OpenShift. Este projeto pode ser visto como uma implementação de referência, um exemplo de como construir uma solução aberta de ‘IA/ML como serviço’ com base no OpenShift e nas ferramentas de código aberto correspondentes, como Tensorflow, JupyterHub, Spark, entre outras. É importante notar que a Red Hat utiliza este projeto para fornecer seus serviços de IA/ML. Além disso, o OpenShift é integrado a soluções chave de software e hardware em ML de fornecedores como NVIDIA, Seldon, Starburst e outros, o que facilita a construção e execução de sistemas próprios de aprendizado de máquina.
O projeto Open Data Hub é voltado para as seguintes categorias de usuários e cenários de uso:
- Um analista de dados que precisa de uma solução em nuvem para a implementação de projetos de ML com funcionalidades de autoatendimento.
- Um analista de dados que precisa de uma ampla variedade das mais recentes ferramentas e plataformas de AI/ML de código aberto.
- Um analista de dados que precisa de acesso a fontes de dados ao treinar modelos.
- Um analista de dados que precisa de acesso a recursos computacionais (CPU, GPU, memória).
- Um analista de dados que precisa da capacidade de colaborar e compartilhar resultados com colegas, receber feedback e implementar melhorias por meio de iterações rápidas.
- Um analista de dados que deseja interagir com desenvolvedores (e equipes de devops) para que seus modelos de ML e resultados sejam colocados em produção.
- Um engenheiro de dados que precisa fornecer aos analistas de dados acesso a uma variedade de fontes de dados, em conformidade com normas e requisitos de segurança.
- Um administrador/operador de sistemas de TI que precisa de uma maneira eficiente de controlar o ciclo de vida (instalação, configuração, atualização) de componentes e tecnologias de código aberto. Além disso, precisa das ferramentas de gerenciamento e cotações adequadas.
O projeto Open Data Hub reúne uma série de ferramentas de código aberto para a execução de um ciclo completo de operações de AI/ML. O principal ambiente de trabalho do analista de dados aqui é o Jupyter Notebook. Esta ferramenta é amplamente popular entre profissionais de processamento e análise de dados, e o Open Data Hub permite que eles criem e gerenciem facilmente áreas de trabalho do Jupyter Notebook, utilizando o JupyterHub integrado. Além da criação e importação de notebooks Jupyter, o projeto Open Data Hub também contém uma série de notebooks prontos na forma de uma biblioteca AI Library.
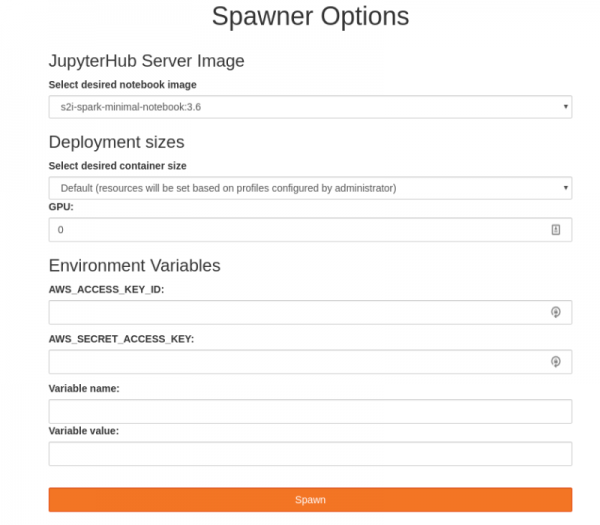
Esta biblioteca é uma coleção de componentes de aprendizado de máquina open-source e soluções para cenários comuns, facilitando a prototipagem rápida. O JupyterHub está integrado ao modelo de controle de acesso RBAC do OpenShift, permitindo o uso de contas OpenShift já existentes e implementando um sistema de autenticação única. Além disso, o JupyterHub oferece uma interface de usuário conveniente chamada spawner, que permite ao usuário personalizar facilmente a quantidade de recursos computacionais (núcleos de CPU, memória, GPU) para o Jupyter Notebook selecionado.
Após o data analyst criar e configurar o notebook, todas as outras preocupações ficam a cargo do scheduler Kubernetes, que faz parte do OpenShift. Os usuários podem focar em realizar seus experimentos, salvar e compartilhar os resultados de seu trabalho. Além disso, usuários avançados podem acessar diretamente o shell CLI do OpenShift a partir dos notebooks Jupyter para utilizar primitivas do Kubernetes, como Job, ou funcionalidades do OpenShift, como Tekton ou Knative. Também é possível usar a interface gráfica do OpenShift, chamada de 'console web do OpenShift'.
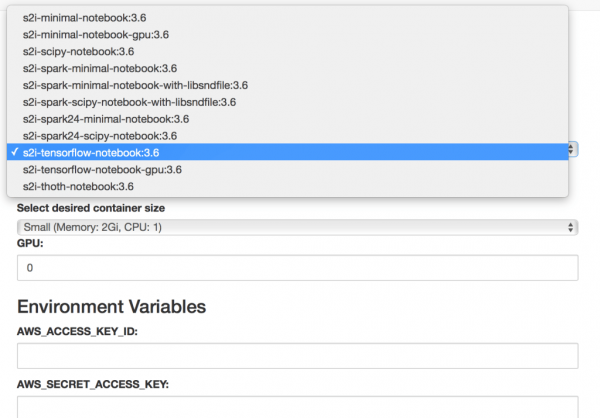
Passando para a próxima etapa, o Open Data Hub permite gerenciar pipelines de dados. Para isso, é utilizado um objeto Ceph, que é fornecido na forma de um armazenamento de objetos compatível com S3. O Apache Spark realiza o streaming de dados de fontes externas ou do armazenamento interno Ceph S3, além de permitir a execução de pré-transformações de dados. O Apache Kafka fornece um gerenciamento avançado de pipelines de dados (onde é possível realizar carregamentos múltiplos, assim como operações de transformação, análise e armazenamento de dados).
Portanto, o data analyst teve acesso aos dados e construiu um modelo. Agora, ele deseja compartilhar os resultados obtidos com colegas ou desenvolvedores de aplicativos, oferecendo seu modelo como um serviço. Para isso, é necessário um servidor de saída, e o Open Data Hub possui um servidor chamado Seldon, que permite publicar o modelo como um serviço RESTful.
Em algum momento, esses modelos no servidor Seldon se tornam vários, e surge a necessidade de monitorar como eles estão sendo utilizados. Para isso, o Open Data Hub oferece uma coleção de métricas correspondentes e um mecanismo de relatórios baseado em ferramentas de monitoramento de código aberto amplamente utilizadas, como Prometheus e Grafana. Como resultado, obtemos feedback para monitorar o uso de modelos de IA, especialmente em ambientes de produção.
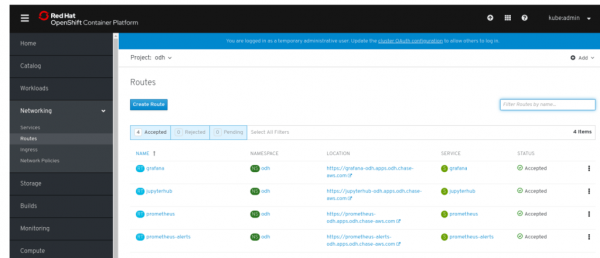
Assim, o Open Data Hub proporciona uma abordagem em nuvem ao longo de todo o ciclo de operações de IA/ML, desde o acesso e preparação de dados até o treinamento e a operação industrial do modelo.
Reunindo tudo
Agora surge a questão de como o administrador do OpenShift deve organizar tudo isso. E aqui entra em cena um operador Kubernetes especial para projetos do Open Data Hub.
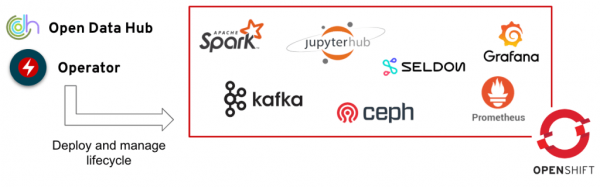
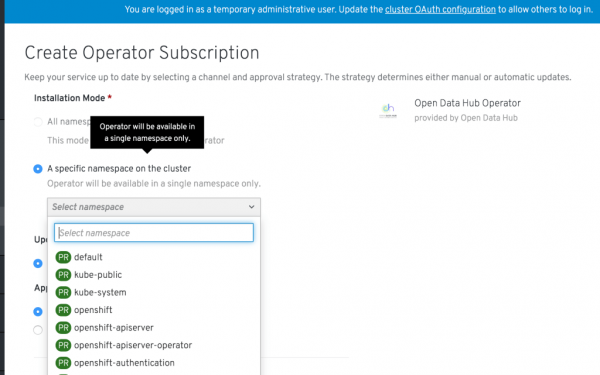
Esse operador gerencia a instalação, configuração e ciclo de vida do projeto Open Data Hub, incluindo a implementação de ferramentas mencionadas anteriormente, como JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus e Grafana. O projeto Open Data Hub pode ser encontrado no console web do OpenShift, na seção de operadores comunitários. Assim, o administrador do OpenShift pode especificar que os projetos OpenShift correspondentes pertencem à categoria 'projeto Open Data Hub'. Isso é feito uma vez. Depois disso, o analista de dados acessa seu espaço de projeto através do console web do OpenShift e vê que o operador Kubernetes correspondente está instalado e disponível para seus projetos. Em seguida, ele cria uma instância do projeto Open Data Hub com um clique e imediatamente tem acesso às ferramentas mencionadas acima. E tudo isso pode ser configurado em um modo de alta disponibilidade e falha-tolerante.
Se você deseja experimentar o projeto Open Data Hub por conta própria, comece com . Detalhes técnicos sobre a arquitetura do Open Data Hub podem ser encontrados , planos de desenvolvimento do projeto - . No futuro, está planejada a implementação de uma integração adicional com o Kubeflow, a resolução de várias questões relacionadas à regulamentação de dados e segurança, além da organização da integração com sistemas baseados em regras Drools e Optaplanner. Você pode expressar sua opinião e se tornar um participante do projeto na página .
Resumindo: problemas sérios de escalabilidade impedem que as organizações aproveitem plenamente o potencial da inteligência artificial e do aprendizado de máquina. O Red Hat OpenShift tem sido amplamente utilizado para enfrentar problemas semelhantes na indústria de software. O projeto Open Data Hub, realizado dentro da comunidade de desenvolvimento de código aberto, oferece uma arquitetura de referência para organizar todo o ciclo de operações de AI/ML na infraestrutura de nuvem híbrida do OpenShift. Temos um plano claro e bem pensado para o desenvolvimento deste projeto e estamos seriamente comprometidos em criar uma comunidade de desenvolvimento ativa e produtiva de soluções de AI abertas na plataforma OpenShift.
Fonte: habr.com
