

– Oh, nenhum abrigo resistirá ao impacto de um meteorito. Mas, assim como todos, você tem uma reserva, então não precisa se preocupar.
Stanislaw Lem, "Diários Estelares de Ijon Tichy"
O backup refere-se à preservação de uma cópia dos dados em algum lugar fora do local principal de armazenamento.
A principal finalidade do backup é a recuperação de dados após a sua perda. Nesse sentido, é comum ouvir que, com uma réplica do banco de dados, é sempre possível recuperar os dados, e o backup não é necessário. Na verdade, o backup resolve pelo menos três problemas que não podem ser resolvidos apenas com a réplica, e nem mesmo a réplica pode ser inicializada sem o backup.
Em primeiro lugar, o backup permite restaurar dados após um erro lógico. Por exemplo, um contador pode ter excluído um conjunto de registros ou um administrador de banco de dados pode ter destruído um espaço de tabela. Ambas as operações são absolutamente legítimas do ponto de vista do banco de dados, e o processo de replicação as reproduzirá na réplica.
Em segundo lugar, sistemas de gerenciamento de bancos de dados modernos são conjuntos de programas bastante confiáveis, mas ocasionalmente, ainda assim, ocorre a corrupção das estruturas internas do banco de dados, após a qual o acesso aos dados é perdido. O que é especialmente frustrante é que essa violação geralmente ocorre sob alta carga ou durante a instalação de alguma atualização. Mas tanto a alta carga quanto as atualizações regulares indicam que o banco de dados não é de teste, e os dados armazenados nele são valiosos.
Finalmente, a terceira tarefa, cuja solução requer um backup, é a clonagem do banco, por exemplo, para fins de teste.
O backup de bancos de dados baseia-se de uma forma ou de outra em um dos dois princípios:
- Extração dos dados com subsequente salvamento em formato arbitrário;
- Captura do estado dos arquivos do banco de dados e salvamento de logs.
Vamos examinar esses princípios e as ferramentas que os implementam com mais detalhes.
Exportação de dados
No conjunto de utilitários que acompanham qualquer SGBD, sempre há ferramentas para exportação e importação de dados. Os dados são salvos em formato texto ou em um formato binário específico para o SGBD em questão. A tabela abaixo apresenta uma lista dessas ferramentas:
Formato binário
Formato texto
Oracle
DataPump Export/DataPump Import
Exportar/Importar
SQL*Plus/SQL*Loader
PostgreSQL
pg_dump, pg_dumpall/pg_restore
pg_dump, pg_dumpall/psql
Microsoft SQL Server
bcp
bcp
DB2
descarregar/cargar
descarregar/cargar
MySQL
mysqldump, mysqlpump/mysql, mysqlimport
MongoDB
mongodump/mongorestore
mongoexport/mongoimport
Cassandra
nodetool snapshot/sstableloader
cqlsh
O formato de texto é bom porque pode ser editado ou até mesmo criado por programas externos, enquanto o formato binário é bom porque permite carregar e descarregar dados mais rapidamente, economizando recursos na conversão de formatos.
Apesar da simplicidade e da obviedade da ideia de descarregar dados, esse método é raramente utilizado para backup completo de bancos de dados industriais em alta carga. Aqui estão as razões pelas quais a descarrega não é adequada para backup completo:
- o processo de descarrega cria uma carga significativa no sistema de origem;
- a descarrega leva muito tempo – quando termina, os dados já podem estar desatualizados;
- fazer uma descarrega consistente de todo o banco de dados sob alta carga é praticamente impossível, uma vez que o SGBD precisa reter uma cópia do seu estado no momento em que a descarrega começa. Quanto mais transações forem realizadas desde o início da descarrega, maior será o volume da cópia (cópias de dados desatualizadas no PostgreSQL, espaço undo no Oracle, tempdb no Microsoft SQL Server etc.);
- a descarrega preserva a estrutura lógica dos dados, mas não preserves sua estrutura física – os parâmetros de armazenamento físico das tabelas, índices etc.
No entanto, a descarrega também tem suas vantagens:
- alta seletividade: é possível descarregar tabelas individuais, campos individuais e até linhas individuais;
- os dados descarregados podem ser carregados em um banco de dados de versão diferente, e se a descarga for feita em formato de texto, também em um banco de dados diferente.
Assim, a descarrega é usada principalmente para tarefas como backup de pequenas tabelas (por exemplo, diretórios) ou distribuição de conjuntos de dados com uma nova versão do aplicativo.
O método mais comum de backup de bancos de dados é a cópia de arquivos do banco.
Backup "frio" de arquivos do banco de dados
A ideia óbvia é parar o banco de dados e copiar todos os seus arquivos. Esse tipo de backup é chamado de "frio". O método é extremamente confiável e simples, mas tem duas desvantagens evidentes:
- a partir de um backup "frio" só é possível restaurar o estado do banco de dados que existia no momento da parada; transações realizadas após a reinicialização do banco não serão incluídas no backup "frio";
- nem todos os bancos de dados possuem uma janela tecnológica em que podem ser parados.
Se o backup "frio" for aceitável para você, é importante lembrar que
- um backup "frio" às vezes deve incluir os logs. Os métodos de identificação dos logs que devem ser incluídos no backup "frio" são específicos para cada SGBD. Por exemplo, no Oracle é necessário copiar os chamados online redo, ou seja, um número fixo de arquivos de log de um diretório especial, mesmo quando o banco está parado corretamente. No PostgreSQL, é preciso salvar todos os logs a partir do log que contém o último ponto de verificação, cuja informação está no arquivo de controle.
- o diretório do banco de dados pode conter arquivos temporários de espaço de tabela bastante grandes, que não precisam necessariamente ser incluídos no backup. A propósito, essa observação é válida também para backups a "quente".
"Backup a quente" de arquivos
A maioria dos backups de bancos de dados modernos é realizada copiando os arquivos do banco de dados sem interromper o funcionamento do banco. Aqui surgem alguns problemas:
- No momento em que a cópia começa, o conteúdo do banco de dados pode não coincidir com o dos arquivos, pois parte da informação está no cache e ainda não foi gravada no disco.
- Durante a cópia, o conteúdo do banco pode mudar. Se estruturas de dados mutáveis estão sendo usadas, o conteúdo dos arquivos mudará, e ao usar estruturas imutáveis, o conjunto de arquivos mudará: novos arquivos aparecerão, enquanto antigos desaparecerão.
- Como a gravação de dados no banco e a leitura dos arquivos do BD não são sincronizadas, o programa de backup pode ler uma página incorreta, onde metade pertence à versão antiga da página e a outra metade à nova.
Para que um backup seja consistente, cada SGBD possui um comando que informa que o processo de backup foi iniciado. Os comandos podem variar sintaticamente:
- no Oracle, é um comando separado ALTER DATABASE/TABLESPACE BEGIN BACKUP;
- no PostgreSQL – função pg_start_backup();
- No Microsoft SQL Server e no DB2, a preparação para backup é feita implicitamente durante a execução do comando BACKUP DATABASE;
- No MySQL Enterprise, Cassandra e MongoDB, a preparação é realizada implicitamente por uma ferramenta externa – mysqlbackup, OpsCenter e Ops Manager, respectivamente.
Apesar das diferenças de sintaxe, o processo de preparação para backup é semelhante.
Aqui está como a preparação para backup é feita em SGBDs com estruturas de disco mutáveis, ou seja, em todos os sistemas relacionais tradicionais com disco:
- O momento do início do backup é registrado; o backup deve conter os logs do banco de dados a partir desse momento.
- Um ponto de verificação é executado, ou seja, todas as alterações que ocorreram nas páginas de dados até o momento registrado são gravadas no disco. Isso garante que os logs antes do início do backup não serão necessários na recuperação.
- Um modo especial de registro é ativado: se uma página de dados for alterada pela primeira vez após ser carregada do disco, ao invés de registrar a alteração da página no log, o banco registrará a página inteira. Durante a execução do procedimento preparatório, todas as páginas são gravadas no disco, de modo que na primeira alteração, o bloco sempre será registrado no log como um todo. Mas se, durante o backup, a página for novamente escrita no disco, a próxima alteração também resultará na gravação de uma cópia completa da página no log. Isso garante que, se por acaso a página se tornar incorreta ao copiar o arquivo de dados, a aplicação do log a tornará correta novamente.
- As alterações nos cabeçalhos dos arquivos de dados são bloqueadas, ou seja, a parte cujo conteúdo não é refletido nos logs. Isso garante que o cabeçalho seja copiado corretamente, e depois os logs sejam aplicados corretamente ao arquivo de dados.
Após a execução de todos os procedimentos mencionados acima, é possível copiar os arquivos de dados usando os recursos do sistema operacional – cp, rsync e outros. A ativação do modo de backup reduz o desempenho do banco de dados: primeiro, o volume dos logs aumenta e, em segundo lugar, se ocorrer uma falha durante o modo de backup, a recuperação será mais longa, pois os cabeçalhos dos arquivos de dados não são atualizados. Quanto mais rápido o backup for concluído, melhor para o banco de dados, por isso é apropriado usar ferramentas como snapshot do sistema de arquivos ou BCV (Break of Mirror) em um array de discos. Alguns SGBDs (Oracle, PostgreSQL) permitem que o administrador escolha pessoalmente o método de cópia, enquanto outros (Microsoft SQL Server) oferecem uma interface para integrar suas próprias utilidades de backup com mecanismos de sistemas de arquivos ou de armazenamento.
Após a conclusão do backup, é necessário restaurar o banco de dados ao estado normal. No Oracle, isso é feito com o comando ALTER DATABASE/TABLESPACE END BACKUP, no PostgreSQL – chamando a função pg_stop_backup(), e em outros bancos – através de subprogramas internos dos comandos correspondentes ou serviços externos.
Veja como é o diagrama temporal do processo de backup:
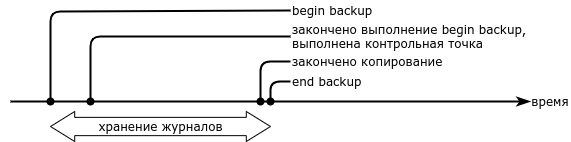
- A preparação para o backup (begin backup) leva tempo, muitas vezes considerável. Mesmo que sejam utilizados volumes espelhados ou sistemas de arquivos capazes de fazer snapshots, o processo de backup não será instantâneo.
- Juntamente com os arquivos de dados, é necessário manter os logs desde o início da preparação para o backup até o momento em que o banco é revertido ao estado normal.
- É possível restaurar a partir deste backup no momento em que o banco é revertido ao estado normal. A recuperação em um momento anterior não é possível.
Com bancos de dados que utilizam estruturas de dados imutáveis (snapshots de memória, árvores LSM), a situação é mais simples. A preparação para o backup consiste nas seguintes etapas:
- Os dados da memória são descarregados no disco.
- Uma lista de arquivos que entram no backup é registrada. Até que o processo de backup seja concluído, é proibido ao banco de dados excluir estes arquivos, mesmo que eles se tornem desnecessários.
Após o sinal de conclusão do backup, o banco de dados com estruturas imutáveis pode novamente excluir arquivos indesejados.
Recuperação para um ponto
O backup permite restaurar o estado do banco de dados no momento em que a ação de retorno do modo de backup foi concluída. No entanto, uma falha que exige recuperação pode ocorrer a qualquer momento. A tarefa de restaurar o estado do banco de dados em um momento arbitrário é chamada de 'recuperação para um ponto' (point-in-time recovery).
Para garantir essa possibilidade, é necessário manter os logs do banco de dados desde o término do backup, e durante a recuperação, continuar aplicando os logs à cópia restaurada. Depois que o banco de dados é recuperado a partir do backup no momento em que o backup foi concluído, o estado do banco (arquivos e páginas armazenadas em cache) está garantidamente correto, portanto, um modo especial de logging não é necessário. Aplicando os logs até o momento desejado, é possível obter o estado do banco de dados em qualquer ponto no tempo.
Se a velocidade de recuperação do backup é limitada apenas pela capacidade do disco, a velocidade de aplicação dos logs é geralmente limitada pelo desempenho do processador. Se alterações estão ocorrendo paralelamente no banco de dados principal, todas as alterações durante a recuperação são executadas sequencialmente – na ordem de leitura dos logs. Assim, o tempo de recuperação depende linearmente da distância entre o ponto de recuperação e o ponto de conclusão do backup. Por causa disso, é necessário fazer backups completos com bastante frequência – no mínimo uma vez por semana para bancos com baixa carga transacional e até backups diários para bancos de dados com alta carga.
Backup incremental
Para acelerar a recuperação para um ponto, é desejável poder realizar backups com a maior frequência possível, mas sem ocupar espaço extra nos discos e sem sobrecarregar o banco de dados com tarefas de backup.
A solução para essa tarefa é o backup incremental, ou seja, copiar apenas aquelas páginas de dados que mudaram desde o último backup realizado.
O backup incremental faz sentido apenas para bancos de dados que utilizam estruturas de dados mutáveis.
O incremento pode ser contado a partir de um backup completo (cópia cumulativa) ou a partir de qualquer cópia anterior (cópia diferencial).
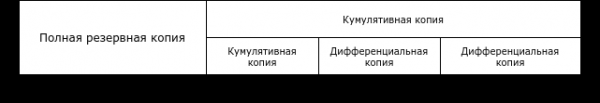
Infelizmente, não existe uma terminologia unificada, e diferentes fabricantes usam termos diferentes:
Diferencial
Cumulativa
Oracle
Diferencial
Cumulativa
PostgresPro
Incremental
—
Microsoft SQL Server
—
Diferencial
IBM DB2
Delta
Incremental
Com cópias incrementais disponíveis, o processo de recuperação para um ponto específico é o seguinte:
- A última cópia completa feita antes do momento de recuperação é restaurada;
- As cópias incrementais são restauradas sobre a cópia completa;
- Os logs são aplicados desde o início do backup até o ponto de recuperação.
Ter uma cópia cumulativa acelera o processo de recuperação. Por exemplo, para restaurar o estado do banco de dados em um ponto entre T3 e T4, é necessário restaurar duas cópias incrementais, enquanto para restaurar em um ponto após T4, apenas uma cópia é necessária.
É evidente que o volume de uma cópia cumulativa é menor do que o de várias cópias diferenciais, pois algumas páginas mudaram várias vezes, e cada cópia incremental contém sua versão da página.
Existem três maneiras de criar uma cópia incremental:
- Criar uma cópia completa e calcular a diferença em relação à cópia completa anterior;
- Analisar os logs, criar uma lista de páginas alteradas e fazer backup das páginas incluídas na lista;
- Solicitar as páginas alteradas no banco de dados.
O primeiro método economiza espaço em disco, mas não resolve o problema de reduzir a carga no banco de dados. Além disso, se tivermos um backup completo, transformá-lo em incremental não faz sentido, pois a recuperação de uma cópia completa é mais rápida do que a recuperação de uma cópia completa anterior e de um incremento. A tarefa de economizar espaço em disco, com essa abordagem, deve ser delegada a componentes especiais com mecanismos de deduplicação integrados. Esses podem ser tanto sistemas de armazenamento especializados (EMC DataDomain, HPE StorageWorks VLS, toda a linha NetApp), quanto produtos de software (ZFS, Veritas NetBackup PureFile, Windows Server Data Deduplication).
O segundo e o terceiro métodos diferem no mecanismo para identificar a lista de páginas alteradas. A análise dos logs é mais demandante em termos de recursos, além de que, para sua implementação, é necessário conhecer a estrutura dos arquivos de log. Perguntar diretamente ao banco de dados quais páginas foram alteradas é a opção mais simples, mas para isso o núcleo do SGBD deve ter a funcionalidade de rastreamento de blocos alterados (block change tracking).
A funcionalidade de backup incremental foi introduzida pela primeira vez no software Oracle Recovery Manager (RMAN), que surgiu na versão Oracle 8i. A Oracle implementou imediatamente o rastreamento de blocos alterados, portanto, não há necessidade de analisar logs.
O PostgreSQL não rastreia blocos alterados, portanto, a ferramenta pg_probackup, desenvolvida pela empresa russa Postgres Professional, identifica páginas alteradas por meio da análise de logs. No entanto, a empresa também fornece o SGBD PostgresPro, que inclui a extensão ptrack, que rastreia a alteração de páginas. Ao usar o pg_probackup com o SGBD PostgresPro, a ferramenta solicita as páginas alteradas diretamente ao banco – assim como o RMAN.
O Microsoft SQL Server, assim como a Oracle, rastreia páginas alteradas, mas a comando BACKUP permite realizar apenas backups completos e cumulativos.
No DB2, existe a possibilidade de rastrear páginas alteradas, mas essa função está desativada por padrão. Após ser ativada, o DB2 permitirá a realização de backups completos, diferenciais e cumulativos.
Uma diferença importante entre as ferramentas descritas nesta seção (exceto pg_probackup) e as ferramentas de backup de arquivos é que elas solicitam imagens das páginas ao banco de dados, em vez de ler os dados do disco de forma independente. A desvantagem dessa abordagem é uma pequena carga adicional no banco. No entanto, essa desvantagem é amplamente compensada pelo fato de que a página lida sempre é correta, eliminando a necessidade de habilitar um modo especial de registro durante o backup.
Mais uma vez, observe que a presença de backups incrementais não anula os requisitos de manter logs para a recuperação em qualquer ponto do tempo. Portanto, em bancos de dados industriais, os logs são constantemente gravados em um dispositivo externo, enquanto os backups, sejam completos e/ou incrementais, são feitos em cronograma.
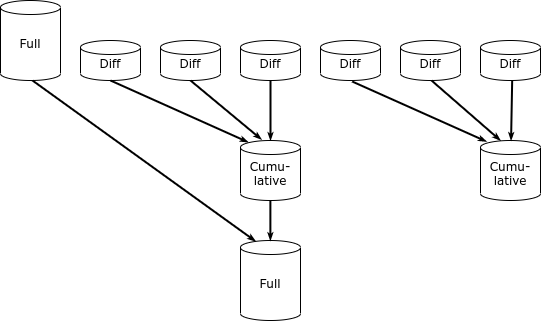
A melhor implementação até hoje da ideia de backup incremental é o sistema de recuperação Zero Data Loss Recovery Appliance – uma solução especializada da Oracle para backup de seu próprio banco de dados. O sistema consiste em um cluster servidores com grande capacidade de armazenamento, no qual está instalada uma versão modificada do software Recovery Manager, podendo funcionar tanto com outros sistemas de hardware e software da Oracle (Database Appliance, Exadata, SPARC Supercluster), quanto com bancos de dados Oracle em infraestrutura tradicional. Ao contrário do "normal" RMAN, o ZDLRA implementa o conceito de "incremento eterno" (incremental forever). O sistema cria uma cópia completa do banco de dados uma única vez e, em seguida, faz apenas cópias incrementais. Módulos adicionais do RMAN permitem combinar cópias, gerando novas cópias completas a partir das incrementais.
Para o crédito dos desenvolvedores russos, vale notar que o pg_probackup também consegue combinar cópias incrementais.
Ao contrário de muitas perguntas semelhantes, a pergunta "qual método de backup é o melhor" tem uma resposta clara – a melhor é a ferramenta nativa do SGBD utilizado, que oferece a possibilidade de backup incremental.
Para o administrador de banco de dados, perguntas sobre a escolha da estratégia de backup e a integração das ferramentas de backup de bancos de dados na infraestrutura corporativa são muito mais importantes. Mas essas questões estão além do escopo deste artigo.
Fonte: habr.com
