

Em Nós examinamos a clusterização do RabbitMQ para garantir resiliência e alta disponibilidade. Agora, vamos nos aprofundar no Apache Kafka.
Aqui, a unidade de replicação é a partição (partition). Cada tópico possui uma ou mais partições. Em cada partição, há um líder com seguidores ou sem eles. Ao criar um tópico, especifica-se o número de partições e o fator de replicação. O valor usual é 3, o que significa três réplicas: um líder e dois seguidores.
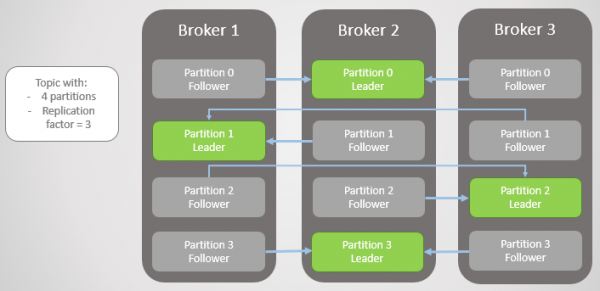
Figura 1. Quatro partições distribuídas entre três corretores
Todas as solicitações de leitura e escrita vão para o líder. Os seguidores periodicamente enviam requisições ao líder para obter as últimas mensagens. Os consumidores nunca se conectam aos seguidores, que existem apenas para redundância e resiliência.
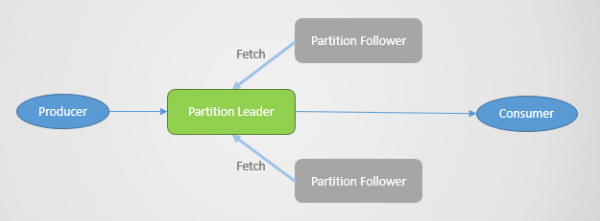
Falha da partição
Quando um corretor falha, frequentemente os líderes de várias partições também ficam fora de operação. Em cada uma delas, o líder se torna um seguidor de outro nó. Na verdade, isso nem sempre acontece, pois outro fator influencia: se existem seguidores sincronizados e, caso contrário, se a mudança para uma réplica não sincronizada é permitida. Mas não vamos complicar por enquanto.
O corretor 3 sai da rede — e para a partição 2, um novo líder é eleito no corretor 2.
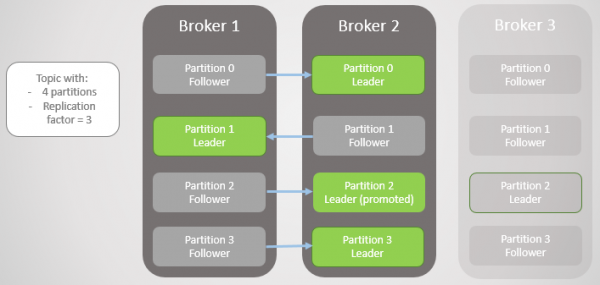
Figura 2. O corretor 3 falha, e seu seguidor no corretor 2 é eleito novo líder da partição 2
Em seguida, o corretor 1 sai e a partição 1 também perde seu líder, cuja função passa a ser do corretor 2.
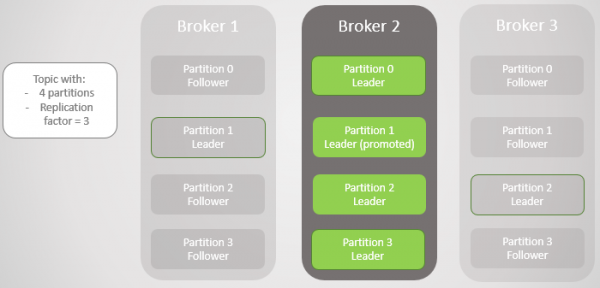
Figura 3. Permanece apenas um corretor. Todos os líderes estão em um único corretor com zero redundância
Quando o corretor 1 retorna à rede, ele adiciona quatro seguidores, fornecendo alguma redundância para cada partição. Mas todos os líderes ainda permanecem no corretor 2.
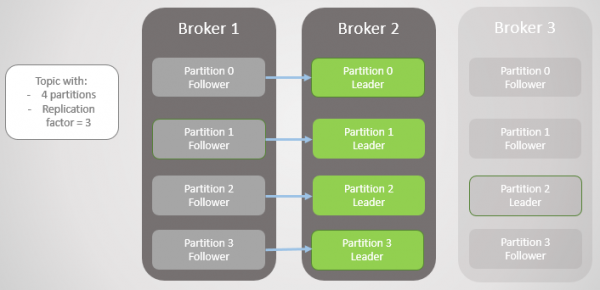
Figura 4. Os líderes permanecem no corretor 2
Quando o corretor 3 se reinicia, retornamos a três réplicas por partição. Mas todos os líderes ainda estão no corretor 2.
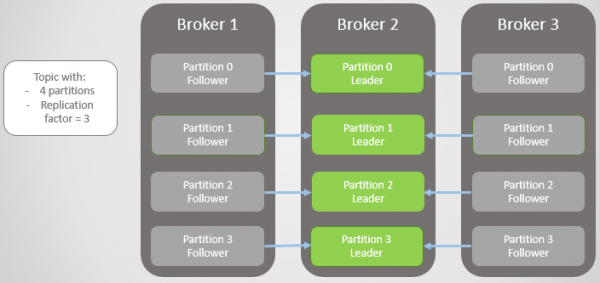
Figura 5. Distribuição desequilibrada dos líderes após a recuperação dos corretores 1 e 3
O Kafka tem uma ferramenta para reequilibrar líderes de forma mais eficiente do que o RabbitMQ. Nesse caso, era necessário usar um plugin ou script externo que alterava as políticas para migrar o nó principal à custa da redução da redundância durante a migração. Além disso, para grandes filas, era preciso aceitar a indisponibilidade durante a sincronização.
O Kafka tem o conceito de "réplicas preferidas" para o papel de líder. Quando as partições de um tópico são criadas, o Kafka tenta distribuir os líderes uniformemente entre os nós e marca esses primeiros líderes como preferidos. Com o tempo, devido a reinicializações de servidores, falhas e interrupções de conectividade, os líderes podem acabar em diferentes nós, como no caso extremo descrito acima.
Para corrigir isso, o Kafka oferece duas opções:
- Opção auto.leader.rebalance.enable=true permite que o nó do controlador reatribua automaticamente os líderes de volta às réplicas preferidas, restaurando assim a distribuição uniforme.
- O administrador pode executar o script kafka-preferred-replica-election.sh para reatribuir manualmente.
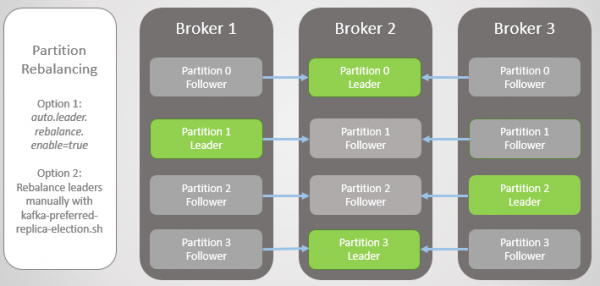
Fig. 6. Réplicas após rebalanceamento
Esta foi uma versão simplificada da falha, mas a realidade é mais complexa, embora aqui não haja nada muito complicado. Tudo se resume a réplicas sincronizadas (In-Sync Replicas, ISR).
Réplicas sincronizadas (ISR)
ISR é um conjunto de réplicas de partição que é considerado "sincronizado" (in-sync). Aqui existe um líder, e pode não haver seguidores. Um seguidor é considerado sincronizado se ele fez cópias exatas de todas as mensagens do líder antes do término do intervalo replica.lag.time.max.ms.
Um seguidor é removido do conjunto ISR se:
- não fez a solicitação de busca durante o intervalo replica.lag.time.max.ms (considerado morto)
- não conseguiu se atualizar durante o intervalo replica.lag.time.max.ms (considerado lento)
Os seguidores fazem solicitações de busca dentro do intervalo replica.fetch.wait.max.ms, que por padrão é 500 ms.
Para explicar claramente o objetivo do ISR, é necessário olhar para as confirmações do produtor e alguns cenários de falha. Os produtores podem escolher quando o corretor envia a confirmação:
- acks=0, confirmação não é enviada
- acks=1, confirmação é enviada após o líder gravar a mensagem em seu log local
- acks=all, confirmação é enviada após todas as réplicas em ISR gravarem a mensagem em seus logs locais
Na terminologia do Kafka, se o ISR manter a mensagem, ocorre seu "commit". Acks=all é a opção mais segura, mas traz uma latência adicional. Vamos considerar dois exemplos de falha e como diferentes opções de ‘acks’ interagem com o conceito de ISR.
Acks=1 e ISR
Neste exemplo, veremos que se o líder não espera a confirmação de cada mensagem de todos os seguidores, a perda de dados pode ocorrer em caso de falha do líder. A transição para um seguidor não sincronizado pode ser permitida ou negada pela configuração. unclean.leader.election.enable.
Neste exemplo, o produtor tem o valor de acks=1. A partição está distribuída entre os três corretores. O corretor 3 está atrasado, ele sincronizou com o líder há oito segundos e agora está atrasado em 7456 mensagens. O corretor 1 está atrasado apenas por um segundo. Nosso produtor envia uma mensagem e rapidamente recebe a confirmação, sem sobrecarga de seguidores lentos ou mortos que o líder não espera.
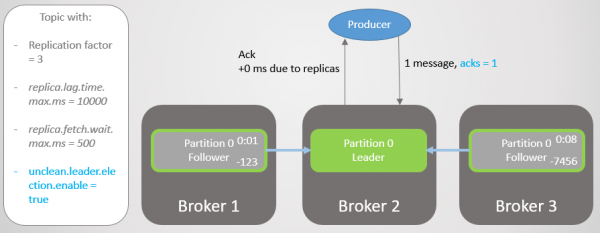
Fig. 7. ISR com três réplicas
O corretor 2 falha, e o produtor recebe um erro de conexão. Após a transição de liderança para o corretor 1, perdemos 123 mensagens. O seguidor no corretor 1 estava no ISR, mas não estava completamente sincronizado com o líder quando ele falhou.
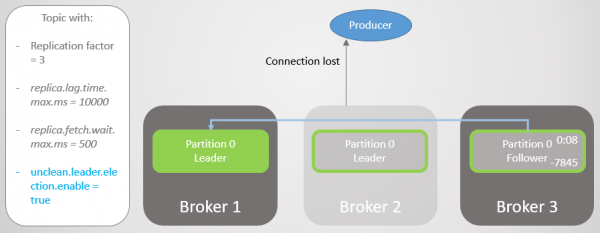
Fig. 8. Mensagens são perdidas em caso de falha
Na configuração bootstrap.servers o produtor lista vários corretores e pode perguntar a outro corretor quem se tornou o novo líder da partição. Em seguida, ele estabelece uma conexão com o corretor 1 e continua enviando mensagens.
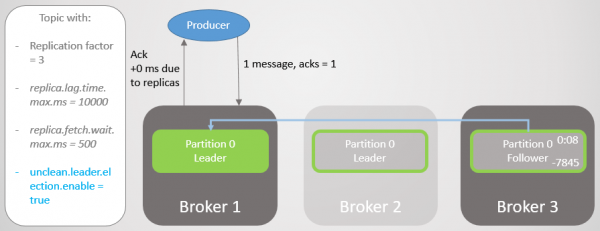
Fig. 9. O envio de mensagens é retomado após uma breve interrupção
O corretor 3 está ainda mais atrasado. Ele faz solicitações de recuperação, mas não consegue se sincronizar. Isso pode ser devido a uma conexão de rede lenta entre os corretores, problemas de armazenamento, etc. Ele é removido do ISR. Agora, o ISR consiste em uma única réplica - o líder! O produtor continua enviando mensagens e recebendo confirmações.
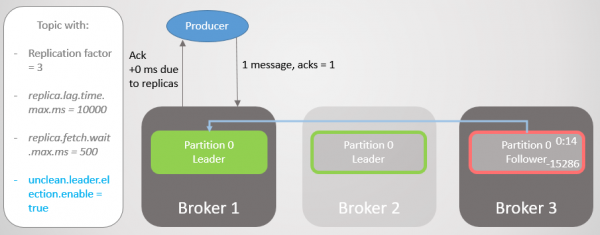
Fig. 10. O seguidor no corretor 3 é removido do ISR
O corretor 1 falha, e o papel de líder passa para o corretor 3 com a perda de 15286 mensagens! O produtor recebe uma mensagem de erro de conexão. A transição para um líder fora do ISR foi possível apenas devido à configuração unclean.leader.election.enable=true. Se estiver configurada para falso, a transição não teria ocorrido e todas as solicitações de leitura e gravação teriam sido rejeitadas. Nesse caso, aguardamos o retorno do corretor 1 com seus dados intocados na réplica, que reassumirá a liderança.
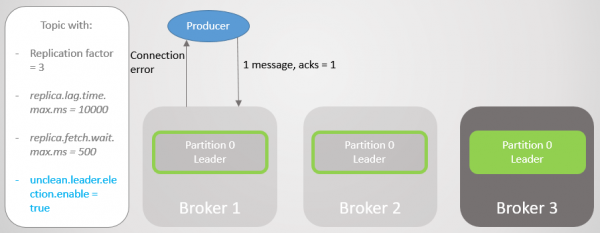
Fig. 11. O corretor 1 falha. Uma grande quantidade de mensagens é perdida em caso de falha.
O produtor estabelece uma conexão com o último corretor e vê que agora ele é o líder da seção. Ele começa a enviar mensagens para o corretor 3.
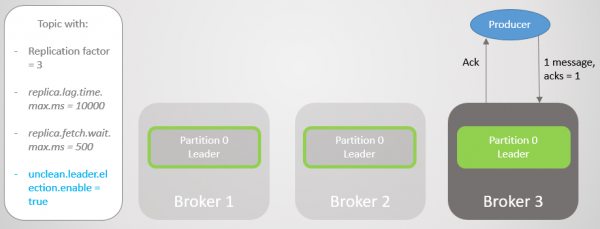
Fig. 12. Após uma breve pausa, as mensagens são novamente enviadas para a seção 0.
Vimos que, além das breves interrupções para estabelecer novas conexões e buscar um novo líder, o produtor estava constantemente enviando mensagens. Essa configuração garante disponibilidade à custa da consistência (segurança dos dados). O Kafka perdeu milhares de mensagens, mas continuou a receber novas gravações.
Acks=all e ISR
Vamos repetir esse cenário mais uma vez, mas com acks=all. O atraso do corretor 3 é em média de quatro segundos. O produtor envia uma mensagem com acks=all, e agora não recebe uma resposta rápida. O líder espera até que a mensagem seja salva por todas as réplicas no ISR.
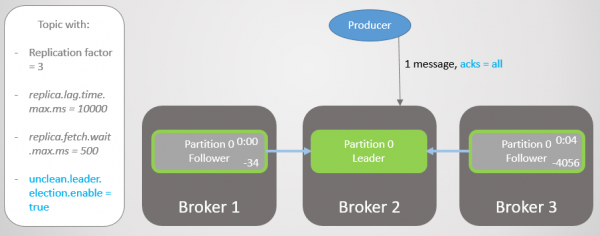
Fig. 13. ISR com três réplicas. Uma está funcionando lentamente, o que resulta em atraso na gravação.
Após quatro segundos de atraso adicional, o corretor 2 envia ack. Todas as réplicas agora estão completamente atualizadas.
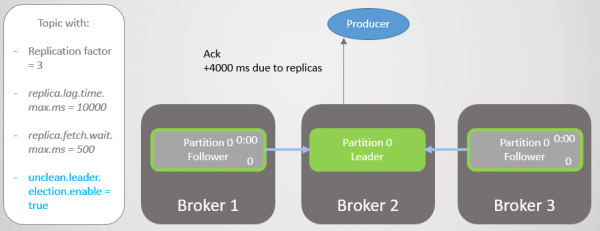
Fig. 14. Todas as réplicas mantêm as mensagens e um ack é enviado.
O corretor 3 agora está ainda mais atrasado e é removido do ISR. O atraso diminui significativamente, pois não restam réplicas lentas no ISR. O corretor 2 agora aguarda apenas o corretor 1, que tem um atraso médio de 500 ms.
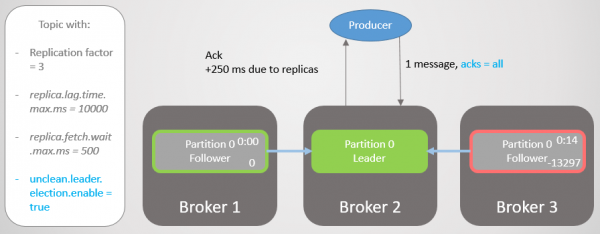
Fig. 15. A réplica no corretor 3 é removida do ISR.
Em seguida, o corretor 2 falha, e a liderança passa para o corretor 1 sem perda de mensagens.
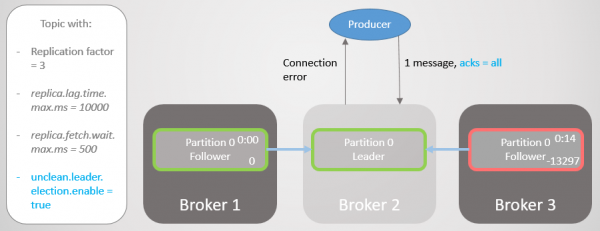
Fig. 16. O corretor 2 falha.
O produtor encontra um novo líder e começa a enviar mensagens para ele. O atraso diminui ainda mais, já que agora o ISR consiste em uma única réplica! Portanto, a opção acks=all não adiciona redundância.
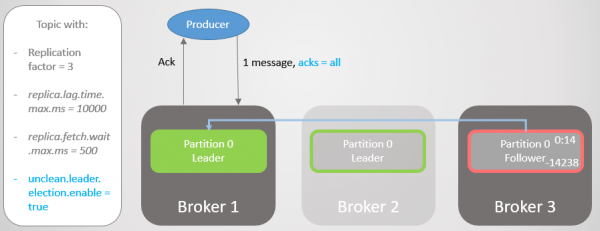
Fig. 17. A réplica no corretor 1 assume a liderança sem perda de mensagens.
Em seguida, o corretor 1 falha, e a liderança passa para o corretor 3 com a perda de 14238 mensagens!
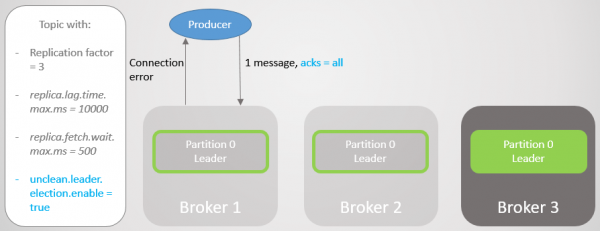
Fig. 18. O corretor 1 morre, e a transição de liderança com a configuração unclean resulta em extensa perda de dados.
Poderíamos não definir a opção unclean.leader.election.enable como valor verdadeiro. Por padrão, ela é igual a falso. A configuração acks=all com unclean.leader.election.enable=true garante disponibilidade com um pouco de segurança adicional dos dados. Mas, como você pode ver, ainda podemos perder mensagens.
Mas e se quisermos aumentar a segurança dos dados? Podemos definir unclean.leader.election.enable = false, mas isso não irá necessariamente nos proteger contra a perda de dados. Se o líder falhar de forma severa e levar os dados consigo, as mensagens ainda estarão perdidas, além de haver perda de disponibilidade até que o administrador recupere a situação.
É melhor garantir a redundância de todas as mensagens, ou então abrir mão do registro. Dessa forma, pelo menos do ponto de vista do broker, a perda de dados só é possível em caso de duas ou mais falhas simultâneas.
Acks=all, min.insync.replicas e ISR
Com a configuração do tópico min.insync.replicas aumentamos o nível de segurança dos dados. Vamos rever mais uma vez a última parte do cenário anterior, mas desta vez com min.insync.replicas=2.
Então, o broker 2 tem um líder de réplica, e o seguidor no broker 3 foi removido do ISR.
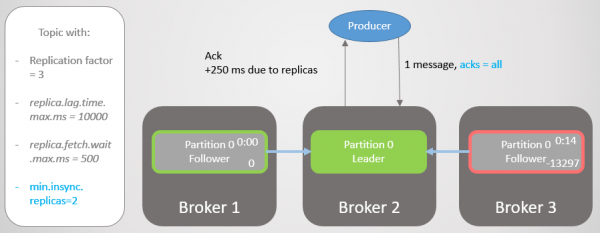
Fig. 19. ISR de duas réplicas
O broker 2 falha, e a liderança passa para o broker 1 sem perda de mensagens. Mas agora o ISR consiste apenas em uma réplica. Isso não atende ao número mínimo para receber registros, e portanto o broker responde a uma tentativa de gravação com um erro. NotEnoughReplicas.
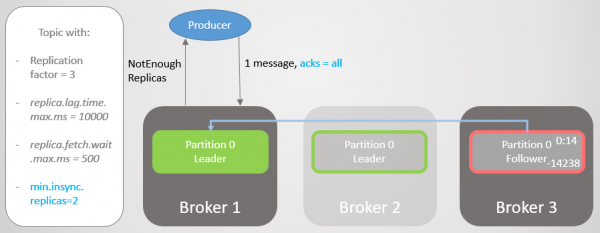
Fig. 20. O número de ISR é um a menos do que o indicado em min.insync.replicas
Esta configuração sacrifica a disponibilidade em prol da consistência. Antes de confirmar a mensagem, garantimos que ela seja gravada em pelo menos duas réplicas. Isso dá ao produtor muito mais confiança. Aqui, a perda de mensagens é possível apenas se ocorrer uma falha simultânea de duas réplicas em um curto intervalo, antes que a mensagem seja replicada para um seguidor adicional, o que é improvável. Mas se você for um superparanoico, pode definir um fator de replicação de 5, e min.insync.replicas o no 3. Aqui, três brokers devem falhar simultaneamente para perder um registro! Claro, por essa confiabilidade você pagará com um adicional de latência.
Quando a disponibilidade é necessária para a segurança dos dados
Assim como no , às vezes a disponibilidade é necessária para a segurança dos dados. Você precisa considerar o seguinte:
- O publisher pode simplesmente retornar um erro, e o serviço ou usuário de nível superior pode tentar novamente mais tarde?
- Um publisher pode salvar a mensagem localmente ou em um banco de dados, para tentar novamente mais tarde?
Se a resposta for não, então a otimização da disponibilidade aumenta a segurança dos dados. Você perderá menos dados se optar pela disponibilidade em vez de recusar o registro. Assim, tudo se resume a encontrar um equilíbrio, e a solução depende da situação específica.
O sentido do ISR
O conjunto ISR permite escolher o equilíbrio ideal entre segurança de dados e latência. Por exemplo, garantir a disponibilidade em caso de falha da maioria das réplicas, minimizando o impacto de réplicas mortas ou lentas em termos de latência.
Nós escolhemos o valor replica.lag.time.max.ms de acordo com nossas necessidades. Essencialmente, esse parâmetro indica qual latência estamos dispostos a aceitar ao acks=all. O valor padrão é de dez segundos. Se isso for muito longo para você, pode reduzi-lo. Nesse caso, a frequência de alterações no ISR aumentará, pois os seguidores serão removidos e adicionados com mais frequência.
No RabbitMQ, existe apenas um conjunto de espelhos que precisam ser replicados. Espelhos lentos introduzem latência adicional, e a resposta de espelhos mortos pode ser aguardada até o tempo de vida dos pacotes que verificam a disponibilidade de cada nó (net tick). O ISR é uma maneira interessante de evitar esses problemas de latência aumentada. Porém, corremos o risco de perder a redundância, já que o ISR pode ser reduzido apenas ao líder. Para evitar esse risco, utilize a configuração min.insync.replicas.
Garantia de conexão de clientes
Nas configurações bootstrap.servers do produtor e do consumidor, você pode especificar vários brokers para conectar clientes. A ideia é que, se um nó falhar, haja vários backups com os quais o cliente pode estabelecer conexão. Isso não precisa ser apenas líderes de partições, mas simplesmente um ponto de partida para o carregamento inicial. O cliente pode perguntar a eles em qual nó o líder da partição está hospedado para leitura/gravação.
No RabbitMQ, os clientes podem conectar a qualquer nó, e o roteamento interno envia a solicitação para onde precisa ir. Isso significa que você pode instalar um balanceador de carga na frente do RabbitMQ. O Kafka exige que os clientes se conectem ao nó onde o líder da partição correspondente está hospedado. Nessa situação, um balanceador de carga não pode ser colocado. A lista bootstrap.servers é crucial para que os clientes possam se conectar aos nós corretos e encontrá-los após uma falha.
Arquitetura de consenso do Kafka
Até agora, não examinamos como o cluster descobre sobre a queda de um broker e como um novo líder é escolhido. Para entender como o Kafka lida com as divisões de rede, é necessário primeiro compreender a arquitetura de consenso.
Cada cluster Kafka é implantado juntamente com um cluster Zookeeper — um serviço de consenso distribuído que permite que o sistema atinja consenso sobre um determinado estado, priorizando a consistência em vez da disponibilidade. Para a aprovação de operações de leitura e gravação, é necessário o consentimento da maioria dos nós Zookeeper.
O Zookeeper armazena o estado do cluster:
- Lista de tópicos, partições, configurações, réplicas líderes atuais, réplicas preferenciais.
- Membros do cluster. Cada corretor envia pings para o cluster Zookeeper. Se não receber um ping dentro de um período de tempo definido, o Zookeeper registra o corretor como indisponível.
- Escolha de nós primário e reserva para o controlador.
O nó controlador é um dos corretores Kafka responsável pela eleição dos líderes das réplicas. O Zookeeper envia notificações ao controlador sobre mudanças na membresia do cluster e mudanças nos tópicos, e o controlador deve agir de acordo com essas mudanças.
Por exemplo, vamos considerar um novo tópico com dez partições e um fator de replicação de 3. O controlador deve escolher um líder para cada partição, tentando distribuir os líderes entre os corretores de forma otimizada.
Para cada partição, o controlador:
- atualiza as informações no Zookeeper sobre ISR e líder;
- envia o comando LeaderAndISRCommand a cada corretor que hospeda uma réplica dessa partição, informando os corretores sobre ISR e líder.
Quando um corretor com o líder falha, o Zookeeper envia uma notificação ao controlador, e este escolhe um novo líder. Novamente, o controlador atualiza primeiro o Zookeeper e, em seguida, envia um comando a cada corretor, informando-os sobre a mudança de liderança.
Cada líder é responsável pelo conjunto de ISR. A configuração replica.lag.time.max.ms determina quem estará incluído. Ao mudar o ISR, o líder comunica ao Zookeeper as novas informações.
O Zookeeper está sempre informado sobre quaisquer mudanças, para que em caso de falha a liderança transite suavemente para o novo líder.
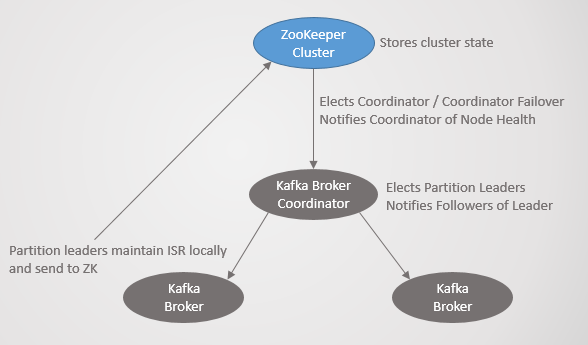
Fig. 21. Consenso Kafka
Protocolo de replicação
Entender os detalhes da replicação ajuda a compreender melhor os cenários potenciais de perda de dados.
Solicitações de coleta, Log End Offset (LEO) e Highwater Mark (HW)
Analisamos que os followers periodicamente enviam solicitações ao líder para busca (fetch). O intervalo padrão é de 500 ms. Isso difere do RabbitMQ, pois, no RabbitMQ, a replicação é iniciada não pelo espelho da fila, mas pelo mestre. O mestre envia as alterações para os espelhos.
O líder e todos os followers mantêm o deslocamento do final do log (Log End Offset, LEO) e a marca Highwater (HW). A marca LEO armazena o deslocamento da última mensagem na réplica local, enquanto a HW armazena o deslocamento do último commit. Lembre-se de que, para o status 'commit', a mensagem deve ser salva em todas as réplicas ISR. Isso significa que o LEO geralmente está ligeiramente à frente da HW.
Quando o líder recebe uma mensagem, ele a salva localmente. O follower faz uma solicitação de busca, enviando seu LEO. O líder então envia um pacote de mensagens, começando a partir desse LEO, e também envia a HW atual. Quando o líder recebe a informação de que todas as réplicas salvaram a mensagem com o deslocamento especificado, ele move a marca HW. Apenas o líder pode mover a HW, e assim todos os followers conseguem saber o valor atual nas respostas às suas solicitações. Isso significa que os followers podem ficar atrás do líder tanto em mensagens quanto em relação ao conhecimento da HW. Os consumidores recebem mensagens apenas até a HW atual.
Observe que 'persistido' significa gravado na memória, e não no disco. Para desempenho, o Kafka sincroniza no disco com um intervalo específico. O RabbitMQ também possui esse intervalo, mas enviará a confirmação ao publisher apenas depois que o mestre e todos os espelhos gravarem a mensagem no disco. Os desenvolvedores do Kafka decidiram, por motivos de desempenho, enviar ack assim que a mensagem estiver gravada na memória. O Kafka aposta que a redundância compensa o risco de armazenar confirmados apenas na memória a curto prazo.
Falha do líder
Quando o líder falha, o Zookeeper notifica o controlador, que escolhe uma nova réplica para líder. O novo líder estabelece uma nova marca HW de acordo com seu LEO. Em seguida, as informações sobre o novo líder são recebidas pelos followers. Dependendo da versão do Kafka, o follower escolherá um dos dois cenários:
- Truncará o log local até a HW conhecida e enviará ao novo líder uma solicitação por mensagens após essa marca.
- Envie uma solicitação ao líder para verificar o HW no momento em que foi escolhido como líder e, em seguida, truncará o log até esse deslocamento. Em seguida, começará a fazer solicitações periódicas de amostragem, começando a partir desse deslocamento.
O seguidor pode precisar truncar o log por vários motivos:
- Quando ocorre uma falha do líder, o primeiro seguidor do conjunto ISR registrado no Zookeeper vence as eleições e se torna o líder. Todos os seguidores no ISR, embora considerados "sincronizados", podem não ter recebido copias de todas as mensagens do antigo líder. É muito possível que o seguidor escolhido não tenha a cópia mais atualizada. Kafka garante que não há discrepâncias entre as réplicas. Assim, para evitar divergências, cada seguidor deve truncar seu log até o valor HW do novo líder no momento de sua eleição. Essa é mais uma razão pela qual a configuração acks=all é importante para a consistência.
- As mensagens são periodicamente gravadas no disco. Se todos os nós do cluster falharem ao mesmo tempo, as réplicas terão deslocamentos diferentes nos discos. É bem possível que, quando os corretores voltem à rede, o novo líder a ser eleito fique atrás de seus seguidores, pois ele foi salvo no disco antes dos outros.
Reconectando-se ao cluster
Ao reconectar-se ao cluster, as réplicas são tratadas da mesma forma que em caso de falha do líder: verificam a réplica do líder e truncam seu log até seu HW (no momento da eleição). Em contraste, o RabbitMQ considera que nós reconectados são completamente novos. Em ambos os casos, o corretor descarta qualquer estado existente. Se a sincronização automática estiver sendo utilizada, o mestre deve replicar absolutamente todo o conteúdo atual para o novo espelho de forma que "e que o mundo espere". Durante essa operação, o mestre não aceita nenhuma operação de leitura ou gravação. Essa abordagem cria problemas em grandes filas.
Kafka é um log distribuído e, de forma geral, ele armazena mais mensagens do que uma fila RabbitMQ, onde os dados são removidos da fila após serem lidos. Filas ativas devem permanecer relativamente pequenas. No entanto, o Kafka é um log com sua própria política de armazenamento, que pode definir um prazo de dias ou semanas. A abordagem com bloqueio de filas e sincronização completa é absolutamente inaceitável para um log distribuído. Em vez disso, os followers do Kafka simplesmente cortam seu log até o líder HW (no momento de sua eleição) caso sua cópia ultrapasse o líder. No caso mais provável, onde o follower está atrasado, ele simplesmente começa a fazer solicitações de recuperação, começando pelo seu LEO atual.
Novos ou reassociados followers começam fora do ISR e não participam dos commits. Eles simplesmente trabalham ao lado do grupo, recebendo mensagens tão rapidamente quanto conseguem, até alcançarem o líder e entrarem no ISR. Aqui não há bloqueio e não é necessário descartar todos os seus dados.
Divisão de Coesão
O Kafka tem mais componentes do que o RabbitMQ, portanto, há um conjunto mais complexo de comportamentos quando a conectividade do cluster é interrompida. Mas o Kafka foi projetado originalmente para clusters, então as soluções são muito bem pensadas.
Abaixo estão alguns cenários de interrupção de conectividade:
- Cenário 1. O follower não vê o líder, mas ainda vê o Zookeeper.
- Cenário 2. O líder não vê nenhum follower, mas ainda vê o Zookeeper.
- Cenário 3. O follower vê o líder, mas não vê o Zookeeper.
- Cenário 4. O líder vê os followers, mas não vê o Zookeeper.
- Cenário 5. O follower está completamente isolado tanto dos outros nós Kafka quanto do Zookeeper.
- Cenário 6. O líder está completamente isolado tanto dos outros nós Kafka quanto do Zookeeper.
- Cenário 7. O nó Controller do Kafka não vê outro nó Kafka.
- Cenário 8. O Controller do Kafka não vê o Zookeeper.
Para cada cenário, há um comportamento específico.
Cenário 1. O follower não vê o líder, mas ainda vê o Zookeeper.
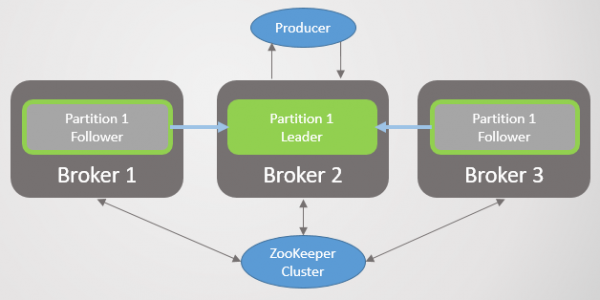
Fig. 22. Cenário 1. ISR de três réplicas.
A interrupção de conectividade isola o broker 3 dos brokers 1 e 2, mas não do Zookeeper. O broker 3 não pode mais fazer solicitações de recuperação. Após um certo tempo. replica.lag.time.max.ms ele é removido do ISR e não participa dos commits de mensagens. Assim que a conectividade for restaurada, ele reiniciará as solicitações de recuperação e se juntará ao ISR quando alcançar o líder. O Zookeeper continuará recebendo pings e considerará que o corretor está vivo e saudável.
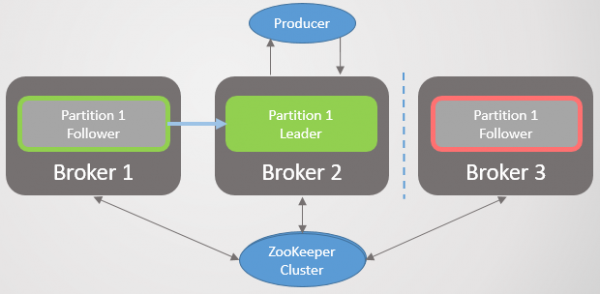
Fig. 23. Cenário 1. O corretor é removido do ISR se não houver solicitação de recuperação recebida dentro do intervalo replica.lag.time.max.ms
Não há nenhuma divisão lógica (split-brain) ou suspensão do nó, como no RabbitMQ. Em vez disso, a redundância diminui.
Cenário 2. O líder não vê nenhum follower, mas ainda vê o Zookeeper
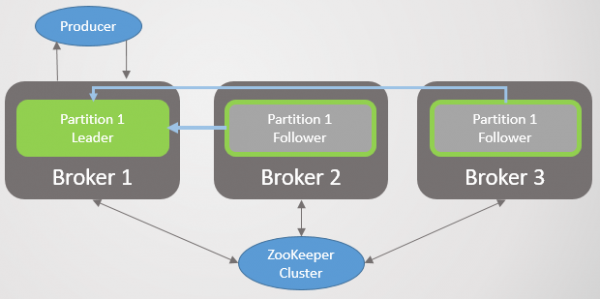
Fig. 24. Cenário 2. O líder e dois followers
A perda de conectividade de rede separa o líder dos followers, mas o corretor ainda vê o Zookeeper. Como no primeiro cenário, o ISR é comprimido, mas desta vez apenas até o líder, uma vez que todos os followers param de enviar solicitações de recuperação. Novamente, não há divisão lógica. Em vez disso, há uma perda de redundância para novas mensagens, até que a conectividade seja restaurada. O Zookeeper continua recebendo pings e considera que o corretor está vivo e saudável.
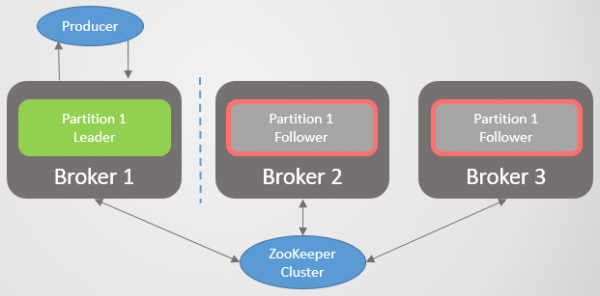
Fig. 25. Cenário 2. O ISR se comprimiu apenas até o líder
Cenário 3. O follower vê o líder, mas não vê o Zookeeper
O follower é separado do Zookeeper, mas não do corretor com o líder. Como resultado, o follower continua fazendo solicitações de recuperação e sendo membro do ISR. O Zookeeper não recebe mais pings e registra a queda do corretor, mas como este é apenas um follower, não há consequências após a recuperação.
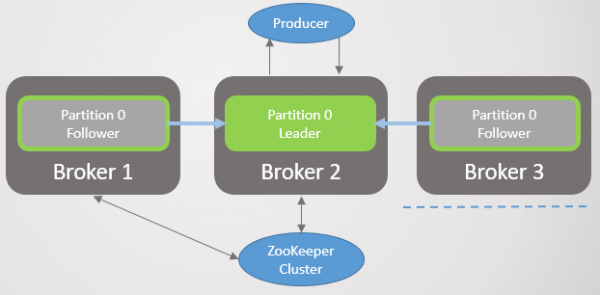
Fig. 26. Cenário 3. O follower continua enviando solicitações de recuperação ao líder
Cenário 4. O líder vê os followers, mas não vê o Zookeeper
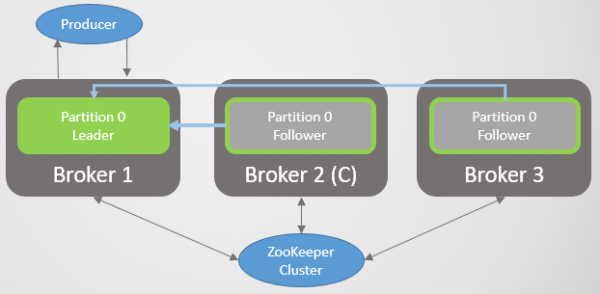
Fig. 27. Cenário 4. O líder e dois followers
O líder está separado do Zookeeper, mas não dos corretores com os followers.
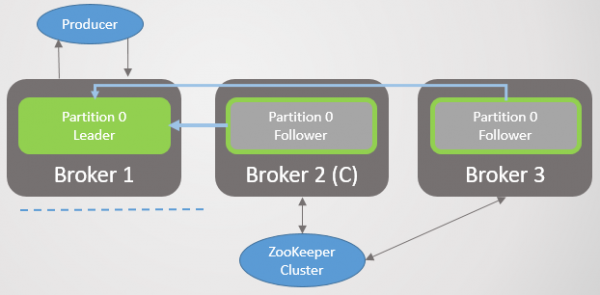
Fig. 28. Cenário 4. O líder está isolado do Zookeeper
Após algum tempo, o Zookeeper registrará a queda do corretor e notificará o controlador. Este escolherá um novo líder entre os followers. No entanto, o líder original continuará pensando que é o líder e continuará aceitando registros com acks=1. Os followers não lhe enviam mais solicitações de recuperação, então ele os considerará mortos e tentará comprimir o ISR até si mesmo. Mas como ele não tem conexão com o Zookeeper, não conseguirá fazer isso e, a esse ponto, desistirá de aceitar mais registros.
Mensagens acks=all não receberão confirmações, porque inicialmente o ISR inclui todas as réplicas, e as mensagens não chegam a elas. Quando o líder original tentar removê-las do ISR, não conseguirá e, de fato, deixará de aceitar qualquer mensagem.
Os clientes logo percebem a troca de líder e começam a enviar registros para o novo servidor. Assim que a rede se restabelece, o líder original vê que não é mais o líder e corta seu log para o valor do HW que o novo líder tinha no momento da falha, para evitar a divergência de logs. Então, começará a enviar solicitações para o novo líder. Todos os registros do líder original que não foram replicados para o novo líder se perdem. Ou seja, mensagens que não foram confirmadas pelo líder original nos poucos segundos em que funcionaram dois líderes serão perdidas.
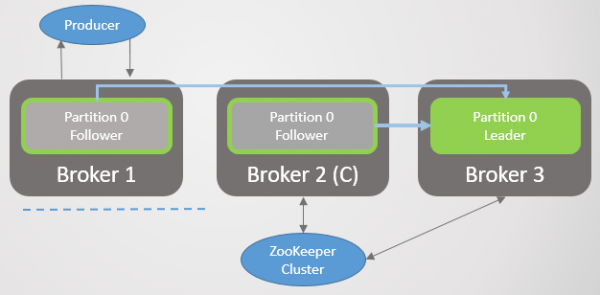
Fig. 29. Cenário 4. O líder no broker 1 torna-se follower após a recuperação da rede
Cenário 5. O follower está completamente isolado tanto de outros nós Kafka quanto do Zookeeper
O follower está completamente isolado tanto de outros nós Kafka quanto do Zookeeper. Ele simplesmente é removido do ISR até que a rede se restabeleça, e depois alcança os demais.

Fig. 30. Cenário 5. O follower isolado é removido do ISR
Cenário 6. O líder está totalmente isolado de outros nós Kafka e do Zookeeper
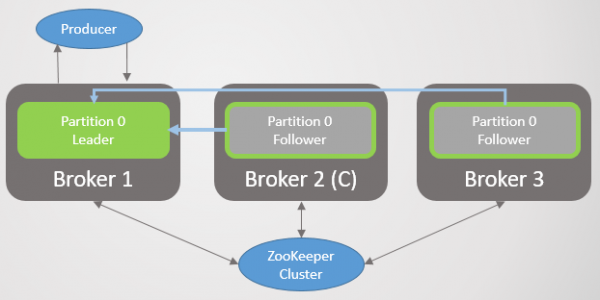
Fig. 31. Cenário 6. Líder e dois followers
O líder está completamente isolado de seus followers, do controlador e do Zookeeper. Por um breve período, continuará aceitando registros com acks=1.
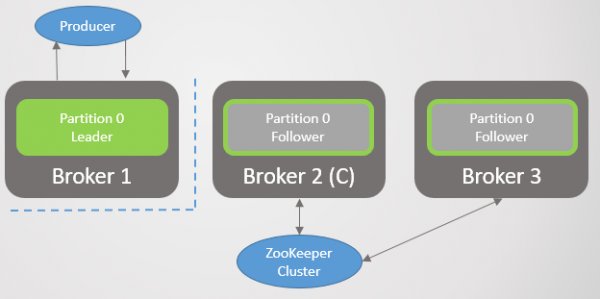
Fig. 32. Cenário 6. Isolamento do líder de outros nós Kafka e do Zookeeper
Não recebendo solicitações após replica.lag.time.max.ms, ele tentará contrair o ISR para si mesmo, mas não conseguirá, pois não há conexão com o Zookeeper, então ele deixará de aceitar registros.
Enquanto isso, o Zookeeper marcará o broker isolado como morto, e o controlador escolherá um novo líder.
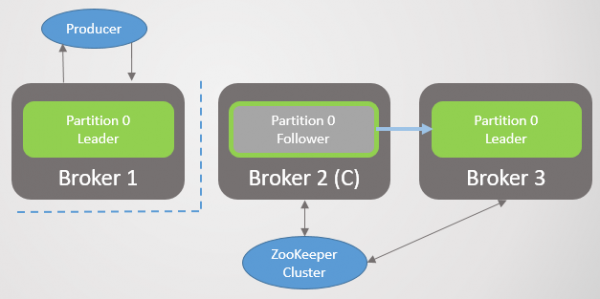
Fig. 33. Cenário 6. Dois líderes
O líder original pode aceitar registros por alguns segundos, mas depois para de aceitar quaisquer mensagens. Os clientes atualizam a cada 60 segundos com os últimos metadados. Eles serão informados sobre a troca de líder e começarão a enviar registros para o novo líder.
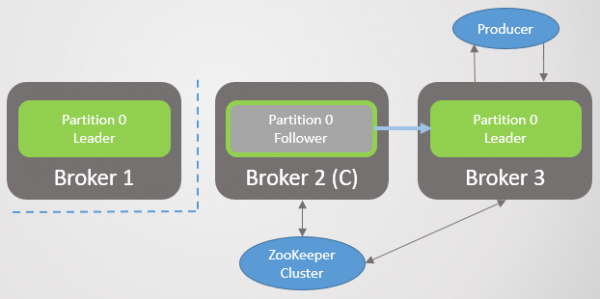
Fig. 34. Cenário 6. Produtores mudam para o novo líder
Todas as gravações confirmadas feitas pelo líder original desde a perda de conectividade serão perdidas. Assim que a rede for restaurada, o líder original, através do Zookeeper, descobrirá que não é mais o líder. Em seguida, ele truncará seu log até o HW do novo líder no momento da eleição e começará a enviar solicitações como seguidor.
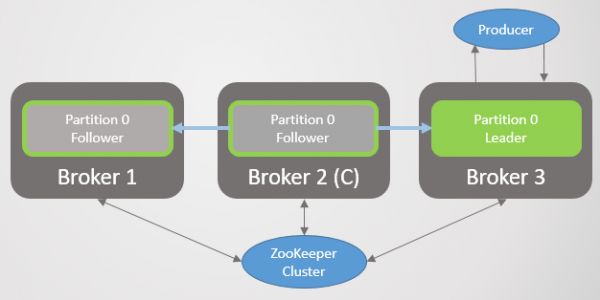
Fig. 35. Cenário 6. O líder original se torna um seguidor após a restauração da conectividade da rede
Nesta situação, por um curto período, pode haver uma divisão lógica, mas apenas se acks=1 e min.insync.replicas também 1. A divisão lógica se encerra automaticamente ou após a restauração da rede, quando o líder original percebe que não é mais líder, ou quando todos os clientes entendem que o líder mudou e começam a escrever ao novo líder — dependendo do que acontece primeiro. De qualquer forma, ocorrerá a perda de algumas mensagens, mas apenas com acks=1.
Há outra variação deste cenário, onde, imediatamente antes da divisão da rede, os seguidores se atrasaram, e o líder reduziu o ISR a apenas ele mesmo. Em seguida, ele se isola devido à perda de conectividade. Um novo líder é eleito, mas o líder original continua recebendo gravações, mesmo acks=all, porque não há mais ninguém no ISR além dele. Essas gravações serão perdidas após a recuperação da rede. A única maneira de evitar tal cenário é min.insync.replicas = 2.
Cenário 7. O controlador Kafka não vê outro nó Kafka
De maneira geral, após perder a conexão com o nó Kafka, o controlador não conseguirá enviar qualquer informação sobre a mudança de líder. No pior cenário, isso levará a uma divisão lógica de curto prazo, como no cenário 6. Na maioria das vezes, o broker simplesmente não se tornará um candidato a liderança em caso de falha do último.
Cenário 8. O controlador Kafka não vê o Zookeeper
O controlador que caiu não receberá o ping do Zookeeper e elegerá um novo nó Kafka como controlador. O controlador original pode continuar se apresentando como tal, mas não receberá notificações do Zookeeper, portanto não terá tarefas a cumprir. Assim que a rede for restaurada, ele perceberá que não é mais o controlador e se tornou um nó Kafka comum.
Conclusões dos cenários
Observamos que a perda de conectividade dos seguidores não leva à perda de mensagens, mas simplesmente reduz temporariamente a redundância até que a rede seja restaurada. Isso, é claro, pode resultar em perda de dados se um ou mais nós forem perdidos.
Se, devido à perda de conectividade, o líder se desligar do Zookeeper, isso pode levar à perda de mensagens com acks=1. A ausência de conexão com o Zookeeper provoca uma breve divisão lógica com dois líderes. Este problema é resolvido pelo parâmetro acks=all.
Parâmetro min.insync.replicas com duas ou mais réplicas que oferece garantias adicionais de que tais cenários de curto prazo não levarão à perda de mensagens, como no cenário 6.
Resumo sobre a perda de mensagens
Vamos listar todas as maneiras pelas quais os dados podem ser perdidos no Kafka:
- Qualquer falha do líder, se as mensagens forem confirmadas com acks=1
- Qualquer transição suja (unclean) de liderança, ou seja, para um seguidor fora do ISR, mesmo com acks=all
- A exclusão do líder do Zookeeper, se as mensagens forem confirmadas com acks=1
- Isolamento completo do líder, que já reduziu o grupo ISR apenas a si mesmo. Todas as mensagens serão perdidas, mesmo acks=all. Isso é verdade apenas se min.insync.replicas=1.
- Falhas simultâneas de todos os nós da partição. Como as mensagens são confirmadas na memória, algumas podem ainda não ter sido gravadas em disco. Após a reinicialização dos servidores, algumas mensagens podem estar ausentes.
Transições sujas de liderança podem ser evitadas, seja proibindo-as ou garantindo redundância de pelo menos duas. A configuração mais robusta é uma combinação de acks=all e min.insync.replicas mais de 1.
Comparação direta da confiabilidade entre RabbitMQ e Kafka
Para garantir confiabilidade e alta disponibilidade, ambas as plataformas implementam um sistema de replicação primária e secundária. No entanto, o RabbitMQ possui um calcanhar de Aquiles. Ao se reconectar após uma falha, os nós descartam seus dados e a sincronização é bloqueada. Esse duplo golpe questiona a durabilidade de grandes filas no RabbitMQ. Você terá que se contentar com a redução da redundância ou com longos bloqueios. A redução da redundância aumenta o risco de perda massiva de dados. Mas se as filas forem pequenas, para garantir redundância com períodos curtos de indisponibilidade (alguns segundos), isso pode ser resolvido com tentativas de reconexão.
No Kafka não tem esse problema. Ela descarta dados apenas no ponto de divergência entre o líder e o seguidor. Todos os dados comuns são mantidos. Além disso, a replicação não bloqueia o sistema. O líder continua a aceitar gravações enquanto um novo seguidor o alcança, tornando a conexão ou reconexão do cluster uma tarefa trivial para os devops. Claro, ainda existem problemas, como a largura de banda da rede durante a replicação. Se vários seguidores são adicionados ao mesmo tempo, pode-se enfrentar o limite de largura de banda.
RabbitMQ supera Kafka em confiabilidade durante a falha simultânea de vários servidores em um cluster. Como já mencionamos, o RabbitMQ envia uma confirmação ao publicador somente após gravar a mensagem no disco do mestre e em todas as cópias. Mas isso adiciona uma latência extra por duas razões:
- fsync a cada algumas centenas de milissegundos
- Falhas nas cópias só podem ser notadas após o tempo de vida dos pacotes, que verificam a disponibilidade de cada nó (net tick). Se a cópia estiver lenta ou falhar, isso adiciona uma latência.
Kafka aposta que se a mensagem é armazenada em vários nós, pode-se confirmar mensagens assim que elas entram na memória. Isso cria o risco de perda de mensagens de qualquer tipo (até mesmo acks=all, min.insync.replicas=2) em caso de falha simultânea.
De forma geral, a Kafka demonstra melhor desempenho e é projetada inicialmente para clusters. O número de seguidores pode ser aumentado para 11 se necessário para confiabilidade. Uma taxa de replicação de 5 e um número mínimo de réplicas em estado sincronizado min.insync.replicas=3 tornam a perda de mensagens um evento muito raro. Se sua infraestrutura pode garantir tal taxa de replicação e nível de redundância, você pode escolher essa opção.
A clusterização do RabbitMQ é boa para filas pequenas. Mas até mesmo filas pequenas podem crescer rapidamente em grandes tráfegos. Assim que as filas se tornam grandes, será necessário fazer uma escolha difícil entre disponibilidade e confiabilidade. A clusterização do RabbitMQ é mais adequada para situações menos típicas, onde as vantagens da flexibilidade do RabbitMQ superam as desvantagens de sua clusterização.
Uma das soluções para a vulnerabilidade do RabbitMQ em relação a filas grandes é dividi-las em várias menores. Se não exigir a completa ordenação de toda a fila, mas apenas das mensagens relevantes (por exemplo, mensagens de um cliente específico), ou até mesmo não ordenar nada, essa abordagem é aceitável: veja meu projeto para a divisão da fila (o projeto ainda está em fase inicial).
Por fim, não se esqueça de uma série de bugs nos mecanismos de clusterização e replicação tanto do RabbitMQ quanto do Kafka. Com o tempo, os sistemas se tornaram mais maduros e estáveis, mas nenhuma mensagem estará 100% protegida contra perda! Além disso, grandes falhas ocorrem nos data centers!
Se eu perdi algo, cometi um erro ou você discorda de qualquer uma das afirmações, não hesite em deixar um comentário ou entrar em contato comigo.
Muitas vezes me perguntam: “O que escolher, Kafka ou RabbitMQ?”, “Qual plataforma é melhor?”. A verdade é que isso realmente depende da sua situação, experiência atual, etc. Não me atrevo a expressar minha opinião, pois seria uma grande simplificação recomendar uma única plataforma para todos os casos de uso e possíveis limitações. Escrevi esse ciclo de artigos para que você possa formar sua própria opinião.
Quero destacar que ambos os sistemas são líderes na área. Talvez eu esteja um pouco enviesado, pois, com base na experiência dos meus projetos, valorizo mais coisas como a garantia de ordenação de mensagens e confiabilidade.
Vejo outras tecnologias que carecem dessa confiabilidade e garantia de ordenação, então olho para o RabbitMQ e Kafka — e reconheço o valor incrível de ambos esses sistemas.
Fonte: habr.com
