

A resiliência e alta disponibilidade são grandes tópicos, então dedicaremos artigos separados ao RabbitMQ e ao Kafka. Este artigo é sobre o RabbitMQ, e o próximo será sobre o Kafka, em comparação com o RabbitMQ. O artigo é longo, então acomode-se confortavelmente.
Vamos considerar as estratégias de resiliência, consistência e alta disponibilidade (HA), assim como os compromissos que devem ser feitos em cada estratégia. O RabbitMQ pode operar em um cluster de nós — e, nesse caso, é classificado como um sistema distribuído. Quando falamos de sistemas distribuídos, frequentemente tratamos de consistência e disponibilidade.
Esses conceitos descrevem como um sistema se comporta durante uma falha. Falha de conexão de rede, falha de servidor, falha de disco rígido, indisponibilidade temporária do servidor devido a coleta de lixo, perda de pacotes ou lentidão na conexão de rede. Tudo isso pode causar perda de dados ou conflitos. Aparentemente, é praticamente impossível manter um sistema que seja simultaneamente e totalmente consistente (sem perda de dados, sem divergências) e disponível (que aceite operações de leitura e gravação) para todas as possíveis falhas.
Veremos que consistência e disponibilidade estão em extremos opostos do espectro, e você precisa escolher para que lado otimizar. A boa notícia é que, com o RabbitMQ, essa escolha é possível. Você tem essas 'alavancas de nerd' para deslocar o equilíbrio em direção a maior consistência ou maior disponibilidade.
Vamos prestar atenção especial às configurações que podem levar à perda de dados devido a confirmações de gravação. Há uma cadeia de responsabilização entre publicadores, corretores e consumidores. Depois que a mensagem é entregue ao corretor, é trabalho dele não perder a mensagem. Quando o corretor confirma ao publicador que recebeu a mensagem, não esperamos que ela seja perdida. Mas veremos que isso realmente pode acontecer, dependendo da configuração do seu corretor e publicador.
Primitivos de resiliência de um único nó
Filas resistentes / roteamento
No RabbitMQ, existem dois tipos de filas: duráveis (durable) e não duráveis (non-durable). Todas as filas são armazenadas no banco de dados Mnesia. Filas duráveis são reapresentadas ao iniciar o nó e, assim, sobrevivem a reinícios, falhas de sistema ou de servidor (desde que os dados sejam mantidos). Isso significa que enquanto você declarar o roteamento (exchange) e a fila como duráveis, a infraestrutura de filas/roteamento retornará ao modo operacional.
Filas não duráveis e roteamento são eliminados ao reiniciar o nó.
Mensagens duráveis
O fato de uma fila ser durável não significa que todas as suas mensagens sobreviverão ao reinício do nó. Apenas as mensagens marcadas pelo publicador como duráveis (persistent) serão recuperadas. Mensagens duráveis realmente criam uma carga adicional no broker, mas se a perda de uma mensagem for inaceitável, não há outra alternativa.
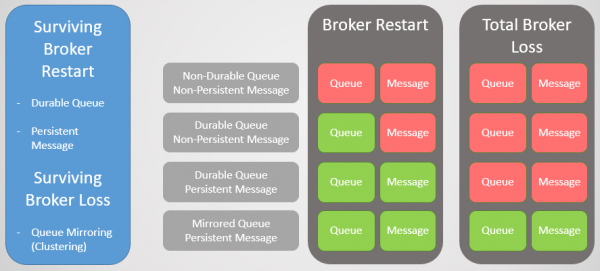
Fig. 1. Matriz de durabilidade
Clusterização com espelhamento de filas
Para sobreviver à perda do broker, precisamos de redundância. Podemos unir vários nós RabbitMQ em um cluster e, em seguida, adicionar redundância adicional através da replicação de filas entre vários nós. Assim, se um nó falhar, não perderemos dados e permaneceremos acessíveis.
Espelhamento de filas:
- uma fila principal (mestre), que recebe todos os comandos de gravação e leitura
- uma ou várias réplicas, que recebem todas as mensagens e metadados da fila principal. Essas réplicas existem não para escalabilidade, mas exclusivamente para redundância.
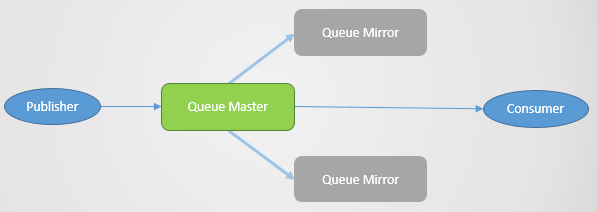
Fig. 2. Espelhamento de filas
O espelhamento é configurado através de uma política correspondente. Nela, é possível escolher o coeficiente de replicação e até mesmo os nós onde a fila deve ser hospedada. Exemplos:
ha-mode: allha-mode: exactly, ha-params: 2(um mestre e uma réplica)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Confirmação para o publicador
Para garantir a gravação consistente, são necessárias confirmações do editor (Publisher Confirms). Sem elas, há risco de perda de mensagens. A confirmação é enviada ao editor após a gravação da mensagem no disco. O RabbitMQ grava mensagens no disco não ao recebê-las, mas em uma base periódica, na ordem de algumas centenas de milissegundos. Quando a fila é espelhada, a confirmação é enviada apenas depois que todos os espelhos também gravaram sua cópia da mensagem no disco. Isso significa que o uso de confirmações adiciona alguma latência, mas se a segurança dos dados é importante, elas são necessárias.
Fila à prova de falhas
Quando o broker é desligado ou falha, todas as filas principais (mestres) neste nó falham junto com ele. O cluster então seleciona o espelho mais antigo de cada mestre e o promove como novo mestre.
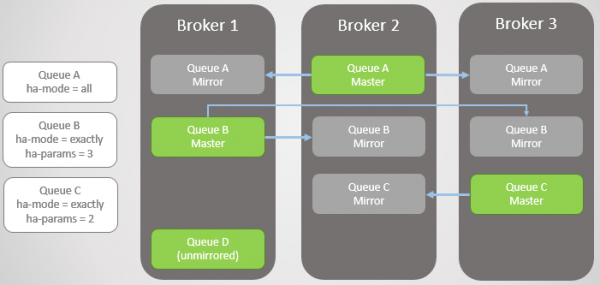
Fig. 3. Várias filas espelhadas e suas políticas
O Broker 3 falha. Observe que o espelho da Fila C no Broker 2 é promovido a mestre. Também note que um novo espelho para a Fila C é criado no Broker 1. O RabbitMQ sempre tenta manter a taxa de replicação especificada em suas políticas.
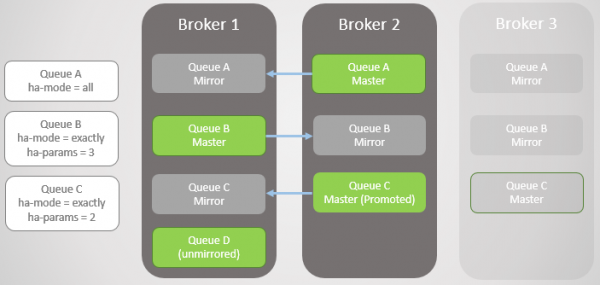
Fig. 4. Broker 3 falha, causando a falha da fila C
O próximo Broker 1 falha! Só temos um broker restante. O espelho da Fila B é promovido a mestre.
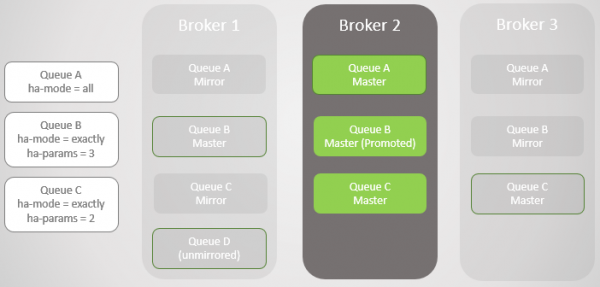
Fig. 5
Recuperamos o Broker 1. Independentemente de quão bem os dados sobreviveram à perda e à recuperação do broker, todas as mensagens espelhadas da fila são descartadas ao reiniciar. É importante notar isso, pois haverá consequências. Em breve, abordaremos essas consequências. Assim, o Broker 1 agora é novamente um membro do cluster, e o cluster tenta seguir as políticas e, portanto, cria espelhos no Broker 1.
Neste caso, a perda do Broker 1 foi completa, assim como a perda dos dados, portanto a Fila B não espelhada foi totalmente perdida.
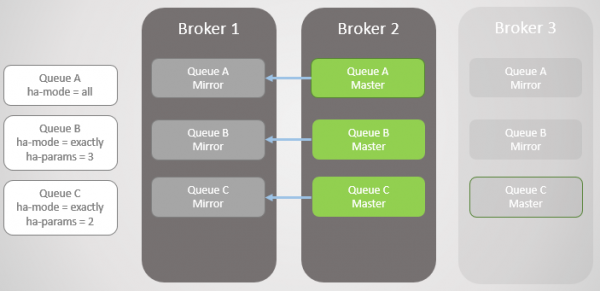
Fig. 6. O Broker 1 volta ao funcionamento
O Broker 3 voltou ao funcionamento, então as filas A e B estão recuperando os espelhos criados nele para atender às suas políticas de HA. Mas agora todas as filas principais estão em um único nó! Isso não é ideal, é melhor ter uma distribuição uniforme entre os nós. Infelizmente, não há muitas opções para reequilibrar os mestres. Voltaremos a este problema mais tarde, pois precisamos primeiro considerar a sincronização da fila.
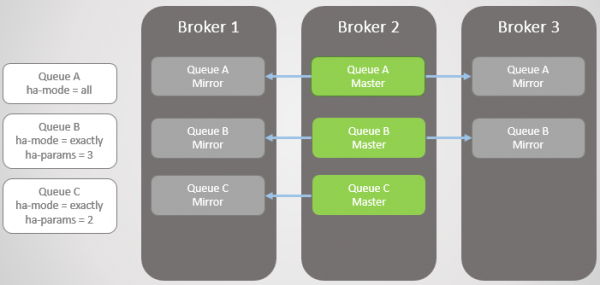
Fig. 7. O Broker 3 retorna ao funcionamento. Todas as filas principais em um único nó!
Assim, agora você deve ter uma ideia de como os espelhos garantem redundância e resistência a falhas. Isso garante a disponibilidade em caso de falha de um nó e protege contra perda de dados. Mas ainda não terminamos, pois na verdade tudo é muito mais complexo.
Sincronização
Ao criar um novo espelho, todas as novas mensagens sempre serão replicadas para esse espelho e quaisquer outros. Quanto aos dados existentes na fila principal, podemos replicá-los no novo espelho, que se torna uma cópia completa do mestre. Também podemos optar por não replicar mensagens existentes e permitir que a fila principal e o novo espelho se sincronizem ao longo do tempo, enquanto novas mensagens são adicionadas ao final e mensagens existentes são removidas do início da fila principal.
Essa sincronização é realizada automaticamente ou manualmente e é gerenciada através de uma política de filas. Vamos considerar um exemplo.
Temos duas filas espelhadas. A fila A é sincronizada automaticamente e a fila B manualmente. Ambas as filas têm dez mensagens.
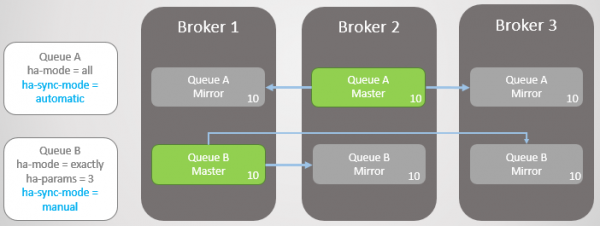
Fig. 8. Duas filas com diferentes modos de sincronização
Agora estamos perdendo o Broker 3.
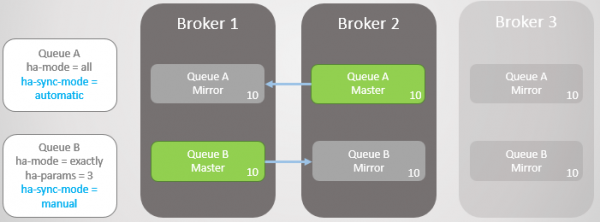
Fig. 9. O Broker 3 caiu
O Broker 3 retorna ao funcionamento. O cluster cria um espelho para cada fila em um novo nó e sincroniza automaticamente a nova Fila A com o mestre. No entanto, o espelho da nova Fila B permanece vazio. Portanto, temos total redundância da Fila A e apenas um espelho para as mensagens existentes da Fila B.
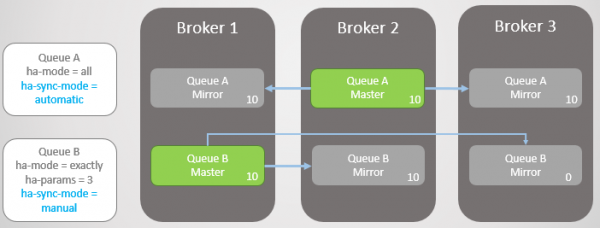
Fig. 10. O novo espelho da Fila A recebe todas as mensagens existentes, enquanto o novo espelho da Fila B não recebe nenhuma.
Em ambas as filas, mais dez mensagens são recebidas. Em seguida, o Broker 2 falha e a Fila A reverte para o espelho mais antigo, que está no Broker 1. Não há perda de dados durante a falha. Na Fila B, há vinte mensagens no mestre e apenas dez no espelho, pois essa fila nunca replicou as dez mensagens originais.
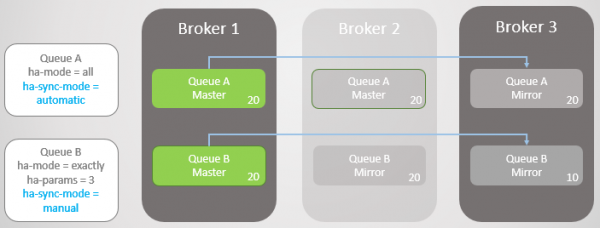
Fig. 11. A Fila A reverte para o Broker 1 sem perda de mensagens.
Em ambas as filas, mais dez mensagens são recebidas. Agora, o Broker 1 falha. A Fila A muda para o espelho sem perder mensagens. No entanto, a Fila B enfrenta problemas. Nesse estágio, podemos otimizar a disponibilidade ou consistência.
Se quisermos otimizar a disponibilidade, a política ha-promote-on-failure deve ser definida como always. Esse é o valor padrão, então podemos simplesmente não especificar a política. Nesse caso, em essência, estamos permitindo falhas em espelhos não sincronizados. Isso resultará em perda de mensagens, mas a fila permanece acessível para leitura e gravação.
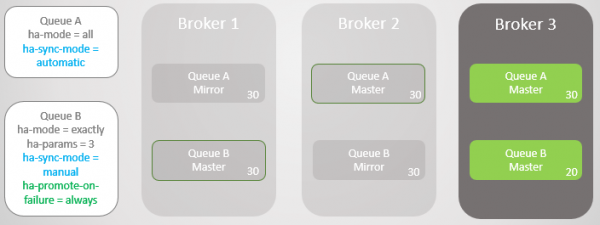
Fig. 12. A Fila A reverte para o Broker 3 sem perda de mensagens. A Fila B reverte para o Broker 3 com perda de dez mensagens.
Também podemos definir ha-promote-on-failure como valor when-synced. Nesse caso, em vez de reverter para o espelho, a fila aguardará até que o Broker 1 com seus dados retorne ao modo operacional. Após seu retorno, a fila principal volta a estar no Broker 1 sem perda de dados. A disponibilidade é sacrificada em nome da segurança dos dados. Mas esse é um modo arriscado que pode levar até mesmo à perda total de dados, o que abordaremos em breve.
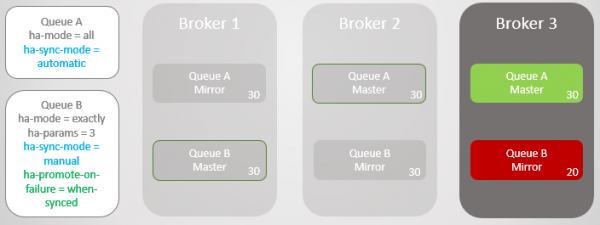
Fig. 13. A Fila B permanece indisponível após a falha do Broker 1.
Você pode se perguntar: “Talvez seja melhor nunca usar sincronização automática?”. A resposta é que a sincronização é uma operação bloqueadora. Durante a sincronização, a fila principal não pode executar nenhuma operação de leitura ou gravação!
Vamos considerar um exemplo. Agora temos filas muito grandes. Como elas podem crescer tanto? Por várias razões:
- As filas não estão sendo ativamente usadas.
- Estas são filas de alta velocidade, e neste momento os consumidores estão funcionando lentamente.
- Estas são filas de alta velocidade, houve uma falha, e os consumidores estão se recuperando.
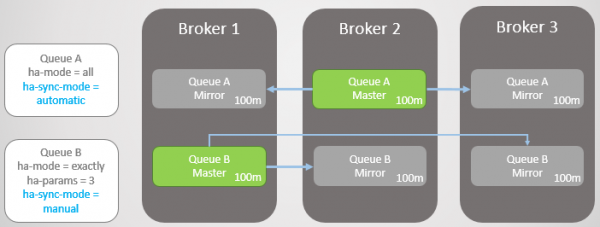
Fig. 14. Duas grandes filas com diferentes modos de sincronização
Agora cai o Broker 3.
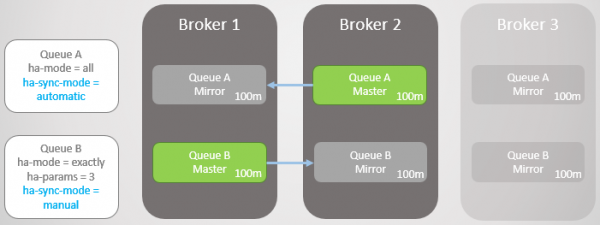
Fig. 15. O Broker 3 cai, deixando um mestre e um espelho em cada fila
O Broker 3 retorna ao funcionamento, e novos espelhos são criados. A Fila Principal A começa a replicar mensagens existentes em um novo espelho, e durante esse tempo a Fila fica indisponível. A replicação de dados leva duas horas, resultando em duas horas de inatividade para essa Fila!
No entanto, a Fila B permanece disponível durante todo o período. Ela sacrificou alguma redundância em prol da disponibilidade.
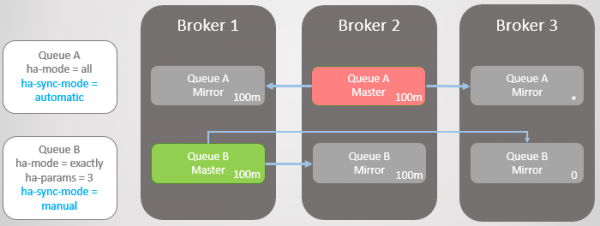
Fig. 16. A fila permanece indisponível durante a sincronização
Após duas horas, a Fila A também se torna disponível e pode novamente começar a aceitar operações de leitura e gravação.
Atualizações
Esse comportamento de bloqueio durante a sincronização dificulta a atualização de clusters com filas muito grandes. Em algum momento, o nó com o mestre precisa ser reiniciado, o que significa mudar para o espelho ou desligar a fila durante a atualização do servidor. Se optarmos pela mudança, perderemos mensagens se os espelhos não estiverem sincronizados. Por padrão, durante a desconexão do broker, a mudança para o espelho não sincronizado não é realizada. Isso significa que, assim que o broker retorna, não perdemos nenhuma mensagem, com o único dano sendo a inatividade da fila. As regras de comportamento durante a desconexão do broker são definidas pela política ha-promote-on-shutdown. É possível definir um dos dois valores:
always= habilitar a mudança para espelhos não sincronizadoswhen-synced= mudança apenas para espelho sincronizado, caso contrário, a fila se torna indisponível para leitura e gravação. A fila retorna ao funcionamento assim que o broker voltar
De qualquer forma, com filas grandes, é preciso escolher entre a perda de dados e a indisponibilidade.
Quando a disponibilidade aumenta a segurança dos dados
Antes de tomar uma decisão, é preciso considerar mais uma complicação. Embora a sincronização automática seja melhor para redundância, como isso afeta a segurança dos dados? Certamente, graças à melhor redundância, o RabbitMQ tem menor probabilidade de perder mensagens existentes, mas e quanto às novas mensagens dos publishers?
Aqui é preciso considerar o seguinte:
- Um publisher pode simplesmente retornar um erro e o serviço superior ou o usuário tentarem novamente mais tarde?
- Um publisher pode salvar a mensagem localmente ou em um banco de dados, para tentar novamente mais tarde?
Se um publisher só pode descartar a mensagem, então, na verdade, a melhoria da disponibilidade também aumenta a segurança dos dados.
Portanto, é preciso buscar um equilíbrio, e a solução depende da situação específica.
Problemas com ha-promote-on-failure=when-synced
Ideia ha-promote-on-failure= when-synced é que evitamos a mudança para um espelho não sincronizado e, assim, evitamos a perda de dados. A fila permanece indisponível para leitura ou gravação. Em vez disso, tentamos recuperar o broker que falhou com dados intactos, para que ele possa retomar como mestre sem perda de dados.
Mas (e isso é um grande mas) se o broker perdeu seus dados, temos um grande problema: a fila foi perdida! Todos os dados se foram! Mesmo que você tenha espelhos que em grande parte acompanham a fila principal, esses espelhos também são descartados.
Para re-adicionar um nó com o mesmo nome, dizemos ao cluster para esquecer o nó perdido (com o comando rabbitmqctl forget_cluster_node) e iniciar um novo broker com o mesmo nome de host. Enquanto o cluster lembrar do nó perdido, ele lembrará da fila antiga e dos espelhos não sincronizados. Quando dizemos ao cluster para esquecer o nó perdido, essa fila também é esquecida. Agora precisamos declará-la novamente. Perdemos todos os dados, embora tivéssemos espelhos com um conjunto de dados parcial. Teria sido melhor mudar para um espelho não sincronizado!
Portanto, a sincronização manual (e a não realização de sincronização) em conjunto com ha-promote-on-failure=when-synced, na minha opinião, é bastante arriscada. Documentos afirmam que essa opção existe para segurança dos dados, mas é uma faca de dois gumes.
Reequilíbrio de mestres
Como prometido, voltamos ao problema de acumulação de todos os mestres em um ou vários nós. Isso pode ocorrer até mesmo em um processo de atualização ‘rolling’ do cluster. Em um cluster com três nós, todas as filas principais podem se acumular em um ou dois nós.
O reequilíbrio de mestres pode ser problemático por duas razões:
- Não há boas ferramentas para realizar a reequilibração
- Sincronização de filas
Para o rebalanceamento, há um componente de terceiros , que não é oficialmente suportado. Em relação aos plugins de terceiros, o guia do RabbitMQ : "O plugin fornece algumas ferramentas adicionais de configuração e relatórios, mas não é suportado e não foi verificado pela equipe do RabbitMQ. Use por sua própria conta e risco".
Há também um truque para mover a fila principal por meio de políticas de HA. O guia menciona para isso. Ele funciona da seguinte forma:
- Remove todos os espelhos usando uma política temporária com uma prioridade mais alta do que a política de HA existente.
- Altera a política de HA temporária para usar o modo 'nós', especificando o nó para o qual a fila principal deve ser movida.
- Sincroniza a fila para forçar a migração.
- Após a conclusão da migração, remove a política temporária. A política original de HA entra em vigor e a quantidade necessária de espelhos é criada.
A desvantagem é que essa abordagem pode não funcionar se você tiver filas grandes ou requisitos rigorosos de redundância.
Agora, vamos ver como os clusters RabbitMQ lidam com divisões de rede.
Divisão de Coesão
Os nós de um sistema distribuído são conectados por meio de links de rede, e os links podem e irão falhar. A frequência das falhas depende da infraestrutura local ou da confiabilidade da nuvem escolhida. Em qualquer caso, sistemas distribuídos devem ser capazes de lidar com isso. Mais uma vez, temos uma escolha entre disponibilidade e consistência, e a boa notícia é que o RabbitMQ oferece ambas as opções (apenas não ao mesmo tempo).
Com o RabbitMQ, temos duas opções principais:
- Permitir a divisão lógica (split-brain). Isso garante disponibilidade, mas pode causar perda de dados.
- Proibir a divisão lógica. Isso pode levar a uma perda temporária de disponibilidade, dependendo de como os clientes se conectam ao cluster. Também pode resultar em completa indisponibilidade no cluster de dois nós.
Mas o que é divisão lógica? É quando o cluster é dividido em dois devido à perda de conexões de rede. De cada lado, os espelhos se elevam a mestres, de forma que no final há vários mestres para cada fila.
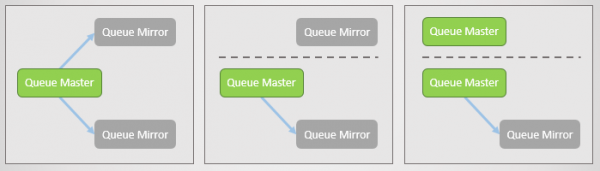
Fig. 17. Fila principal e dois espelhos, cada um em um nó separado. Em seguida, ocorre uma falha de rede, e um espelho se separa. O nó separado vê que os outros dois falharam e promove seus espelhos a mestre. Agora temos duas filas principais, ambas permitindo gravação e leitura.
Se os publishers enviam dados para ambos os mestres, teremos duas cópias divergentes da fila.
Modos diferentes do RabbitMQ garantem disponibilidade ou consistência.
Modo Ignore (padrão)
Esse modo garante disponibilidade. Após a perda de conectividade, ocorre uma divisão lógica. Após a restauração da conectividade, o administrador deve decidir a qual divisão dar preferência. O lado perdedor será reiniciado, e todos os dados acumulados desse lado serão perdidos.
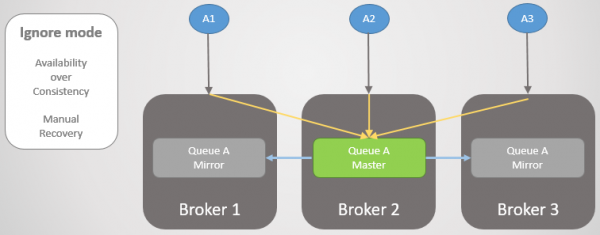
Fig. 18. Três publishers estão conectados a três brokers. Internamente, o cluster direciona todas as solicitações para a fila principal no Broker 2.
Agora perdemos o Broker 3. Ele vê que os outros brokers falharam e promove seu espelho a mestre. Isso resulta em uma divisão lógica.
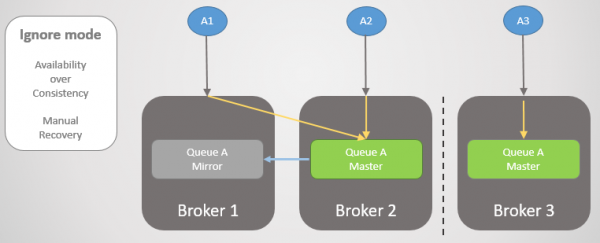
Fig. 19. Divisão lógica (split-brain). As gravações vão para duas filas principais, e duas cópias se separam.
A conectividade é restaurada, mas a divisão lógica permanece. O administrador deve escolher manualmente o lado perdedor. No exemplo abaixo, o administrador reinicia o Broker 3. Todas as mensagens que ele não conseguiu transmitir são perdidas.
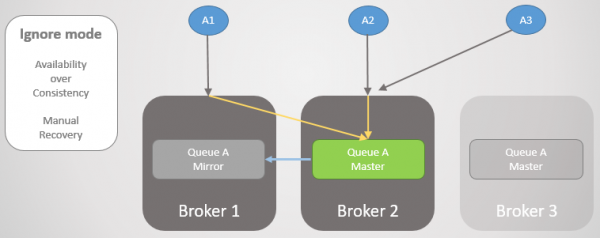
Fig. 20. O administrador desativa o Broker 3.
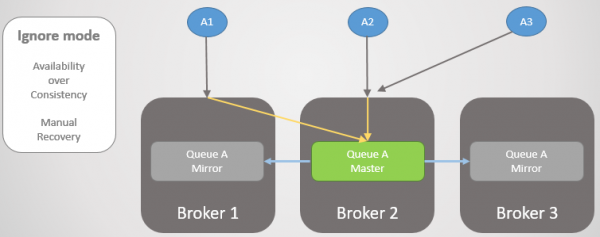
Fig. 21. O administrador inicia o Broker 3, e ele se junta ao cluster, perdendo todas as mensagens que estavam lá.
Durante a perda de conectividade e após sua restauração, o cluster e essa fila estavam disponíveis para leitura e gravação.
Modo Autoheal
Funciona de maneira semelhante ao modo Ignore, exceto que o próprio cluster escolhe automaticamente o lado perdedor após a separação e a restauração da conectividade. O lado perdedor retorna ao cluster vazio, e a fila perde todas as mensagens que foram enviadas apenas para aquele lado.
Modo Pause Minority
Se não quisermos permitir a separação lógica, nossa única opção é desistir de ler e gravar no lado menor após a divisão do cluster. Quando o broker detecta que está no lado menor, ele suspende suas operações, ou seja, fecha todas as conexões existentes e rejeita novas. Ele verifica a recuperação da conectividade uma vez por segundo. Assim que a conectividade for restaurada, ele retoma suas operações e se reintegra ao cluster.
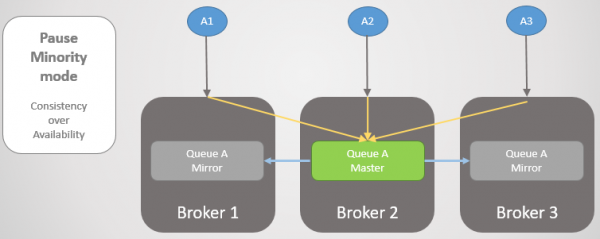
Fig. 22. Três publishers estão conectados a três brokers. Internamente, o cluster direciona todas as solicitações para a fila principal no Broker 2.
Em seguida, os Brokers 1 e 2 se separam do Broker 3. Em vez de promover seu espelho a mestre, o Broker 3 suspende suas operações e fica indisponível.
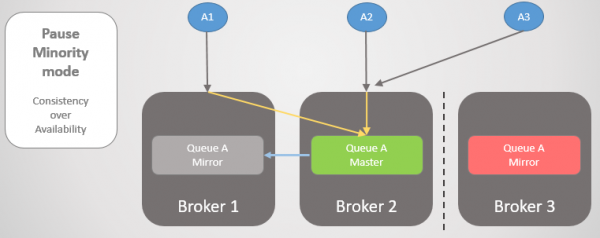
Fig. 23. O Broker 3 suspende suas operações, desconecta todos os clientes e rejeita solicitações de conexão.
Assim que a conectividade for restaurada, ele volta ao cluster.
Vamos considerar outro exemplo onde a fila principal está no Broker 3.
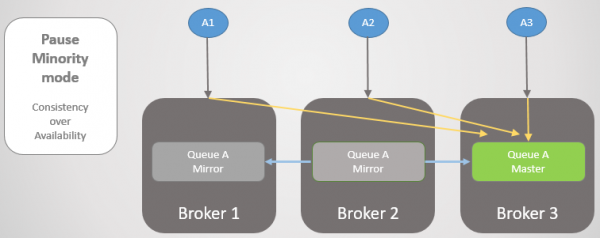
Fig. 24. A fila principal no Broker 3.
Em seguida, ocorre a mesma perda de conectividade. O Broker 3 entra em pausa, pois está no lado menor. Do outro lado, os nós veem que o Broker 3 caiu, então um espelho mais antigo do Broker 1 e 2 é promovido a mestre.
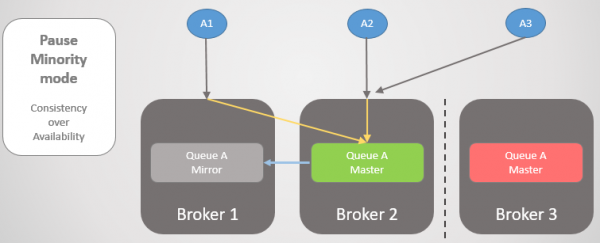
Fig. 25. Transição para o Broker 2 na ausência do Broker 3.
Quando a conectividade for restaurada, o Broker 3 se juntará ao cluster.

Fig. 26. O cluster voltou a operar normalmente.
Aqui é importante entender que obtivemos consistência, mas também podemos obter disponibilidade. se vamos traduzir os clientes com sucesso para a maior parte da seção. Para a maioria das situações, eu pessoalmente escolheria o modo Pause Minority, mas isso realmente depende do caso específico.
Para garantir a disponibilidade, é importante assegurar que os clientes se conectem com sucesso ao nó. Vamos considerar nossas opções.
Garantindo a conectividade dos clientes
Temos várias opções para redirecionar clientes para a parte principal do cluster ou para nós operacionais após a perda de conectividade (depois que um nó falha). Primeiro, vamos lembrar que uma fila específica é alocada a um determinado nó, mas o roteamento e as políticas são replicados em todos os nós. Os clientes podem se conectar a qualquer nó, e o roteamento interno os direcionará para onde precisam ir. No entanto, quando um nó é interrompido, ele rejeita conexões, portanto, os clientes devem se conectar a outro nó. Se um nó falha, ele não pode fazer nada.
Nossas opções:
- O acesso ao cluster é feito por meio de um balanceador de carga, que simplesmente percorre os nós em ciclos, enquanto os clientes tentam se reconectar até que a conexão seja bem-sucedida. Se um nó não estiver funcionando ou estiver parado, as tentativas de conexão para esse nó falharão, mas as tentativas subsequentes serão direcionadas a outros servidores (em modo cíclico). Isso é adequado para uma perda temporária de conectividade ou um servidor que falhou e será rapidamente reiniciado.
- Acesso ao cluster através de um balanceador de carga e remoção de nós parados/falhados da lista assim que forem detectados. Se isso for feito rapidamente, e se os clientes puderem tentar reconectar, teremos disponibilidade contínua.
- Fornecer a cada cliente uma lista de todos os nós, e o cliente, ao se conectar, escolhe aleatoriamente um deles. Se ao tentar se conectar ele receber um erro, ele passa para o próximo nó da lista até conseguir se conectar.
- Remover o tráfego do nó falhado/parado usando DNS. Isso é feito com um pequeno TTL.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
A clusterização do RabbitMQ tem suas vantagens e desvantagens. As desvantagens mais sérias incluem:
- ao se unir ao cluster, os nós descartam seus dados;
- a sincronização bloqueante resulta na indisponibilidade da fila.
Todas as decisões difíceis decorrem dessas duas características da arquitetura. Se o RabbitMQ pudesse salvar dados ao reconectar o cluster, a sincronização ocorreria mais rapidamente. Se ele tivesse capacidade de sincronização sem bloqueio, suportaria filas maiores com mais eficiência. Resolver esses dois problemas melhoraria significativamente as características do RabbitMQ como uma tecnologia de troca de mensagens resiliente e de alta disponibilidade. Eu não recomendaria o RabbitMQ com clusterização nas seguintes situações:
- Rede não confiável.
- Armazenamento não confiável.
- Filas muito grandes.
Quanto às configurações para alta disponibilidade, considere as seguintes:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(ouautoheal)- mensagens persistentes
- garanta que os clientes se conectem ao nó ativo quando um nó falha
Para consistência (segurança de dados), considere as seguintes configurações:
- Publisher Confirms e Acknowledgements Manuais do lado do consumidor
ha-promote-on-failure=when-synced, se os publicadores puderem tentar novamente mais tarde e se você tiver um armazenamento muito confiável! Caso contrário, defina=always.ha-sync-mode=automatic(mas para filas grandes inativas, pode ser necessário o modo manual; além disso, considere se a indisponibilidade levará à perda de mensagens)- modo Pause Minority
- mensagens persistentes
Ainda não abordamos todas as questões de resiliência e alta disponibilidade; por exemplo, como realizar procedimentos administrativos de forma segura (como atualizações contínuas). Também precisamos falar sobre federação e o plugin Shovel.
Se eu perdi mais alguma coisa, por favor, avise.
Veja também meu , onde realizo uma destruição no cluster RabbitMQ com Docker e Blockade para testar alguns cenários de perda de mensagens descritos neste artigo.
Artigos anteriores da série:
№1 —
№2 —
№3 —
Fonte: habr.com
