

Nota do tradutor.: O autor deste material é Cindy Sridharan, engenheira da imgix, especializada em desenvolvimento de API e, em particular, teste de microsserviços. Neste material, ela compartilha sua visão abrangente sobre os problemas atuais na área de rastreamento distribuído, onde, segundo ela, há uma falta de ferramentas verdadeiramente eficazes para resolver questões urgentes.
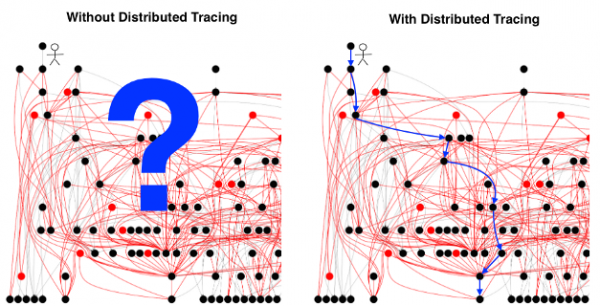
[A ilustração foi retirada de sobre rastreamento distribuído.]
Considera-se que é difícil de implementar, e o retorno sobre isso . A “problemática” do rastreamento é explicada por uma série de razões, frequentemente citando o esforço envolvido na configuração de cada componente do sistema para enviar os cabeçalhos correspondentes com cada solicitação. Embora esse problema realmente exista, não se pode chamar isso de insuperável. Aliás, isso não explica por que os desenvolvedores não são muito adeptos do rastreamento (mesmo aquele que já está em funcionamento).
A principal dificuldade com o rastreamento distribuído não é a coleta de dados, nem a padronização dos formatos de distribuição e apresentação dos resultados, e nem a determinação de quando, onde e como realizar a amostragem. Eu definitivamente não estou tentando retratar como triviais esses “problemas de usabilidade” — de fato, existem desafios técnicos bastante significativos e (se considerarmos verdadeiramente os padrões e protocolos Open Source) políticos, que precisam ser superados para que esses problemas possam ser considerados resolvidos. experiência do usuário final
. O rastreamento ainda pode não trazer benefícios práticos nos cenários de depuração mais comuns — mesmo após ser implementado. Esse rastreamento incomumO rastreamento distribuído envolve vários componentes desconectados:
equipar aplicações e middleware com ferramentas de controle;
transmitir contexto distribuído;
- coletar rastreamentos;
- armazenar rastreamentos;
- extrair e visualizar.
- armazenamento de rastreamentos;
- sua extração e visualização.
Muitas discussões sobre rastreamento distribuído se resumem a considerá-lo como uma operação unária, cujo único objetivo é ajudar no diagnóstico completo do sistema. Isso está muito ligado à forma como as percepções sobre o rastreamento distribuído se formaram historicamente. No , foi mencionado quando os códigos fontes do Zipkin foram abertos que ele [Zipkin] torna o Twitter mais rápido.As primeiras ofertas comerciais para rastreamento também foram promovidas como .
Nota do tradutor.Para que o texto a seguir seja mais bem compreendido, vamos definir dois termos básicos de acordo com :
- Span — um elemento básico do rastreamento distribuído. Representa a descrição de um determinado fluxo de trabalho (por exemplo, uma consulta ao banco de dados) com um nome, horário de início e término, tags, logs e contexto.
- Os spans geralmente contêm referências a outros spans, o que permite agregar múltiplos spans em Trace — uma visualização da vida de uma solicitação enquanto ela se move através do sistema distribuído.
Os traces contêm dados incrivelmente valiosos que podem ajudar em tarefas como: teste em produção, realização de testes de recuperação de desastres, teste com injeção de falhas, etc. Na verdade, algumas empresas já estão utilizando rastreamento para essas finalidades. Comecemos com o que possui outras aplicações além do simples transporte de spans para o sistema de armazenamento:
- Por exemplo, o Uber utiliza resultados de rastreamento para separar o tráfego de testes do tráfego de produção.
- Facebook os dados dos traces para análise do caminho crítico e para alternar o tráfego durante testes regulares de recuperação de desastres.
- A rede social também utiliza notebooks Jupyter, permitindo que desenvolvedores façam consultas arbitrárias sobre os resultados do rastreamento.
- Os defensores de injetam falhas em traces distribuídos para testes. Nenhuma das opções listadas acima se refere completamente a um cenário
de depuração, onde o engenheiro tenta resolver um problema observando o trace. Quando se tratade um cenário de depuração, a interface primária continua sendo o diagrama
traceview (embora alguns também o chamem de "diagrama de Gantt" ou "diagrama em cascata") . Por eu me refiro a ou «diagrama em cascata»). Sob . Por eu todas as spans e os metadados associados que, juntos, formam a trace. Cada sistema de rastreamento de código aberto, assim como cada solução comercial de rastreamento, oferece uma base em . Por uma interface do usuário para visualização, detalhamento e filtragem de traces.
O problema com todos os sistemas de rastreamento que tive a oportunidade de conhecer até agora é que a visualização final (traceview) reflete quase totalmente as características do processo de geração da trace. Mesmo quando são oferecidas visualizações alternativas: mapas de intensidade (heatmap), topologias de serviços, histogramas de latência, no final, todas acabam se resumindo a . Por.
No passado, eu que a maioria das "inovações" na área de rastreamento em relação ao UI/UX parece estar limitada a metadados adicionais na trace, incorporando informações de alta cardinalidade (high-cardinality) ou oferecendo a possibilidade de detalhar spans específicos ou realizar consultas entre e dentro da trace.. Nesse contexto, . Por permanecerá como o principal meio de visualização. Enquanto essa situação persistir, o rastreamento distribuído ocupará (no melhor dos casos) o 4º lugar como ferramenta de depuração, atrás de métricas, logs e stack traces, e, no pior, se tornará uma perda vazia de dinheiro e tempo.
O problema com o traceview
O propósito . Por é fornecer uma visão completa do movimento de uma única solicitação por todos os componentes do sistema distribuído aos quais ela está relacionada. Alguns sistemas de rastreamento mais avançados permitem detalhar spans individuais e visualizar a quebra ao longo do tempo dentro de um processo (quando os spans têm limites funcionais).
A premissa básica da arquitetura de microsserviços é a ideia de que a estrutura organizacional cresce junto com as necessidades da empresa. Os defensores dos microsserviços afirmam que a distribuição de várias tarefas de negócios em serviços distintos permite que pequenas equipes autônomas de desenvolvedores controlem todo o ciclo de vida desses serviços, proporcionando-lhes a capacidade de criar, testar e implantar esses serviços de forma independente. No entanto, uma desvantagem dessa distribuição é a perda de informações sobre como cada serviço interage com os outros. Nesse contexto, a rastreabilidade distribuída se torna uma ferramenta indispensável para Quando se trata interações complexas entre serviços.
Se você realmente , então nenhuma pessoa é capaz de manter na mente a sua imagem completa. Na verdade, desenvolver uma ferramenta partindo da suposição de que isso é possível, é algo como um antipadrão (uma abordagem ineficaz e improdutiva). Idealmente, para depuração, é necessário uma ferramenta que ajude a restringir a área de busca, para que os engenheiros possam se concentrar em um subconjunto de métricas (serviços/usuários/hospedagens, etc.) relevantes para o cenário do problema em questão. Ao investigar a causa de uma falha, os engenheiros não precisam entender o que estava acontecendo em todos os serviços ao mesmo tempo, uma vez que tal exigência contradiz a própria ideia da arquitetura de microsserviços.
No entanto, traceview representa exatamente isso. Sim, alguns sistemas de rastreamento oferecem traceviews condensados, quando o número de spans em um trace é tão grande que não consegue ser exibido em uma única visualização. No entanto, devido à grande quantidade de informações contidas mesmo em uma visualização reduzida, os engenheiros ainda assim são forçados a "filtrar" isso, restringindo manualmente a amostra a um conjunto de serviços de origem dos problemas. Infelizmente, nesse campo as máquinas são significativamente mais rápidas que os humanos, menos propensas a erros, e seus resultados são mais repetíveis.
Outra razão pela qual considero que o método traceview é inadequado está relacionada ao fato de que ele não é bem adequado para depuração baseada em hipóteses. Na sua essência, a depuração é iterativa. um processo que começa com uma hipótese, seguido pela verificação de várias observações e fatos obtidos do sistema em diferentes vetores, conclusões/resumos e uma avaliação adicional da veracidade da hipótese.
Possibilidade rápido e barato testar hipóteses e aprimorar o modelo mental adequadamente é fundamental para a depuração. Qualquer ferramenta de depuração deve ser interativa e restringir o espaço de busca ou, no caso de um falso positivo, permitir que o usuário volte e se concentre em outra área do sistema. A ferramenta ideal faria isso proativamente, chamando imediatamente a atenção do usuário para áreas potencialmente problemáticas.
Infelizmente, . Por não pode ser chamado de uma ferramenta com interface interativa. A melhor expectativa ao usá-la é descobrir uma fonte de latências aumentadas e revisar várias tags e logs relacionados a isso. Isso não ajuda o engenheiro a identificar padrões no tráfego, como a especificidade da distribuição de latências ou a descoberta de correlações entre diferentes medições. pode ajudar a contornar alguns desses problemas. De fato, de análise bem-sucedida usando aprendizado de máquina para identificar spans anômalos e identificar um subconjunto de tags que podem estar relacionadas a comportamentos anômalos. No entanto, até agora não vi visualizações convincentes das descobertas feitas com aprendizado de máquina ou análise de dados aplicadas a spans que fossem significativamente diferentes de traceview ou DAG (grafo acíclico direcionado).
Spans são muito de baixo nível
O problema fundamental com traceview é que spans são primitivos muito de baixo nível tanto para análise de latências quanto para análise de causas raiz. É o mesmo que analisar instruções individuais da CPU na tentativa de resolver uma exceção, sabendo que existem ferramentas de nível muito mais alto, como backtrace, que são muito mais convenientes de usar.
Além disso, eu me atreverei a afirmar o seguinte: idealmente, não precisamos de uma imagem completa que ocorre durante o ciclo de vida da solicitação, representado pelas ferramentas modernas de rastreamento. Em vez disso, é necessária uma forma de abstração de nível mais alto que contenha informações sobre o que deu errado (semelhante ao backtrace), juntamente com algum contexto. Em vez de observar todo o rastreamento, eu prefiro ver uma parte, onde acontece algo interessante ou incomum. Atualmente, a busca é realizada manualmente: o engenheiro recebe o rastreamento e analisa os spans para encontrar algo intrigante. O método de observar spans em diferentes rastreamentos na esperança de detectar atividades suspeitas não é escalável (especialmente quando precisam fazer sentido de todos os metadados codificados em vários spans, como ID do span, nome do método RPC, duração do span, logs, tags etc.).
Alternativas ao traceview
Os resultados de rastreamento são mais úteis quando podem ser visualizados de tal forma que proporcionem uma representação não trivial do que acontece nas partes interconectadas do sistema. Até que isso aconteça, o processo de depuração continua sendo inerte e depende da capacidade do usuário em perceber as correlações corretas, verificar as partes adequadas do sistema ou reunir pedaços do quebra-cabeça — ao contrário de ferramenta, ajudando o usuário a formular essas hipóteses.
Eu não sou um designer visual e nem especialista em UX, mas na próxima seção quero compartilhar algumas ideias sobre como essas visualizações podem ser.
Foco em serviços específicos
Em um cenário onde a indústria se consolida em torno das ideias de , parece razoável que equipes individuais devem, em primeiro lugar, monitorar a conformidade de seus serviços com esses objetivos. Disto, segue que uma visualização orientada a serviços é mais adequada para tais equipes.
Rastros, especialmente sem amostragem, são um tesouro de informações sobre cada componente de um sistema distribuído. Essas informações podem ser alimentadas a um processador sofisticado que forneça aos usuários descobertas orientadas a serviços. Elas podem ser identificadas antecipadamente — mesmo antes que o usuário olhe para os rastros:
- Diagramas de distribuição de latências apenas para solicitações muito marcantes (solicitações discrepantes);
- Diagramas de distribuição de latências para situações em que as metas SLO do serviço não são alcançadas;
- As tags mais "comuns", "interessantes" e "estranhas" nas solicitações, que mais frequentemente se repetem;
- Divisão de latências para situações em que dependências do serviço não alcançam as metas SLO estabelecidas;
- Divisão de latências por vários serviços downstream.
Para algumas dessas questões, as métricas integradas simplesmente não conseguem responder, forçando os usuários a examinar minuciosamente os spans. No final, temos um mecanismo extremamente hostil ao usuário.
Em função disso, surge a pergunta: como ficam as interações complexas entre diversos serviços controlados por diferentes equipes? Não seria . Por o instrumento mais adequado para esclarecer tal situação?
Desenvolvedores móveis, proprietários de serviços sem estado, proprietários de serviços gerenciados com estado (como bancos de dados) e proprietários de plataformas podem estar interessados em uma representação do sistema distribuído; . Por — é uma solução universal demais para essas necessidades essencialmente diferentes. Mesmo em uma arquitetura de microsserviços muito complexa, os proprietários do serviço não precisam ter um conhecimento profundo de mais do que dois ou três serviços upstream e downstream. Na essência, na maioria dos cenários, os usuários só precisam responder perguntas a respeito de um conjunto limitado de serviços.
Isso é semelhante a observar um pequeno subconjunto de serviços através de uma lente de aumento para um estudo meticuloso. Isso permitirá que o usuário faça perguntas mais relevantes sobre a interação complexa entre esses serviços e suas dependências imediatas. É análogo ao backtrace no mundo dos serviços, onde o engenheiro sabe, o usuário (ou invasor) está tentando fazer, mas também não apenas isso, mas também tem uma ideia do que está acontecendo nos serviços ao redor, para entender, por que.
A abordagem que estou promovendo é completamente oposta à abordagem de "cima para baixo", baseada em traceview, onde a análise começa com todo o trace e depois desce gradualmente para os spans individuais. Em contraste, a abordagem "de baixo para cima" começa com a análise de uma pequena parte, próxima à potencial causa do incidente, e depois o espaço de busca é expandido conforme necessário (com a possível participação de outras equipes para analisar uma gama mais ampla de serviços). A segunda abordagem é melhor adaptada para validação rápida de hipóteses iniciais. Após obter resultados concretos, pode-se passar para uma análise mais direcionada e detalhada.
Construção de topologia
Visões ligadas a um serviço específico podem ser incrivelmente úteis se o usuário souber qual serviço ou grupo de serviços deve estar causando aumentos de latência ou é a fonte de erros. No entanto, em um sistema complexo, identificar o serviço problemático pode ser uma tarefa não trivial durante uma falha, especialmente se não houver recebido mensagens de erro dos serviços.
A construção de topologias de serviços pode ajudar muito a descobrir qual serviço está apresentando um aumento na taxa de erros ou um aumento de latência, levando a uma deterioração visível no desempenho do serviço. Ao falar sobre a construção de topologias, não me refiro a um mapa de serviços, que representa cada serviço disponível no sistema e é conhecido por suas Essa representação não é melhor do que o traceview baseado em um grafo acíclico direcionado. Em vez disso, eu gostaria de ver uma topologia de serviços gerada dinamicamente, baseada em atributos específicos, como taxa de erros, tempo de resposta ou em qualquer parâmetro definido pelo usuário que ajude a esclarecer a situação com serviços suspeitos específicos.
Vamos considerar um exemplo. Imagine um hipotético site de notícias. O serviço da página inicial (front page) troca dados com Redis, com o serviço de recomendações, com o serviço de publicidade e com o serviço de vídeo. O serviço de vídeo pega os vídeos do S3, enquanto os metadados vêm do DynamoDB. O serviço de recomendações obtém metadados do DynamoDB, carrega dados do Redis e MySQL, e envia mensagens para o Kafka. O serviço de publicidade recebe dados do MySQL e envia mensagens para o Kafka.
Abaixo está uma representação esquemática dessa topologia (muitas ferramentas comerciais para rastreamento constroem topologias). Esta pode ser útil para entender as dependências dos serviços. No entanto, durante Quando se trata, quando um determinado serviço (digamos, o serviço de vídeo) apresenta um tempo de resposta aumentado, essa topologia não é muito útil.
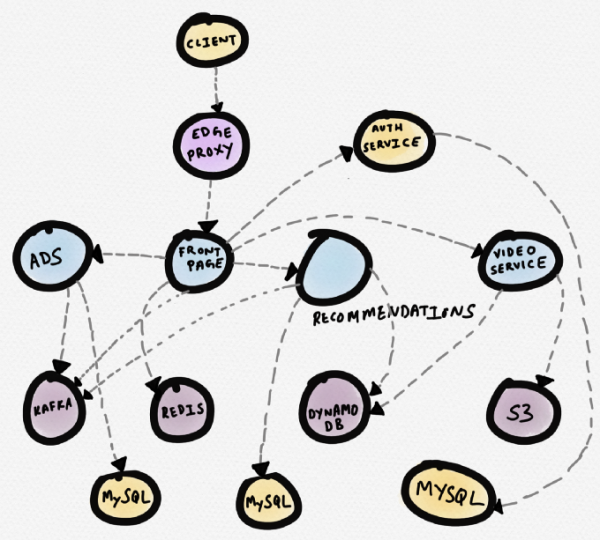
Esquema de serviços de um site hipotético de notícias
Um diagrama como o abaixo seria mais apropriado. Nele, o serviço problemático (video) está posicionado bem no centro. O usuário o nota imediatamente. A partir dessa visualização, fica claro que o serviço de vídeo está operando anormalmente devido ao aumento do tempo de resposta do S3, o que afeta a velocidade de carregamento de parte da página inicial.
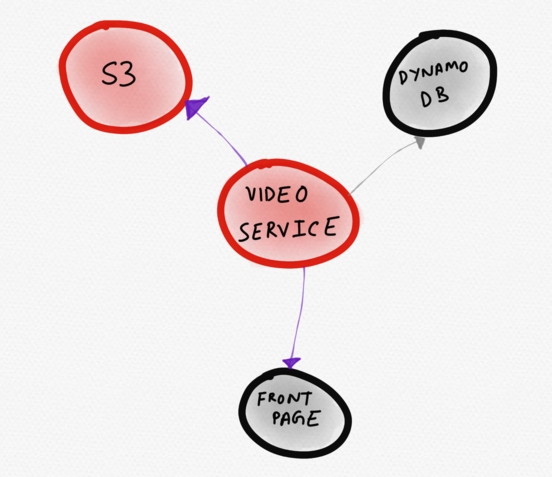
Topologia dinâmica, exibindo apenas os serviços "interessantes"
Esquemas topológicos gerados dinamicamente podem ser mais eficazes do que mapas de serviços estáticos, especialmente em infraestruturas elásticas e autoescaláveis. A capacidade de comparar e contrastar as topologias dos serviços permite que o usuário faça perguntas mais relevantes. Perguntas mais precisas sobre o sistema são mais propensas a resultar em uma melhor compreensão de como o sistema funciona.
Exibição comparativa
Outra visualização útil seria a exibição comparativa. Atualmente, as traces não se prestam muito bem à comparação lado a lado, por isso geralmente são comparadas spans. A ideia principal deste artigo é que os spans são muito de baixo nível para extrair as informações mais valiosas dos resultados de rastreamento.
Comparar duas traces não requer visualizações fundamentalmente novas. Na verdade, é suficiente algo como um histograma, representando as mesmas informações que o traceview. Surpreendentemente, mesmo este método simples pode trazer muito mais benefícios do que apenas estudar duas traces separadamente. Seria ainda mais poderoso ter a capacidade visualizar comparação de traços em conjunto. Seria extremamente útil ver como a configuração de banco de dados recentemente implementada, com a inclusão do GC (coleta de lixo), afeta o tempo de resposta do serviço downstream ao longo de várias horas. Se o que estou descrevendo aqui parece um A/B test do impacto de mudanças de infraestrutura em múltiplos serviços com os resultados da rastreabilidade, você não está muito longe da verdade.
Conclusão
Não questiono a utilidade da rastreabilidade em si. Acredito sinceramente que não há outro método que colete dados tão ricos, casuais e contextuais quanto os contidos em um traço. No entanto, também considero que todas as soluções de rastreabilidade utilizam esses dados de maneira extremamente ineficaz. Enquanto as ferramentas de rastreabilidade estiverem limitadas à apresentação de traços, elas estarão restritas em sua capacidade de maximizar a extração de informações valiosas que podem ser obtidas dos dados contidos nos traços. Além disso, existe o risco de um desenvolvimento adicional de uma interface visual completamente hostil e não intuitiva, que limitará severamente a capacidade do usuário de depurar o aplicativo.
Depurar sistemas complexos, mesmo com o uso das ferramentas mais modernas, é incrivelmente difícil. As ferramentas devem auxiliar o desenvolvedor a formular e testar hipóteses, fornecendo ativamente informações relevantes, identificando outliers e observando características na distribuição de latências. Para que a rastreabilidade se torne a ferramenta preferida dos desenvolvedores para resolver falhas em produção ou problemas que envolvem vários serviços, são necessárias interfaces e visualizações originais que se alinhem mais com o modelo mental dos desenvolvedores que criam e operam esses serviços.
Serão necessários esforços mentais significativos para projetar um sistema que apresente diversos sinais disponíveis nos resultados da rastreabilidade de uma maneira otimizada para facilitar a análise e a inferência. É preciso pensar em como abstrair a topologia do sistema durante a depuração de forma a ajudar o usuário a superar áreas cegas, sem ter que examinar traços ou spans individualmente.
Precisamos de boas oportunidades de abstração e divisão em camadas (especialmente na interface do usuário). Aqueles que se encaixam bem no processo de depuração baseado em hipóteses, onde podemos iterativamente fazer perguntas e testar hipóteses. Eles não resolverão automaticamente todos os problemas de observabilidade, mas ajudarão os usuários a aprimorar a intuição e formular perguntas mais ponderadas. Eu apelo a uma abordagem mais reflexiva e inovadora na área de visualização. Há uma perspectiva real de expandir os horizontes.
P.S. do tradutor
Confira também em nosso blog:
- «»;
- «»;
- «».
Fonte: habr.com
