

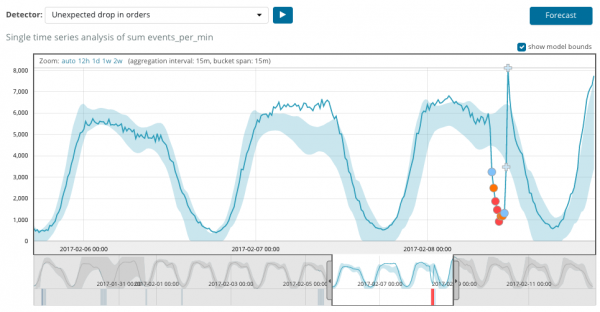
Lembre-se de que a base do Elastic Stack é um banco de dados não relacional, o Elasticsearch, a interface web Kibana e coletores-processadores de dados (o mais conhecido é o Logstash, diversos Beats, APM e outros). Uma das adições agradáveis de todo esse conjunto de produtos é a análise de dados com algoritmos de machine learning. Neste artigo, vamos entender o que esses algoritmos representam. Por favor, continue lendo.
O machine learning é uma função paga do Elastic Stack, que é condicionalmente gratuito e faz parte do pacote X-Pack. Para começar a usá-lo, basta ativar o período de teste de 30 dias após a instalação. Após o término do período de teste, é possível solicitar suporte para prorrogação ou adquirir uma assinatura. O custo da assinatura é calculado com base no número de nós utilizados, não no volume de dados. É claro que o volume de dados influencia a quantidade de nós necessários, mas essa abordagem de licenciamento é mais amigável em relação ao orçamento da empresa. Se não houver necessidade de alta performance, é possível economizar.
O ML no Elastic Stack é escrito em C++ e opera fora da JVM, onde o Elasticsearch roda. Ou seja, o processo (que, aliás, é chamado de autodetect) consome tudo o que a JVM não processa. Em um ambiente de demonstração isso não é tão crítico, mas em um ambiente produtivo é importante dedicar nós separados para tarefas de ML.
Os algoritmos de machine learning se dividem em duas categorias — e . No Elastic Stack, o algoritmo se encaixa na categoria "sem supervisão". Por você pode conferir a fundamentação matemática dos algoritmos de machine learning.
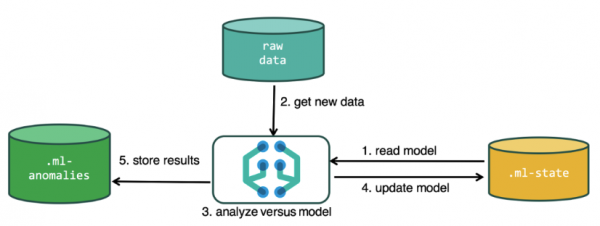
Para realizar a análise, o algoritmo de machine learning utiliza os dados armazenados nos índices do Elasticsearch. As tarefas de análise podem ser criadas tanto na interface do Kibana quanto via API. Se você fizer isso pelo Kibana, não precisa saber algumas coisas. Por exemplo, índices adicionais que o algoritmo usa durante a operação.
Índices adicionais utilizados durante a análise.ml-state — informações sobre modelos estatísticos (configurações da análise);
.ml-anomalies-* — resultados das operações dos algoritmos de ML;
.ml-notifications — configurações de notificações sobre os resultados da análise.
A estrutura de dados no banco Elasticsearch consiste em índices e nos documentos armazenados neles. Comparando com um banco de dados relacional, um índice pode ser comparado a um esquema de banco de dados, enquanto um documento é como um registro em uma tabela. Essa comparação é condicional e serve para simplificar a compreensão do material subsequente para aqueles que apenas ouviram falar sobre Elasticsearch.
Através da API, está disponível a mesma funcionalidade que pelo interface web, por isso, para melhor visualização e entendimento dos conceitos, mostraremos como configurar através do Kibana. No menu à esquerda, há uma seção chamada Machine Learning, onde você pode criar uma nova tarefa (Job). Na interface do Kibana, isso aparece como na imagem abaixo. Agora vamos analisar cada tipo de tarefa e mostrar os tipos de análise que podem ser construídos aqui.
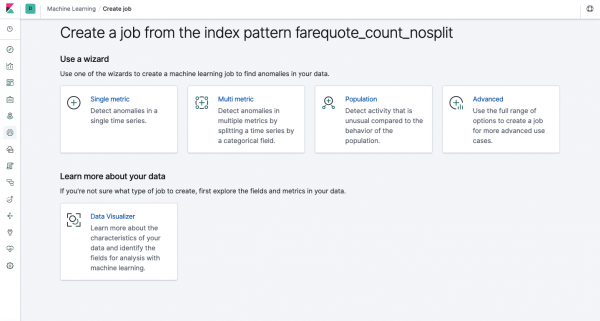
Single Metric — análise de uma única métrica, Multi Metric — análise de duas ou mais métricas. Em ambos os casos, cada métrica é analisada em um ambiente isolado, ou seja, o algoritmo não leva em conta o comportamento das métricas sendo analisadas em paralelo, como poderia parecer no caso da Multi Metric. Para realizar cálculos considerando a correlação entre diferentes métricas, pode-se aplicar a análise Population. E o Advanced — trata-se do ajuste fino dos algoritmos com opções adicionais para tarefas específicas.
Single Metric
A análise de mudanças em uma única métrica é a coisa mais simples que se pode fazer aqui. Após clicar em Create Job, o algoritmo buscará anomalias.
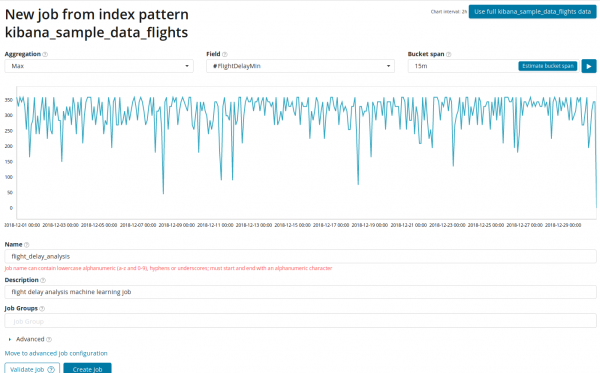
No campo Aggregation é possível escolher a abordagem para a busca de anomalias. Por exemplo, com Min valores abaixo do típico serão considerados anômalos. Existem também Max, High Mean, Low, Mean, Distinct e outros. A descrição de todas as funções pode ser consultada .
No campo Field indica o campo numérico no documento que será analisado.
No campo é a granularidade dos intervalos na linha do tempo usada para a análise. Você pode confiar na automação ou escolher manualmente. Na imagem abaixo, um exemplo de granularidade muito baixa — você pode perder uma anomalia. Com esta configuração, é possível alterar a sensibilidade do algoritmo para anomalias.
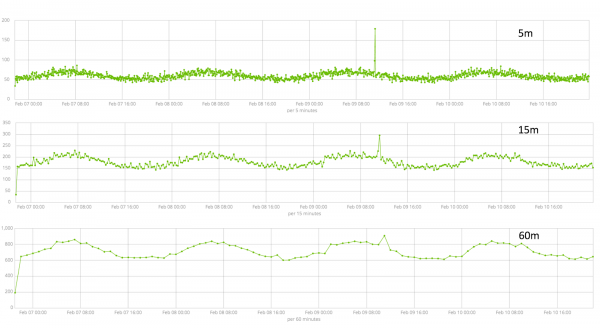
A duração dos dados coletados é um aspecto chave que influencia a eficácia da análise. Na análise, o algoritmo identifica intervalos repetidos, calcula o intervalo de confiança (linhas de base) e detecta anomalias — desvios atípicos do comportamento normal da métrica. Apenas como um exemplo:
Linhas básicas para um pequeno intervalo de dados:
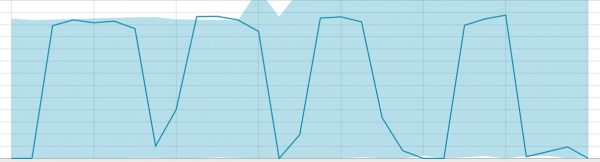
Quando o algoritmo tem algo para aprender — as linhas básicas aparecem assim:
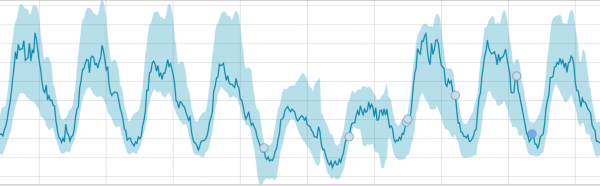
Após a execução da tarefa, o algoritmo identifica desvios anômalos da norma e os classifica por probabilidade de anomalia (a cor correspondente à etiqueta está entre parênteses):
Warning (azul): menos de 25
Minor (amarelo): 25-50
Major (laranja): 50-75
Critical (vermelho): 75-100
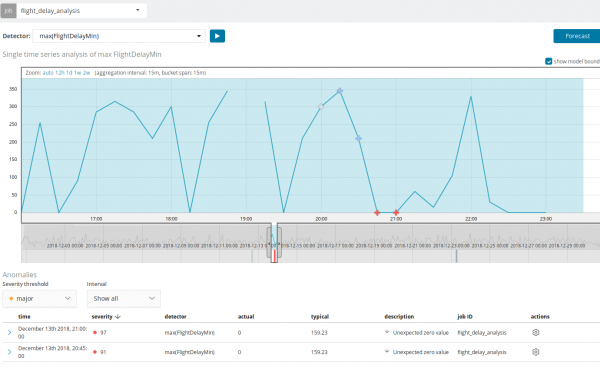
No gráfico abaixo, um exemplo com as anomalias encontradas.
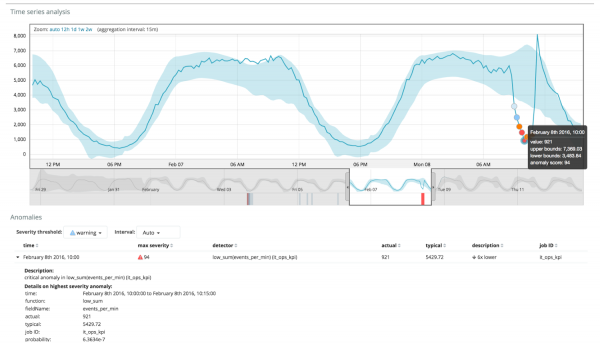
Aqui vemos o número 94, que indica a probabilidade de anomalia. É claro que, como o valor está próximo de 100, temos uma anomalia. Na coluna abaixo do gráfico, há uma probabilidade desprezível de 0.000063634% de aparecer esse valor métrico.
Além de buscar anomalias no Kibana, é possível iniciar previsões. Isso é feito de uma maneira simples e a partir da mesma visualização com anomalias — botão Forecast no canto superior direito.
A previsão é feita no máximo para 8 semanas à frente. Mesmo que se queira muito — não é permitido por design.
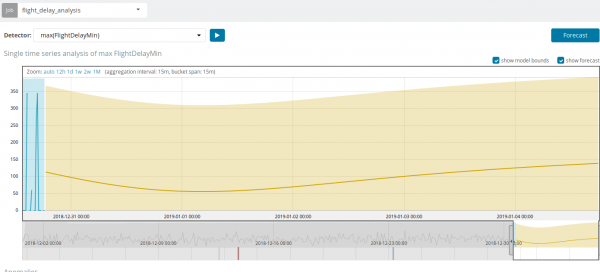
Em algumas situações, a previsão será muito útil, por exemplo, ao monitorar a carga do usuário na infraestrutura.
Multi Metric
Passamos à próxima capacidade do ML no Elastic Stack — a análise de várias métricas em um único pacote. Porém, isso não significa que a dependência de uma métrica em relação a outra será analisada. É o mesmo que a Single Metric, apenas com múltiplas métricas na mesma tela para facilitar a comparação do impacto de uma sobre a outra. A análise da dependência de uma métrica em relação a outra será abordada na parte Population.
Após clicar no quadrado com Multi Metric, uma janela com configurações aparecerá. Vamos nos aprofundar nelas.
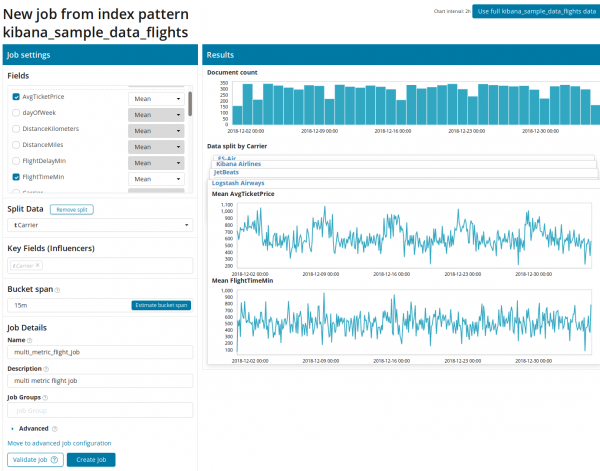
Para começar, é preciso escolher os campos para análise e a agregação de dados sobre eles. As opções de agregação aqui são as mesmas que para a Single Metric (Max, High Mean, Low, Mean, Distinct e outros). Em seguida, se desejar, os dados são divididos por um dos campos (campo Split Data). No exemplo, fizemos isso com o campo OriginAirportID. Note que agora o gráfico de métricas à direita é apresentado como múltiplos gráficos.
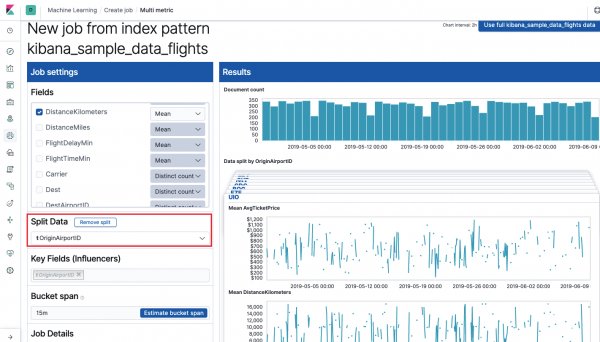
Campo Key Fields (Influencers) influencia diretamente as anomalias encontradas. Por padrão, haverá sempre pelo menos um valor aqui, e você pode adicionar valores adicionais. O algoritmo considerará a influência desses campos durante a análise e mostrará os valores mais "influentes".
Após a execução, a interface do Kibana exibirá aproximadamente esta imagem.
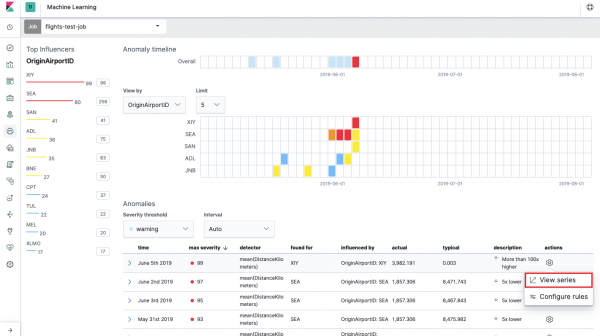
Esta é uma chamada de mapa de calor de anomalias para cada valor do campo. OriginAirportID, que especificamos em Split Data. Assim como no caso do Single Metric, a cor indica o nível de desvio anômalo. Uma análise semelhante pode ser convenientemente feita, por exemplo, nas estações de trabalho para monitorar aquelas com um número suspeitamente alto de autorizações, etc. Já discutimos , que também podem ser coletados e analisados aqui.
Abaixo do mapa de calor está a lista de anomalias, onde cada uma pode ser acessada para visualização do Single Metric para uma análise detalhada.
Population
Para buscar anomalias entre correlações entre diferentes métricas no Elastic Stack, existe uma análise especializada chamada Population. É através dela que podemos procurar valores anômalos no desempenho de um servidor em comparação com os outros, por exemplo, durante um aumento no número de requisições ao sistema alvo.
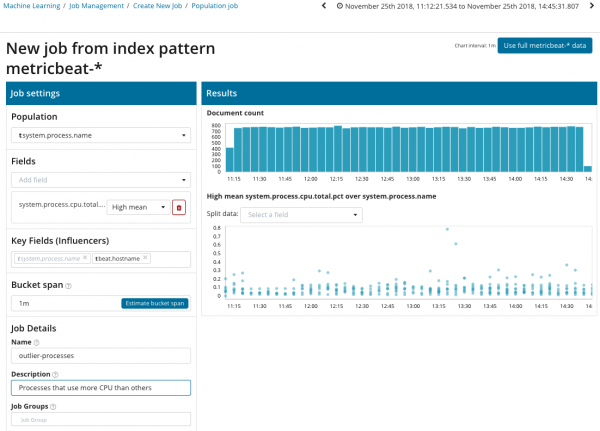
Nesta ilustração, o campo Population indica o valor ao qual as métricas analisadas serão relacionadas. Neste caso, é o nome do processo. Como resultado, veremos como a carga da CPU de cada um dos processos influenciou uns aos outros.
Observe que o gráfico dos dados analisados é diferente dos casos com Single Metric e Multi Metric. Isso foi feito no Kibana por design para uma melhor percepção da distribuição dos valores dos dados analisados.
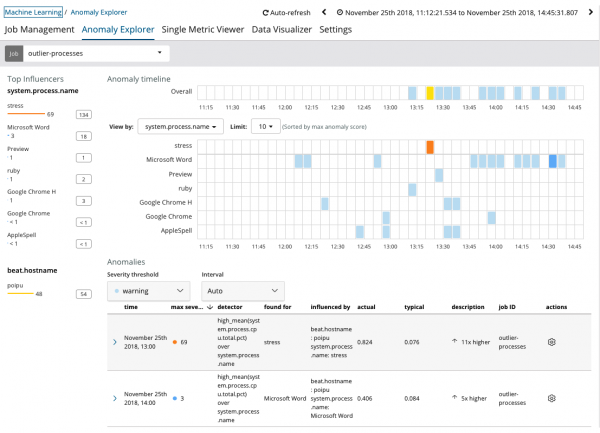
Pelo gráfico, fica claro que o processo se comportou de forma anômala stress (aliás, gerado por uma utilidade especial) no servidor poipu, que influenciou (ou se tornou um influenciador) no surgimento desta anomalia.
Avançado
Análise com ajuste fino. Na análise avançada no Kibana, aparecem configurações adicionais. Após clicar no menu de criação na tile Avançado, aparece uma janela assim com abas. A aba Job Details foi intencionalmente ignorada, pois contém configurações básicas não relacionadas diretamente ao ajuste da análise.
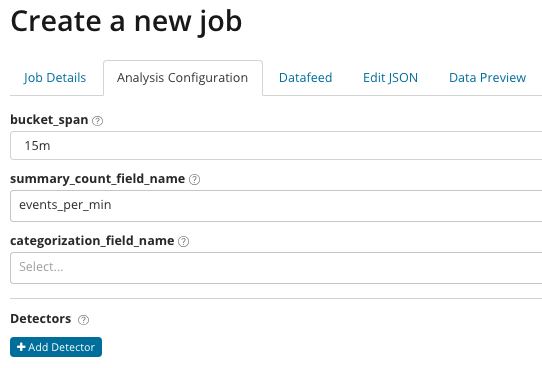
Em summary_count_field_name pode-se opcionalmente indicar o nome do campo nos documentos que contém os valores agregados. Neste exemplo — o número de eventos por minuto. Em é indicado o nome do campo no documento que contém um valor variável. Com base nesse campo, os dados analisados podem ser divididos em subconjuntos. Preste atenção no botão Add detector na ilustração anterior. Abaixo está o resultado ao clicar neste botão.
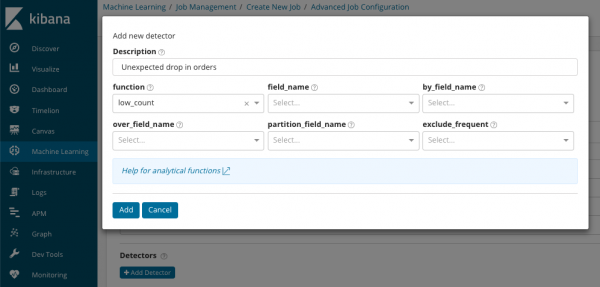
Este é um bloco adicional de configurações para ajustar o detector de anomalias para uma tarefa específica. Casos de uso específicos (especialmente em segurança) serão discutidos em artigos futuros. Por exemplo, um dos casos analisados. Ele está relacionado à busca de valores raramente aparecendo e é implementado .
No campo function você pode escolher uma função específica para a busca de anomalias. Além de rare, há mais algumas funções interessantes — . Elas identificam anomalias no comportamento das métricas ao longo do dia ou da semana, respectivamente. Outras funções de análise .
Em field_name especifica o campo do documento que será analisado. By_field_name pode ser usado para dividir os resultados da análise por cada valor individual especificado aqui. Se preencher over_field_name você obterá uma análise de população, que discutimos acima. Se um valor for especificado em partition_field_name, então para esse campo do documento serão calculadas linhas de base separadas para cada valor (o valor pode ser, por exemplo, o nome do servidor ou do processo no servidor). Em exclude_frequent pode ser selecionado all ou none, o que significará a exclusão (ou inclusão) de valores frequentemente encontrados nos campos dos documentos.
Neste artigo, tentamos apresentar de forma resumida as possibilidades de aprendizado de máquina no Elastic Stack, ainda há muitos detalhes que ficaram de fora. Compartilhe nos comentários quais casos você conseguiu resolver com o Elastic Stack e para quais tarefas você o utiliza. Para entrar em contato conosco, você pode usar mensagens diretas no Habr ou .
Fonte: habr.com
