

Olá a todos! Há alguns meses, lançamos em produção nosso novo projeto open-source — um plugin Grafana para monitoramento de Kubernetes, que chamamos de . O código-fonte do plugin está disponível em . Neste artigo, queremos compartilhar com vocês a história de como criamos o plugin, quais ferramentas utilizamos e com quais dificuldades nos deparamos no processo de desenvolvimento. Vamos lá!
Parte 0 — Introdução: como chegamos até aqui?
A ideia de escrever nosso próprio plugin para Grafana surgiu completamente por acaso. Nossa empresa trabalha há mais de 10 anos com monitoramento de projetos web de diferentes niveis de complexidade. Ao longo do tempo, acumulamos uma vasta experiência, casos interessantes e conhecimento sobre o uso de diversos sistemas de monitoramento. Em um certo momento, nos perguntamos: "Será que existe uma ferramenta mágica para monitoramento de Kubernetes, que, como se diz, 'basta instalar e esquecer'?". O padrão da indústria para monitoramento de k8s é, naturalmente, a combinação Prometheus + Grafana. Existem várias ferramentas prontas para esse stack: prometheus-operator, um conjunto de dashboards kubernetes-mixin, grafana-kubernetes-app.
A opção que nos parecia mais interessante foi o plugin grafana-kubernetes-app, mas ele não é mantido há mais de um ano e, além disso, não funciona com as novas versões do node-exporter e kube-state-metrics. Em um certo ponto, decidimos: "Por que não criar nossa própria solução?"
Quais ideias decidimos implementar em nosso plugin:
- visualização de 'mapa de aplicação': uma representação conveniente das aplicações no cluster, agrupadas por namespaces, deploys…;
- visualização de relações do tipo 'deployment — service (+ports)'.
- visualização da distribuição das aplicações do cluster pelos nós do cluster.
- coleta de métricas e informações de várias fontes: Prometheus e servidor API do k8s.
- monitoramento tanto da parte de infraestrutura (uso do tempo de CPU, memória, subsistema de disco, rede), quanto da lógica das aplicações — status de saúde dos pods, quantidade de réplicas disponíveis, informações sobre a execução de sondagens de liveness/readyness.
Parte 1: O que é 'um plugin para Grafana'?
Do ponto de vista técnico, um plugin para Grafana é um controlador Angular, armazenado na diretório de dados do Grafana (/var/grafana/plugins/<your_plugin_name>/dist/module.js) e pode ser carregado como um módulo SystemJS. Além disso, deve haver um arquivo plugin.json neste diretório, contendo todas as metainformações sobre o seu plugin: nome, versão, tipo de plugin, links para o repositório/site/licença, dependências e assim por diante.
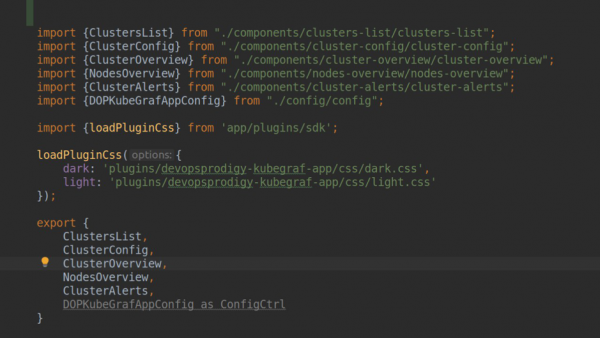
module.ts
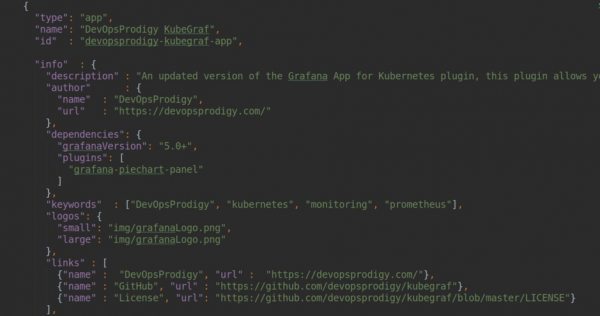
plugin.json
Como mostrado na captura de tela, nós especificamos plugin.type = app. Os plugins para o Grafana podem ser de três tipos:
painel: o tipo mais comum de plugins — representa um painel para visualização de métricas, usado para criar vários dashboards.
datasource: plugin-conector para algum fonte de dados (por exemplo, Prometheus-datasource, ClickHouse-datasource, ElasticSearch-datasource).
app: plugin que permite construir seu próprio aplicativo frontend dentro do Grafana, criar suas próprias páginas html e acessar manualmente a fonte de dados para visualizar diferentes dados. Plugins de outros tipos (datasource, panel) e diferentes dashboards também podem ser usados como dependências.
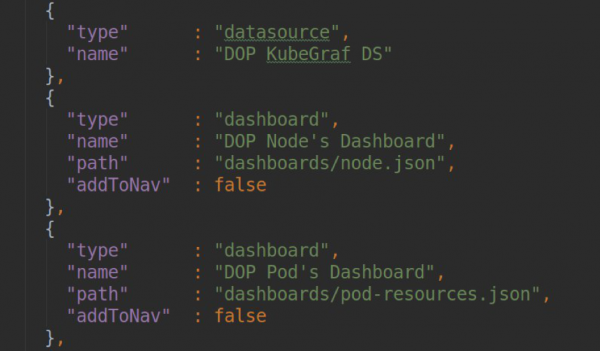
Exemplo de dependências de um plugin com type = app.
Como linguagem de programação, você pode usar tanto JavaScript quanto TypeScript (optamos por este último). Você pode encontrar templates para plugins hello-world de qualquer tipo : este repositório apresenta uma grande quantidade de starter-pack's (há até um exemplo experimental de plugin em React) com construtores pré-instalados e configurados.
Parte 2: preparação do ambiente local
Para trabalhar no plugin, precisamos, naturalmente, de um cluster Kubernetes com todas as ferramentas pré-instaladas: prometheus, node-exporter, kube-state-metrics, grafana. O ambiente deve ser configurado rapidamente, de forma fácil e descontraída, e para garantir a recarga dinâmica, o diretório de dados do Grafana deve ser montado diretamente da máquina do desenvolvedor.
Na nossa opinião, a maneira mais conveniente de trabalhar localmente com Kubernetes é . Em seguida, instalamos a combinação Prometheus + Grafana usando prometheus-operator. No é descrito detalhadamente o processo de instalação do prometheus-operator no minikube. Para incluir persistência, é necessário definir o parâmetro persistence: true no arquivo charts/grafana/values.yaml, adicionar seu próprio PV e PVC e especificá-los no parâmetro persistence.existingClaim
O script final para iniciar o minikube fica assim:
minikube start --kubernetes-version=v1.13.4 --memory=4096 --bootstrapper=kubeadm --extra-config=scheduler.address=0.0.0.0 --extra-config=controller-manager.address=0.0.0.0
minikube mount
/home/sergeisporyshev/Projects/Grafana:/var/grafana --gid=472 --uid=472 --9p-version=9p2000.L
Parte 3: desenvolvimento propriamente dito
Modelo de Objeto
Como preparação para a implementação do plugin, decidimos descrever todas as entidades básicas do Kubernetes com as quais iremos trabalhar na forma de classes TypeScript: pod, deployment, daemonset, statefulset, job, cronjob, service, node, namespace. Cada uma dessas classes herda da classe base BaseModel, onde estão descritos o construtor, o destrutor, métodos para atualização e alternância de visibilidade. Em cada uma das classes estão descritas as relações internas com outras entidades, por exemplo, a lista de pods da entidade do tipo deployment.
import {Pod} from "./pod";
import {Service} from "./service";
import {BaseModel} from './traits/baseModel';

export class Deployment extends BaseModel{
   pods: Array;
   services: Array;

   constructor(data: any){
       super(data);
       this.pods = [];
       this.services = [];
   }
}
Com os getters e setters, podemos exibir ou definir as métricas necessárias das entidades de forma conveniente e legível. Por exemplo, saída formatada do allocatable cpu de um nó:
get cpuAllocatableFormatted(){
   let cpu = this.data.status.allocatable.cpu;
   if(cpu.indexOf('m') > -1){
       cpu = parseInt(cpu)/1000;
   }
   return cpu;
}
Páginas
A lista de todas as páginas do nosso plugin é inicialmente descrita no nosso pluing.json na seção de dependências:
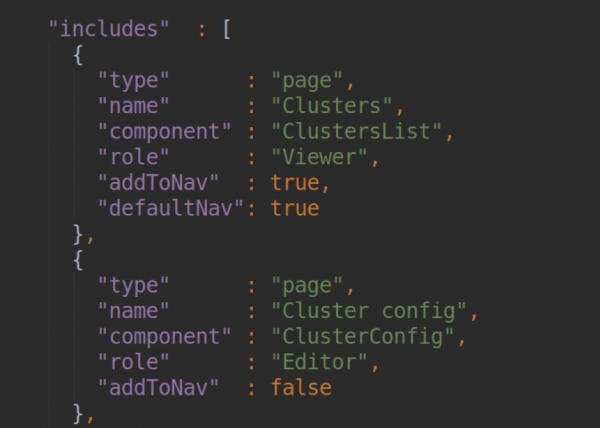
No bloco para cada página, devemos especificar o NOME DA PÁGINA (que será convertido em slug, pelo qual esta página estará acessível); o nome do componente responsável pelo funcionamento desta página (a lista de componentes é exportada em module.ts); a indicação do papel do usuário para o qual esta página está acessível e as configurações de navegação para a barra lateral.
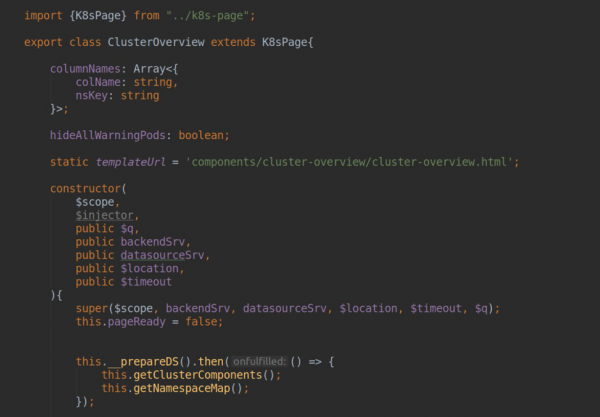
No componente responsável pelo funcionamento da página, devemos definir templateUrl, passando o caminho para o arquivo html com a marcação. Dentro do controlador, através da injeção de dependência, podemos acessar 2 serviços importantes do angular:
- backendSrv — serviço que garante interação com o servidor API do Grafana;
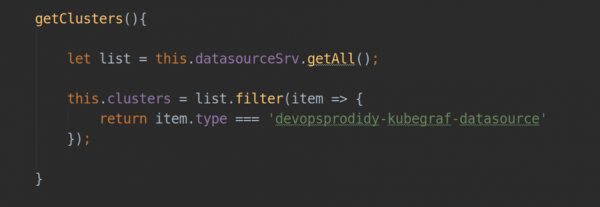
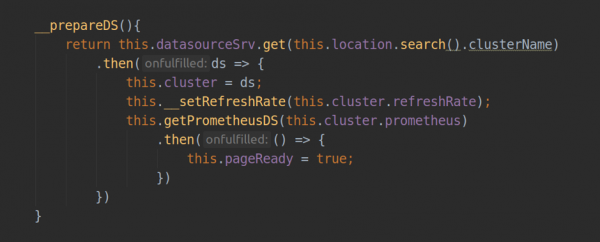
- datasourceSrv — serviço que garante a interação local com todas as fontes de dados instaladas no seu Grafana (por exemplo, o método .getAll() — retorna a lista de todas as fontes de dados instaladas; .get() — retorna o objeto-instância de uma fonte de dados específica.
Parte 4: datasource
Do ponto de vista do Grafana, a fonte de dados representa um plugin exatamente como todos os outros: ela possui seu ponto de entrada module.js e um arquivo de metainformação plugin.json. Ao desenvolver um plugin com type = app, podemos interagir tanto com fontes de dados já existentes (por exemplo, prometheus-datasource) quanto com nossas próprias, que podemos armazenar diretamente no diretório do plugin (dist/datasource/*) ou instalar como dependência. No nosso caso, a fonte de dados é fornecida junto com o código do plugin. Também é imprescindível ter um template config.html e um controlador ConfigCtrl, que serão utilizados para a página de configuração da instância da fonte de dados e o controlador Datasource, no qual a lógica de funcionamento da sua fonte de dados é implementada.
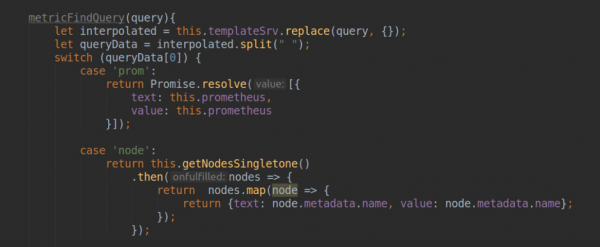
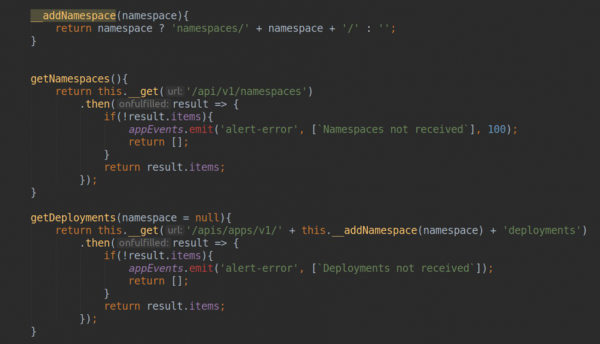
No plugin KubeGraf, do ponto de vista da interface do usuário, a fonte de dados representa uma instância de um cluster Kubernetes, que implementa as seguintes funcionalidades (o código-fonte está disponível ):
- coleta de dados do api-server do k8s (obtenção da lista de namespaces, deployments…)
- proxy de requisições para o prometheus-datasource (que é selecionado nas configurações do plugin para cada cluster específico) e formatação de respostas para utilizar os dados tanto em páginas estáticas quanto em dashboards.
- atualização de dados em páginas estáticas do plugin (com um tempo de refresh rate definido).
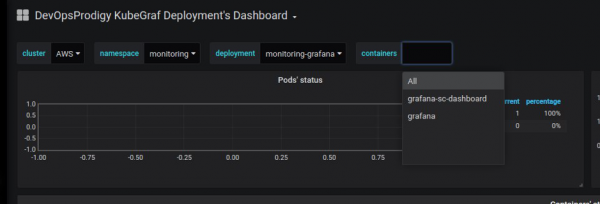
- processamento de requisições para formação da lista de templates nos grafana-dashboards (método .metriFindQuery())
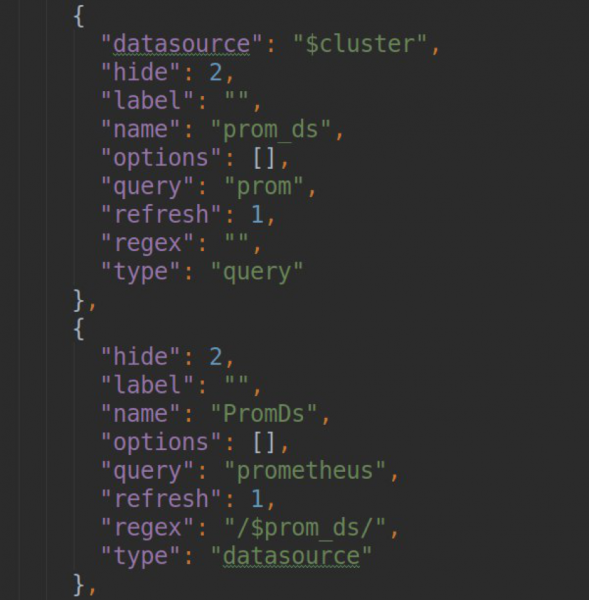
- teste de conexão com o cluster k8s final.
testDatasource(){
   let url = '/api/v1/namespaces';
   let _url = this.url;
   if(this.accessViaToken)
       _url += '/__proxy';
   _url += url;
   return this.backendSrv.datasourceRequest({
       url: _url,
       method: "GET",
       headers: {"Content-Type": 'application/json'}
   })
       .then(response => {
           if (response.status === 200) {
               return {status: "success", message: "Fonte de dados está OK", title: "Sucesso"};
           }else{
               return {status: "error", message: "Fonte de dados não está OK", title: "Erro"};
           }
       }, error => {
           return {status: "error", message: "Fonte de dados não está OK", title: "Erro"};
       })
}
Um ponto interessante, na nossa opinião, é a implementação do mecanismo de autenticação e autorização para o datasource. Geralmente, de forma padrão, para a configuração de acesso ao fonte de dados final, podemos utilizar o componente integrado do Grafana — datasourceHttpSettings. Com este componente, podemos configurar o acesso ao fonte de dados http, especificando a URL e as configurações básicas de autenticação/autorização: login-senha ou client-cert/client-key. Para implementar a possibilidade de configuração de acesso utilizando um token bearer (o padrão de fato para k8s), foi necessário fazer algumas "mágicas".
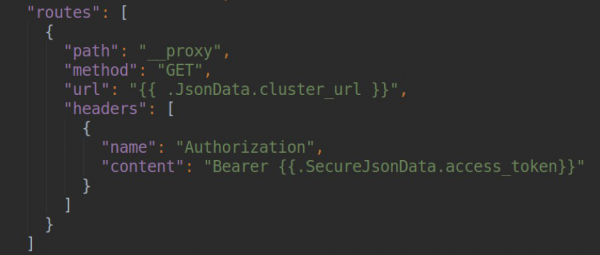
Para resolver esta tarefa, podemos usar o mecanismo integrado do Grafana "Plugin Routes" (mais detalhes em ). Nas configurações do nosso datasource, podemos declarar um conjunto de regras de roteamento que serão processadas pelo servidor proxy do Grafana. Por exemplo, para cada endpoint específico, há a possibilidade de definir cabeçalhos ou URLs com a capacidade de templating, cujos dados podem ser extraídos dos campos jsonData e secureJsonData (para armazenar senhas ou tokens de forma criptografada). No nosso exemplo, os pedidos do tipo /__proxy/api/v1/namespaces serão proxyados para uma URL do tipo
/api/v1/namespaces com a adição do cabeçalho Authorization: Bearer.
Naturalmente, para trabalhar com o servidor api do k8s, precisamos de um usuário com permissões somente leitura, cujos manifests para a criação você pode encontrar em .
Parte 5: lançamento
Depois que você escrever seu próprio plugin para o Grafana, naturalmente, você vai querer disponibilizá-lo publicamente. No Grafana, há uma biblioteca de plugins acessível pelo link
Para que seu plugin esteja disponível na loja oficial, é necessário fazer um PR em , adicionando ao arquivo repo.json um conteúdo do tipo:
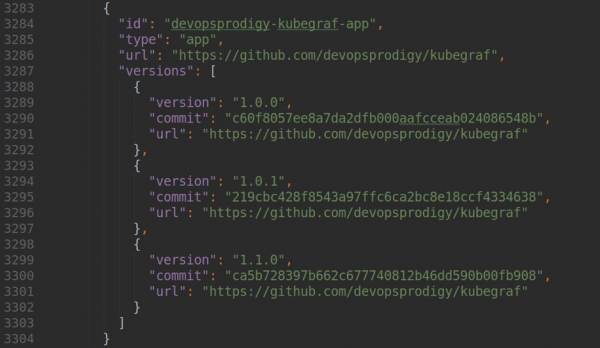
onde version — versão do seu plugin, url — link para o repositório, e commit — hash do commit pelo qual uma versão específica do plugin estará disponível.
E no final, você verá uma imagem maravilhosa como esta:
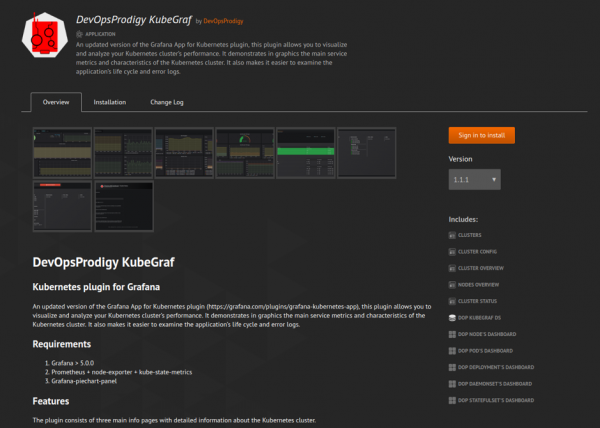
Os dados para isso serão automaticamente extraídos do seu Readme.md, Changelog.md e do arquivo plugin.json com a descrição do plugin.
Parte 6: em vez de conclusões
Não paramos o desenvolvimento do nosso plugin após o lançamento. Atualmente, estamos trabalhando para monitorar corretamente o uso dos recursos das nodos do cluster, implementando novos recursos para melhorar a experiência do usuário e lidando com uma grande quantidade de feedback recebido após as instalações do plugin, tanto de nossos clientes quanto de issues no GitHub (se você deixar seu issue ou pull request, eu ficarei muito feliz 🙂 ).
Esperamos que este artigo ajude você a entender essa ferramenta maravilhosa chamada Grafana e, quem sabe, a escrever seu próprio plugin.
Obrigado!)
Fonte: habr.com
