

Há alguns meses — um serviço para PostgreSQL.
Desde então, você já o utilizou mais de 6000 vezes, mas uma das funcionalidades convenientes pode ter passado despercebida — isso é dicas estruturais, que se parecem mais ou menos assim:
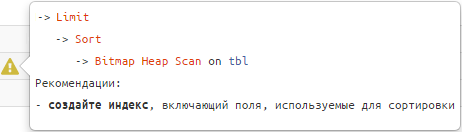
Ouça-as, e suas consultas "ficarão suaves como seda". 🙂
E falando sério, muitas situações que tornam a consulta lenta e "gastadora" de recursos são típicas e podem ser reconhecidas pela estrutura e dados do plano.
Nesse caso, cada desenvolvedor individual não precisará procurar uma forma de otimização por conta própria, confiando apenas em sua experiência — podemos sugerir o que está acontecendo, qual pode ser a causa, e como abordar a solução. O que fizemos.
Vamos olhar esses casos com um pouco mais de detalhe — como eles são definidos e quais recomendações eles trazem.
Para uma melhor imersão no tema, você pode primeiro ouvir o bloco correspondente da , e então passar para a análise detalhada de cada exemplo:
#1: индексная «недосортировка»
Quando surge
Mostrar a fatura mais recente para o cliente "LLC Sininho".
Como identificar
-> Limite
   -> Ordenar
      -> Índice [Apenas] Varredura [Reversa] | Varredura em Bitmap
Recomendações
Índice usado ampliar pelos campos de ordenação.
Exemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fatos"
, (random() * 1000)::integer fk_cli; -- 1K diferentes chaves estrangeiras

CREATE INDEX ON tbl(fk_cli); -- índice para chave estrangeira

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- filtragem por relação específica
ORDER BY
  pk DESC -- queremos apenas um "último" registro
LIMIT 1; 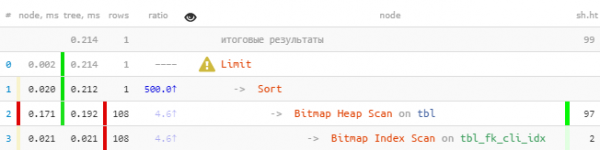
Pode-se notar imediatamente que mais de 100 registros foram lidos pelo índice, que depois foram todos ordenados, e então foi deixado apenas um.
Corrigindo:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- adicionamos a chave de ordenação
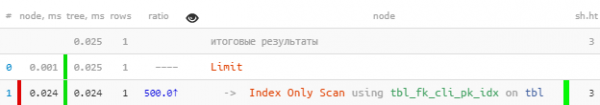
Mesmo em uma seleção tão primitiva — 8,5 vezes mais rápido e 33 vezes menos leituras. O efeito será mais evidente quanto mais você tiver "fatos" para cada valor fk.
Nota que tal índice funcionará como um "prefixo" tão bem quanto o anterior e para outras consultas com fk, onde não houve nem há ordenações por pk (mais sobre isso pode ser lido ). Incluindo, garantirá um suporte adequado à chave estrangeira explícita para este campo. Mostrar todos os contratos para o cliente "LLC Sininho", celebrados em nome de "NAO Bulat".
#2: пересечение индексов (BitmapAnd)
Quando surge
-> BitmapAnd -> Varredura em Bitmap -> Varredura em Bitmap
Como identificar
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Recomendações
Criar índice composto pelos campos de ambas as fontes ou expandir um dos existentes com campos da segunda.
Exemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fatos"
, (random() *  100)::integer fk_org  -- 100 chaves externas diferentes
, (random() * 1000)::integer fk_cli; -- 1K chaves externas diferentes

CREATE INDEX ON tbl(fk_org); -- índice para chave estrangeira
CREATE INDEX ON tbl(fk_cli); -- índice para chave estrangeira

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- seleção por um par específico 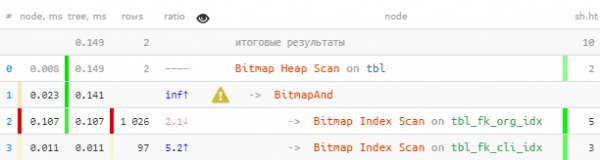
Corrigindo:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
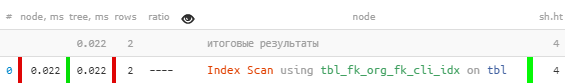
Aqui a melhoria é menor, pois o Bitmap Heap Scan é suficientemente eficiente por si só. Contudo, 7 vezes mais rápido e 2,5 vezes menos leituras.
#3: объединение индексов (BitmapOr)
Quando surge
Mostrar os 20 mais antigos "próprios" ou solicitações não designadas para processamento, sendo as próprias uma prioridade.
Como identificar
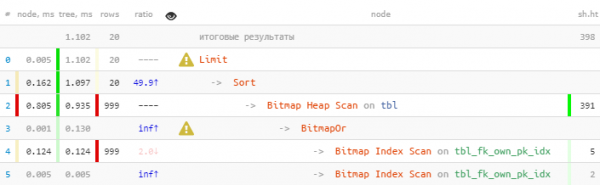
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Recomendações
Usar UNION [ALL] para a junção de subconsultas para cada um dos blocos de condições OR.
Exemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fatos"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- com probabilidade de 1:16 a entrada é "empate"
    ELSE (random() * 100)::integer -- 100 chaves externas diferentes
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- índice com ordenação "aparentemente adequada"

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- próprios
  fk_own IS NULL -- ... ou "empates"
ORDER BY
  pk
, (fk_own = 1) DESC -- primeiro "próprios"
LIMIT 20;
Corrigindo:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- primeiros "próprios" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- depois "empates" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- mas no total - 20, mais do que isso não é necessário 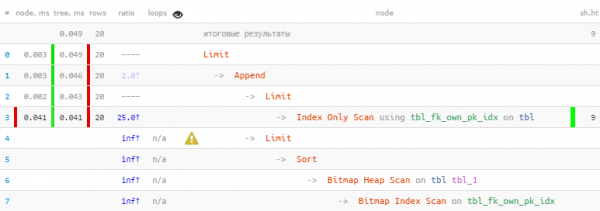
Aproveitamos que todos os 20 registros necessários foram obtidos imediatamente no primeiro bloco, portanto o segundo, com o Bitmap Heap Scan mais "caro", nem foi executado — no resultado 22 vezes mais rápido, 44 vezes menos leituras!
Uma explicação mais detalhada sobre este método de otimização em exemplos concretos pode ser lida em artigos e .
Versão generalizada de seleção ordenada por várias chaves (e não apenas por um par const/NULL) é discutida no artigo .
#4: читаем много лишнего
Quando surge
Geralmente surge ao desejar "adicionar mais um filtro" a uma consulta já existente.
"Mas você não tem algo assim, mas com botões de madrepérola?» filme "A Mão do Diamante"
Por exemplo, modificando a tarefa acima, mostrar os 20 mais antigos "críticos" pedidos para processamento, independentemente da sua designação.
Como identificar
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows < RRbF -- filtrado >80% lido
   && loops × RRbF > 100 -- e ao mesmo tempo mais de 100 registros no total
Recomendações
Criar [mais] especializado índice com condição WHERE ou incluir campos adicionais no índice.
Se a condição de filtragem for "estática" para suas tarefas — ou seja, não prevê expansão da lista de valores no futuro — é melhor usar um índice WHERE. Diferentes status booleanos/enum se encaixam bem nessa categoria.
Se a condição de filtragem pode assumir diferentes valores, é melhor expandir o índice com esses campos — como na situação com BitmapAnd acima.
Exemplo:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "fatos"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 chaves estrangeiras diferentes
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, que a solicitação é "crítica"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 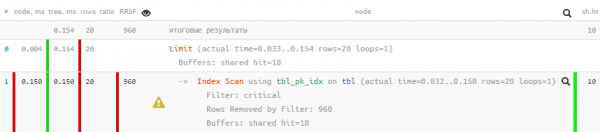
Corrigindo:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- adicionamos a condição de filtragem "estática"
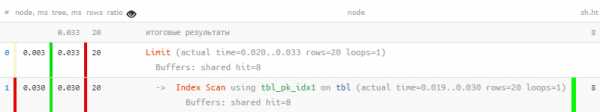
Como vemos, a filtragem do plano foi completamente removida, e a consulta se tornou 5 vezes mais rápida.
#5: разреженная таблица
Quando surge
Diversas tentativas de criar uma própria fila de processamento de tarefas, quando um grande número de atualizações/exclusões de registros na tabela resulta em uma situação com muitos registros "mortos".
Como identificar
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Recomendações
Realizar manualmente regularmente VACUUM [FULL] ou conseguir uma frequência aceitável ajustando seus parâmetros, incluindo .
Na maioria dos casos, esses problemas são causados por uma má composição de consultas em chamadas de lógica de negócios como as que foram discutidas em .
Mas é importante entender que mesmo o VACUUM FULL pode não ajudar sempre. Para tais casos, vale a pena consultar o algoritmo do artigo .
#6: чтение с «середины» индекса
Quando surge
Parece que lemos um pouco, e tudo pelo índice, e não filtramos nada desnecessário — mas ainda assim, foi lido substancialmente mais páginas do que gostaríamos.
Como identificar
-> Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Recomendações
Olhar atentamente para a estrutura do índice utilizado e os campos-chave definidos na consulta — provavelmente, parte do índice não está definida. É provável que você tenha que criar um índice semelhante, mas sem os campos prefixados ou .
Exemplo:
CRIE A TABELA tbl COMO
SELECIONE
  gerar_serie(1, 100000) pk      -- 100K "fatos"
, (aleatório() *  100)::inteiro fk_org  -- 100 diferentes chaves externas
, (aleatório() * 1000)::inteiro fk_cli; -- 1K diferentes chaves externas

CRIE UM ÍNDICE EM tbl(fk_org, fk_cli); -- tudo quase como em #2
-- apenas que um índice separado por fk_cli já consideramos desnecessário e removemos

SELECIONE
  *
DE
  tbl
ONDE
  fk_cli = 999 -- e fk_org não está definido, embora apareça no índice antes
LIMIT 20; 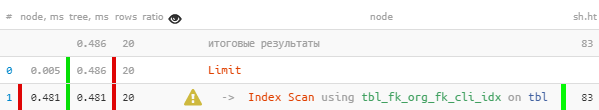
Parece que está tudo bem, até mesmo em relação ao índice, mas é um pouco suspeito — para cada uma das 20 gravações lidas, foi necessário ler 4 páginas de dados, 32KB por gravação — isso não é excessivo? E o nome do índice tbl_fk_org_fk_cli_idx provoca reflexões.
Corrigindo:
CRIE UM ÍNDICE EM tbl(fk_cli); 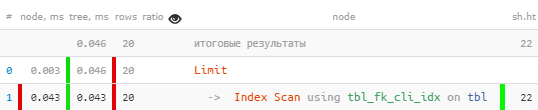
De repente — 10 vezes mais rápido, e 4 vezes menos para ler!
Outros exemplos de situações de uso ineficiente de índices podem ser vistos no artigo .
#7: CTE × CTE
Quando surge
Na consulta inserimos "CTEs volumosos" de tabelas diferentes, e depois decidimos fazer um entre eles JOIN.
O caso é relevante para versões anteriores à v12 ou consultas com COM MATERIALIZED.
Como identificar
-> CTE Scan
   && loops > 10
   && loops × (rows + RRbF) > 10000
      -- produto cartesiano CTE excessivamente grande
Recomendações
Analisar atentamente a consulta — será que ? Если все-таки да, то aplicar "dicionarização" em hstore/json segundo o modelo descrito em .
#8: swap на диск (temp written)
Quando surge
O processamento (classificação ou eliminação de duplicatas) de um grande número de registros não cabe na memória alocada para isso.
Como identificar
-> *
   && temp escrito > 0
Recomendações
Se a quantidade de memória utilizada pela operação não ultrapassa significativamente o valor configurado para o parâmetro , vale a pena ajustá-lo. Pode ser feito no arquivo de configuração para todos, ou através de SET [LOCAL] para uma consulta/transação específica.
Exemplo:
SHOW work_mem;
-- "16MB"

SELECIONE
  aleatório()
DE
  gerar_serie(1, 1000000)
ORDER BY
1; 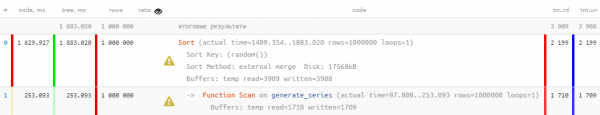
Corrigindo:
SET work_mem = '128MB'; -- antes da execução da consulta 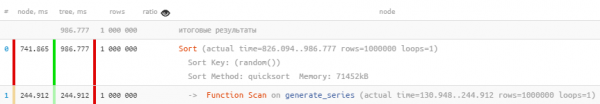
Por razões óbvias, se apenas a memória é utilizada, e não o disco, a consulta será executada muito mais rápido. Além disso, parte da carga do HDD é reduzida.
Mas é preciso entender que alocar muita memória nem sempre será possível — simplesmente não haverá o suficiente para todos.
#9: неактуальная статистика
Quando surge
No banco de dados foram injetados muitos dados, mas não tivemos tempo de executar ANALISE.
Como identificar
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Reverso]
   && razão >> 10
Recomendações
Realizar ANALISE.
Esta situação está mais detalhadamente descrita em .
#10: «что-то пошло не так»
Quando surge
Houve uma espera de bloqueio imposta por uma consulta concorrente ou não havia recursos de hardware suficientes de CPU/hypervisor.
Como identificar
-> *
   && (acesso compartilhado / 8K) + (leitura compartilhada / 1K)  100ms -- leram pouco, mas demorou demais
Recomendações
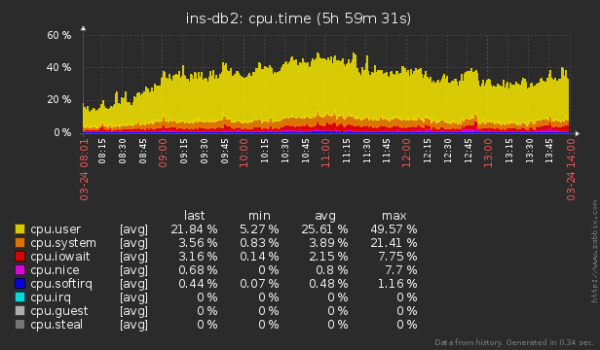
Use um externo sistema de monitoramento servidores para verificar bloqueios ou consumo anômalo de recursos. Já falamos sobre nossa forma de organizar esse processo para centenas de servidores. e .
Fonte: habr.com
