

Meu nome é Sergey, sou da empresa ITSumma, e quero contar como abordamos o backup no Kubernetes. Ultimamente, tenho trabalhado bastante em consultoria para a implementação de diversas soluções DevOps para diferentes equipes, e, em particular, estou envolvido em projetos que utilizam K8s. Na conferência Uptime Day 4, que foi dedicada ao backup em arquiteturas complexas, eu apresentei uma palestra sobre o backup do 'cubo', e aqui está uma recapitulação livre dela. Apenas aviso antecipadamente que não se trata de um guia direto, mas sim de uma síntese de reflexões sobre o assunto.
Em essência, monitoramento e backup são as duas ferramentas principais para aumentar a resiliência de qualquer projeto. Mas você dirá, no Kubernetes tudo se equilibra automaticamente, tudo se escala por si só, e se algo acontecer, tudo se recupera por si mesmo... Ou seja, em uma primeira pesquisa superficial sobre o tema, ao perguntar como as pessoas abordam o backup no K8s, a internet me respondeu 'por quê?'. Muitos pensam que o Kubernetes é uma coisa mágica que elimina todos os problemas de infraestrutura e garante que o projeto nunca falhe. Mas... o mundo não é o que parece.
Como abordamos o processo de backup no passado? Tínhamos ambientes idênticos para hospedagem — ou eram máquinas virtuais ou servidores físicos servidores, aos quais aplicávamos três práticas básicas:
- sincronização de código e estática
- sincronização de configurações
- replicação de banco de dados
E voilà: a qualquer momento, podemos alternar para o ambiente de backup, todos ficam felizes, nos levantamos e dispersamos.
E o que nos é oferecido para aumentar a disponibilidade contínua da nossa aplicação kubernetes? A primeira coisa mencionada na documentação não oficial é que devemos implementar várias máquinas, criar muitos mestres — sua quantidade deve atender aos requisitos de quórum dentro do cluster, e que em cada um dos mestres esteja ativo o etcd, api, MC, scheduler... E parece tudo maravilhoso: quando várias nós de trabalho ou mestres falham, nosso cluster se reequilibra e a aplicação continua a funcionar. Novamente soa como mágica! Mas muitas vezes nosso cluster está dentro de um único centro de dados, o que pode levantar algumas questões. O que acontece se um escavador aparecer e cortar o cabo, se um raio atingir, ou se houver uma inundação devastadora? Tudo se perderá, nosso cluster não existe mais. Como abordar a redundância considerando esse aspecto do problema?
Antes de mais nada, você deve ter outro cluster em reserva quente, ou seja, um cluster para o qual você pode alternar a qualquer momento. Nesse caso, do ponto de vista do Kubernetes, as infraestruturas devem ser totalmente idênticas. Portanto, se houver plugins não padrão para trabalhar com o sistema de arquivos, soluções personalizadas para ingress, elas devem ser completamente idênticas em seus dois (ou três, ou dez, dependendo de quanto você pode gastar e da força dos administradores) clusters. É necessário definir claramente dois conjuntos de aplicativos (deployments, statefulsets, daemonsets, cronjobs, etc.): quais deles podem operar continuamente na reserva e quais é melhor não ativar até a mudança imediata.
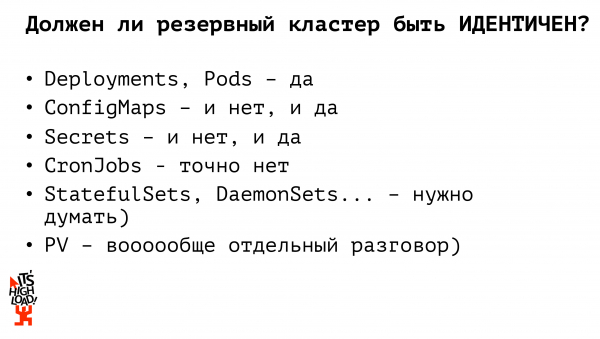
Então, nosso cluster de reserva deve ser completamente idêntico ao nosso cluster de produção? Não. Se antes, ao trabalhar com projetos monolíticos e infraestrutura física, mantínhamos um ambiente praticamente idêntico, no contexto do Kubernetes, eu acredito que isso não deve ser o caso. Vamos analisar o porquê.
Por exemplo, vamos começar com as entidades básicas do Kubernetes — deployments — que devem ser idênticas. Aplicações devem estar em execução que, a qualquer momento, podem assumir o processamento de tráfego e permitir que nosso projeto continue ativo. Quando falamos sobre arquivos de configuração, precisamos verificar se eles devem ser idênticos ou não. Ou seja, se nós, pessoas inteligentes, não consumirmos substâncias proibidas e não mantivermos o banco no K8s, então nossas configmaps devem conter as configurações de acesso ao banco de dados em produção (o processo de backup dele é construído separadamente). Portanto, para garantir o acesso ao banco de dados de reserva, devemos ter um arquivo de configuração separado (configmap). Da mesma forma, trabalhamos com secrets: senhas de acesso ao banco, chaves API; em qualquer momento, pode estar ativo ou o secret de produção, ou o de reserva. Assim, já temos duas entidades do Kubernetes, cujas versões de reserva não devem ser idênticas às de produção. A próxima entidade a se considerar é o cronjob. Os cronjobs de reserva de forma alguma devem ser idênticos ao conjunto de cronjobs do cluster de produção! Se levantarmos um cluster de reserva e o iniciarmos completamente com todos os cronjobs ativados — por exemplo, as pessoas receberão dois e-mails ao mesmo tempo em vez de um. Ou alguma sincronização de dados com fontes externas ocorrerá duas vezes, e consequentemente começamos a sofrer, chorar, gritar e nos xingar.
E como nos sugerem organizar o cluster de reserva as pessoas da internet? A segunda resposta mais popular depois de "qual o sentido?" é o uso da Kubernetes Federation.
O que é isso? É, digamos, um grande meta-cluster. Se imaginarmos a arquitetura do Kubernetes — onde temos um master e vários nós — do ponto de vista da federação, também temos um master e vários nós, mas cada nó é um cluster separado. Ou seja, estamos lidando com as mesmas entidades e primitivos que em um único Kubernetes, apenas manipulando não nossas máquinas físicas, mas clusters inteiros. Dentro da federação, temos uma sincronização completa dos recursos federativos dos pais para os filhos. Por exemplo, se fizermos um deployment através da federação — ele será implantado em cada um de nossos clusters filhotes. Se pegarmos algum configmap, segredo e o distribuirmos pela federação — ele se espalhará por todos os nossos clusters filhotes; ao mesmo tempo, a federação permite personalizar nossos recursos nos filhos. Ou seja, pegamos um configmap, implantamos através da federação e, se precisarmos fazer alguma alteração nos clusters específicos, iremos ajustar em um cluster separado, e essa mudança não será sincronizada em outros lugares.
A Federação do Kubernetes — é uma ferramenta relativamente nova, e ela não suporta um conjunto completo de recursos que o próprio K8s oferece: na época da publicação de uma das primeiras versões da documentação, mencionava-se o suporte apenas a config maps, implantações sob replica set, ingress. Segredos não eram suportados, e a interação com volumes também não era. É um conjunto muito limitado. Especialmente se gostamos de experimentar, — por exemplo, ao transmitir nossos próprios recursos para o Kubernetes através de uma definição de recurso personalizado, — na federação não conseguiremos incluí-los. Ou seja, é uma solução que se aproxima da verdade, mas nos faz atirar no próprio pé periodicamente. Por outro lado, a federação permite gerenciar nosso replicaset de forma flexível. Por exemplo, queremos que 10 réplicas do nosso aplicativo sejam executadas; por padrão, a federação dividirá esse número proporcionalmente entre os clusters. E isso pode ser configurado! Ou seja, podemos especificar que precisamos manter 6 réplicas do nosso aplicativo no cluster de produção e, no cluster de reserva, para economizar recursos ou para nossas próprias experiências, apenas 4 réplicas do nosso aplicativo. Isso é bastante conveniente. Mas com a federação, precisamos usar algumas novas soluções, implementar algo em movimento, e nos forçar a pensar um pouco mais...
É possível abordar o processo de reserva do Kubernetes de uma forma mais simples? Quais ferramentas temos à nossa disposição?
Em primeiro lugar, sempre temos algum sistema ci/cd, ou seja, não precisamos ir manualmente e escrever nos servidores create/apply. O sistema gera arquivos yaml para nossos contêineres.
Em segundo lugar, temos vários clusters, e temos um ou vários (se formos inteligentes) registries, que também reservamos. E há uma ótima ferramenta chamada kubectl, que pode trabalhar com vários clusters ao mesmo tempo.
Então, na minha opinião, a solução mais simples e correta para construir um cluster de backup é implementar um deploy paralelo primitivo. Existe um pipeline no sistema CI/CD; primeiro construímos nossos contêineres, testamos e implantamos os aplicativos através do kubectl em vários clusters independentes. Podemos fazer despliegues simultâneos em vários clusters. Assim, também resolvemos a entrega das configurações nessa etapa. É possível definir previamente um conjunto de configurações para o nosso cluster de produção e um conjunto de configurações para o cluster de backup e, no nível do sistema CI/CD, implantar o ambiente de produção no cluster de produção e o ambiente de backup no cluster de backup. Comparado à federação, não precisamos ir a cada cluster filho depois de definir o recurso federativo e reconfigurar algo. Fizemos isso com antecedência. Que maravilha somos.
Mas... há... eu escrevi que existe uma "raiz de todos os males", mas na verdade são duas. Primeiro, o sistema de arquivos. Existe algum PV, ou utilizamos um armazenamento externo. Se armazenamos arquivos dentro do cluster, precisamos agir conforme as práticas tradicionais deixadas da era das infraestruturas físicas: por exemplo, sincronizar com lsync. Ou qualquer outra gambiarra que você prefira. Diminuímos tudo em outras máquinas e seguimos vivemos.
Em segundo lugar, e, na verdade, um ponto de confronto até mais importante — o banco de dados. Se somos pessoas inteligentes e não mantemos o banco no Kubernetes, então o processo de backup de dados segue o mesmo modelo antigo — replicação master-slave, depois a mudança, alcançamos a réplica e viveremos bem. Mas se mantivermos nosso banco de dados dentro do cluster, existem muitas soluções prontas para organizar a mesma replicação master-slave, muitas soluções para levantar um banco de dados dentro do Kubernetes.
Já li bilhões de relatórios sobre backup de bancos de dados, escritos bilhões de artigos, não há nada de novo aqui, na verdade. Em geral, siga seu sonho, viva como quiser, invente também algumas gambiarras complexas, mas sempre pense em como você irá fazer o backup de tudo isso.
Agora vamos falar sobre como, em geral, o processo de mudança para um site de backup ocorrerá em caso de incêndio. Em primeiro lugar, fazemos o deploy paralelo de aplicativos sem estado. Eles não afetam a lógica de negócios de nossas aplicações, do nosso projeto, podemos ter constantemente dois conjuntos de aplicativos em execução, e eles podem começar a receber tráfego. É muito importante, no processo de mudança para o site de backup, verificar se precisamos reconfigurar as configurações. Por exemplo, temos um cluster Kubernetes de produção, um cluster Kubernetes de backup, um banco de dados externo mestre, e um banco de dados externo mestre de backup. Temos quatro opções de como esses aplicativos em produção podem começar a interagir entre si. Podemos ter a mudança do banco de dados e, nesse caso, será necessário redirecionar o tráfego no cluster de produção para o novo banco, ou o cluster pode falhar — e nós mudamos para o backup, mas continuamos trabalhando com o banco de dados de produção. Além disso, há a terceira opção, onde ambos falham, e nós mudamos ambos os aplicativos, redefinimos nossa configuração, para que os novos aplicativos funcionem com o novo banco de dados.
Então, quais conclusões podemos tirar disso tudo?
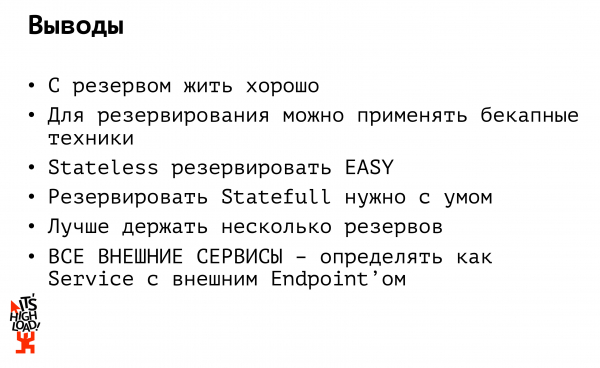
Primeira conclusão: viver com backup é bom. Mas caro. Idealmente, não devemos depender de um único backup. O ideal é viver com múltiplos backups. Em primeiro lugar, o backup deve estar, no mínimo, em mais de um centro de dados, e, em segundo lugar, de preferência, com outro provedor de hospedagem. Já aconteceu muitas vezes — e na minha experiência isso foi o que aconteceu. Infelizmente, não posso nomear os projetos, mas quando ocorreu o incêndio no centro de dados... Eu disse: vamos mudar para o backup! E os servidores de backup estavam na mesma prateleira...
Ou imagine que a Amazon foi banida na Rússia (isso já aconteceu). E pronto: não adianta que nosso backup esteja em outra Amazon? Ele também está indisponível. Portanto, eu repito: mantenha o backup, no mínimo, em outro centro de dados, e preferencialmente — com outro provedor de hospedagem.
A segunda saída: se você tem um aplicativo no Kubernetes que se comunica com alguma fonte externa (pode ser um banco de dados ou uma API externa), defina isso como um serviço com um Endpoint externo, para que no momento de uma mudança você não precise redeployar 15 de seus aplicativos que acessam o mesmo banco. Defina o banco como um serviço separado, acesse-o como se estivesse dentro do seu cluster: se o seu banco falhar, você muda o IP em um só lugar e continua feliz.
E por último: eu amo o "cubinho", assim como as experiências com ele. Também gosto de compartilhar os resultados dessas experiências e, de modo geral, minha experiência pessoal. Por isso, gravei uma série de webinars sobre K8s, venha para para mais detalhes.
Fonte: habr.com
