

Por que é necessário fazer backups? Afinal, o equipamento é bastante confiável e existem as "nuvens", que são mais seguras que servidores físicos: com a configuração correta, um servidor "na nuvem" facilmente supera a falha de um servidor físico, e do ponto de vista dos usuários dos serviços, haverá um pequeno e quase imperceptível aumento no tempo de resposta. Além disso, a duplicação de informações muitas vezes exige o pagamento de "tempo de processamento extra", carga no disco e tráfego de rede.
Um programa ideal funciona rapidamente, não consome memória de forma ineficiente, não possui falhas e não deveria existir.
—Desconhecido
Como os programas ainda são desenvolvidos por programadores humanos, e o processo de teste geralmente está ausente, além de que a entrega de programas raramente ocorre com o uso de "melhores práticas" (que por si mesmas também são programas e, portanto, não são perfeitas), os administradores de sistema frequentemente têm que lidar com tarefas que são breves, mas significativas: "restaurar como estava", "trazer a base de volta ao funcionamento normal", "funciona devagar - vamos reverter", e meu favorito "não sei o que, mas conserte".
Além dos erros lógicos que surgem devido ao trabalho descuidado dos desenvolvedores ou a circunstâncias, bem como ao conhecimento ou compreensão incompleta de detalhes menores na construção de programas — incluindo interconexões e sistemas, como sistemas operacionais, drivers e firmware — existem outros erros. Por exemplo, a maioria dos desenvolvedores confia no tempo de execução, esquecendo completamente das leis físicas, que ainda não podem ser contornadas por programas. Isso inclui a infinita confiabilidade dos subsistemas de disco e, de maneira geral, de qualquer subsistema de armazenamento de dados (incluindo memória RAM e cache do processador!), e o tempo de processamento em zero no processador, a ausência de erros na transmissão de dados pela rede e na manipulação no processador, e latências na rede que são iguais a 0. Não devemos desconsiderar o famoso prazo final, pois se não for cumprido, surgirão problemas que superam as sutilezas do funcionamento da rede e do disco.
Como lidar com os problemas que surgem de forma abrupta e ameaçam dados valiosos? Não há como substituir desenvolvedores humanos, e não é certo que isso será possível em breve. Por outro lado, até agora, apenas alguns projetos conseguiram provar que o software funcionará conforme planejado, e não é garantido que tais provas possam ser aplicadas a outros projetos semelhantes. Além disso, tais evidências demandam muito tempo e requerem habilidades e conhecimentos específicos, o que praticamente reduz ao mínimo a possibilidade de sua aplicação considerando os prazos. Além disso, ainda não conseguimos desenvolver uma tecnologia de armazenamento, processamento e transmissão de informações que seja rápida, barata e infinitamente confiável. Tecnologias desse tipo, se existem, estão apenas em forma de conceitos ou, na maioria das vezes, somente em livros e filmes de ficção científica.
Artistas bons copiam, grandes artistas roubam.
—Pablo Picasso.
As soluções mais bem-sucedidas e as coisas surpreendentemente simples normalmente ocorrem onde se encontram conceitos, tecnologias, conhecimentos e áreas de ciência que, à primeira vista, parecem totalmente incompatíveis.
Por exemplo, aves e aviões têm asas, no entanto, apesar da semelhança funcional — o princípio de funcionamento coincide em alguns modos, e problemas técnicos são resolvidos de maneira semelhante: ossos ocos, uso de materiais leves e resistentes, etc. — os resultados são absolutamente diferentes, embora sejam bastante semelhantes. Os melhores exemplos que vemos em nossa tecnologia também são, em sua maior parte, emprestados da natureza: compartimentos herméticos em navios e submarinos são uma analogia direta com os vermes anelídeos; a construção de matrizes RAID e a verificação da integridade dos dados são uma duplicação da cadeia de DNA; além disso, órgãos pares, independência do funcionamento de diferentes órgãos do SNC (autonomia do trabalho do coração) e reflexos — sistemas autônomos na Internet. Claro que aplicar soluções prontas de maneira direta pode levar a problemas, mas quem sabe, pode ser que não haja outras soluções.
Se eu soubesse onde vou cair, teria estendido a palha!
—Provérbio popular bielorrusso
Portanto, backups são vitais para quem deseja:
- Ter a capacidade de restaurar o funcionamento de seus sistemas com o mínimo de paralisações, ou até mesmo sem elas.
- Aja de agir com confiança, pois em caso de erro sempre há a possibilidade de reverter.
- Minimizar as consequências da corrupção intencional dos dados.
Aqui está um pouco de teoria.
Qualquer classificação é arbitrária. A natureza não classifica. Nós classificamos, porque é assim que nos convém. E classificamos com base em dados que também escolhemos de forma arbitrária.
— Jean Bruller
Independentemente da forma física de armazenamento, o armazenamento lógico dos dados pode ser condicionalmente dividido em 2 formas de acesso a esses dados: por bloco e por arquivo. Essa divisão tem se tornado bastante nebulosa recentemente, já que não existem armazenamentos lógicos puramente em bloco ou puramente em arquivo. Contudo, para simplificar, vamos considerar que eles existem.
O armazenamento de dados em bloco implica que há um dispositivo físico onde os dados são gravados em porções fixas, blocos. O acesso aos blocos é feito por meio de um endereço, e cada bloco tem seu próprio endereço dentro do dispositivo.
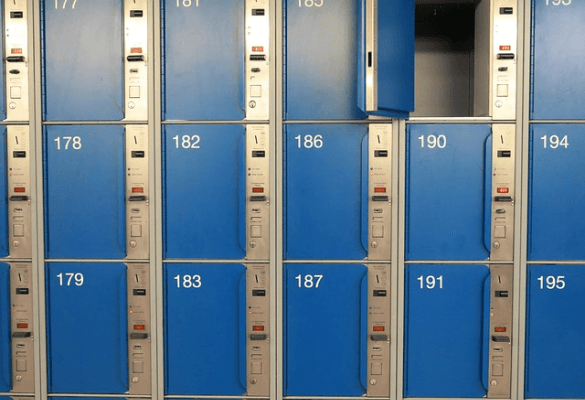
Uma cópia de segurança geralmente é feita copiando blocos de dados. Para garantir a integridade dos dados no momento da cópia, a gravação de novos blocos é suspensa, assim como a alteração dos existentes. Se tomarmos uma analogia do mundo comum — é mais parecido com um armário com compartimentos numerados iguais.
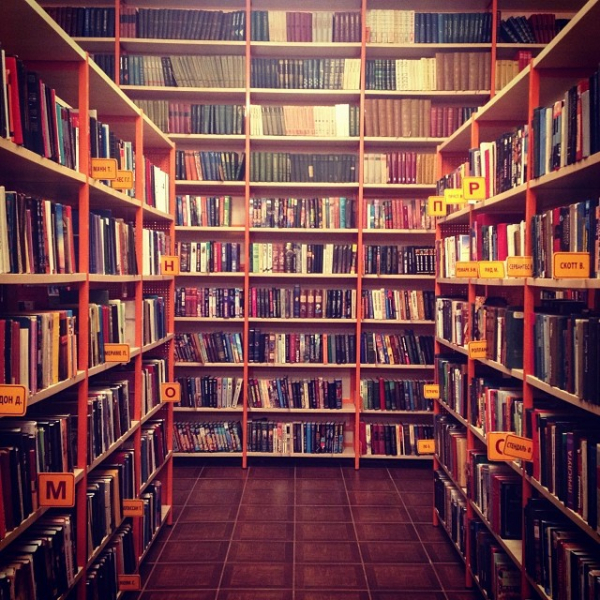
O armazenamento de dados em arquivos, do ponto de vista lógico, é semelhante ao armazenamento em bloco e muitas vezes é organizado em cima dele. As diferenças importantes são a presença de uma hierarquia de armazenamento e nomes compreensíveis para os humanos. Destaca-se uma abstração sob a forma de arquivo — uma área de dados nomeada, bem como um diretório — um arquivo especial que contém descrições e acessos a outros arquivos. Os arquivos podem ser acompanhados de metadados adicionais: data de criação, flags de acesso, etc. A cópia de segurança geralmente é realizada assim: procura-se arquivos alterados e, em seguida, copia-se para outro armazenamento de arquivos com a mesma estrutura. A integridade dos dados é normalmente implementada pela ausência de arquivos nos quais a gravação está em andamento. Os metadados dos arquivos de backup são reservados de forma semelhante. A analogia mais próxima é uma biblioteca, que possui seções com diferentes livros, bem como um catálogo com nomes compreensíveis dos livros.
Recentemente, às vezes descrevem outra opção, a partir da qual, na verdade, começou o armazenamento de dados e que possui as mesmas características arcaicas: armazenamento de objetos.
Diferente do armazenamento de arquivos, não possui uma hierarquia maior que um nível (esquema plano), e embora os nomes dos arquivos sejam legíveis para humanos, são mais adequados para processamento por máquinas. Durante o backup, os armazenamentos de objetos costumam ser tratados de forma semelhante aos arquivos, mas às vezes existem outras opções.
— Existem dois tipos de administradores de sistemas: aqueles que não fazem backups e aqueles que JÁ os fazem.
— Na verdade, há três tipos: também existem aqueles que verificam se os backups são recuperáveis.—Desconhecido
É importante entender também que o próprio processo de backup de dados é realizado por programas, portanto, possui todas as desvantagens de qualquer outro programa. Para eliminar (não excluir!) a dependência do fator humano, bem como das peculiaridades — que individualmente não têm grande impacto, mas que juntas podem ter um efeito significativo — aplica-se a chamada regra 3-2-1. Há muitas maneiras de interpretá-la, mas eu prefiro a seguinte interpretação: devem ser mantidos 3 conjuntos dos mesmos dados, 2 conjuntos devem ser armazenados em formatos diferentes, e 1 conjunto deve estar em um armazenamento geograficamente remoto.
Por formato de armazenamento deve-se entender o seguinte:
- Se houver dependência do método físico de armazenamento — muda-se o método físico.
- Se houver dependência do método lógico de armazenamento — muda-se o método lógico.
Para alcançar o máximo efeito da regra 3-2-1, recomenda-se mudar o formato de armazenamento de ambas as maneiras.
Do ponto de vista da prontidão do backup para seu propósito original — a recuperação da funcionalidade — distinguem-se os backups 'quentes' e 'frios'. Os backups quentes diferem dos frios apenas em um aspecto: estão imediatamente prontos para uso, enquanto os frios exigem algumas ações adicionais para a recuperação: descompactação, extração do arquivo, etc.
Não se deve confundir cópias quentes e frias com cópias online e offline, que implicam na isolação física dos dados, e que, por essência, representam outra classificação das maneiras de fazer backups. Assim, uma cópia offline — que não está conectada diretamente ao sistema onde deve ser restaurada — pode ser tanto quente quanto fria (em termos de prontidão para a recuperação). Uma cópia online pode ser acessada diretamente onde é necessária a restauração, e geralmente é quente, mas também podem existir cópias frias.
Além disso, não se deve esquecer que o próprio processo de criação de backups geralmente não se encerra na criação de uma única cópia, podendo haver um número considerável de cópias. Portanto, é necessário distinguir entre backups completos, ou seja, aqueles que podem ser restaurados independentemente de outros backups, e as cópias diferenciadas (incrementais, diferenciais, decrementais, etc.) — aquelas que não podem ser restauradas por conta própria e requerem a restauração prévia de uma ou várias outras cópias.
Cópias incrementais diferenciadas são uma tentativa de economizar espaço de armazenamento para backups. Assim, apenas os dados alterados desde o último backup são gravados na cópia de backup.
Cópias decrementais diferenciadas são criadas com o mesmo objetivo, mas de uma forma um pouco diferente: é feito um backup completo, mas realmente é armazenada apenas a diferença entre a cópia nova e a anterior.
Vale ressaltar o processo de backup sobre um armazenamento que suporta a ausência de armazenamento de duplicatas. Assim, se forem feitas cópias de backup completas sobre ele, realmente será gravada apenas a diferença entre os backups, no entanto, o processo de recuperação dos backups ocorrerá de maneira semelhante à recuperação a partir de uma cópia completa e será totalmente transparente.
Quis custodiet ipsos custodes?
(Quem vigia os vigias? — lat.)
É bastante desagradável quando não existem backups, porém é muito pior se parece que o backup foi feito, mas durante a recuperação verifica-se que ele não pode ser restaurado, porque:
- A integridade dos dados originais foi comprometida.
- O armazenamento com os backups está danificado.
- A recuperação ocorre de forma bastante lenta, e não se pode utilizar os dados que foram parcialmente restaurados.
Um processo de backup bem estruturado deve levar em consideração tais observações, especialmente as duas primeiras.
A integridade dos dados originais pode ser garantida de várias maneiras. As mais comumente usadas são: a) criação de cópias de sombra do sistema de arquivos em nível de bloco, b) 'congelamento' do estado do sistema de arquivos, c) dispositivo de bloco especial com armazenamento de versões, d) gravação sequencial de arquivos ou blocos. Também são utilizados checksums para garantir a verificação dos dados durante a recuperação.
Danos ao armazenamento também podem ser detectados por meio de checksums. Um método adicional é o uso de dispositivos especializados ou sistemas de arquivos onde os dados já gravados não podem ser alterados, mas novos dados podem ser acrescentados.
Para acelerar a recuperação, utiliza-se a recuperação de dados com múltiplos processos de restauração — desde que não haja um 'gargalo' causado por uma rede lenta ou um sistema de disco não rápido. Para contornar a situação com dados parcialmente restaurados, pode-se dividir o processo de backup em subtarefas relativamente pequenas, cada uma executada separadamente. Assim, é possível restaurar a funcionalidade de forma sequencial, prevendo o tempo necessário para a recuperação. Esta questão frequentemente está relacionada ao plano organizacional (SLA), portanto não iremos detalhar isso aqui.
Quem entende de temperos não é aquele que adiciona a cada prato, mas sim o que nunca acrescenta nada desnecessário.
—V. Sinyavsky
A prática em relação ao software utilizado por administradores de sistema pode variar, mas os princípios gerais continuam os mesmos, em particular:
- É altamente recomendável utilizar soluções prontas.
- Os programas devem funcionar de forma previsível, ou seja, não deve haver características não documentadas ou gargalos.
- A configuração de cada programa deve ser simples o suficiente para que não seja necessário ler o manual ou uma cola toda vez.
- A solução deve ser universal, pois os servidores podem diferir bastante em suas características de hardware.
Para realizar cópias de segurança de dispositivos de bloco, existem os seguintes programas comuns:
- dd, conhecida entre os veteranos da administração de sistemas, também inclui programas semelhantes (como dd_rescue, por exemplo).
- Programas (utilitários) integrados em alguns sistemas de arquivos que criam um ‘dump’ do sistema de arquivos.
- Utilitários genéricos; por exemplo, partclone.
- Soluções próprias, muitas vezes proprietárias; como NortonGhost e versões mais recentes.
Para sistemas de arquivos, a tarefa de backup é parcialmente resolvida com métodos aplicáveis a dispositivos de bloco, mas pode ser feita de forma mais eficiente utilizando, por exemplo:
- Rsync, um programa e protocolo universal para sincronização do estado dos sistemas de arquivos.
- Ferramentas integradas para arquivamento (ZFS).
- Ferramentas de arquivamento de terceiros; o mais popular é o tar. Existem outras, como dar, que é uma substituta do tar focada em sistemas modernos.
Vale a pena mencionar os softwares que garantem a consistência dos dados durante a criação de backups. Os seguintes métodos são frequentemente utilizados:
- Montar o sistema de arquivos em modo somente leitura (ReadOnly), ou congelar o sistema de arquivos (freeze) — método aplicável de forma limitada.
- Criar ‘snapshots’ do estado dos sistemas de arquivos ou dispositivos de bloco (LVM, ZFS).
- Usar ferramentas de terceiros para a criação de ‘snapshots’, mesmo nos casos em que os métodos anteriores não podem ser aplicados por algum motivo (programas do tipo hotcopy).
- A técnica de cópia ao alterar (CopyOnWrite), no entanto, geralmente está ligada ao sistema de arquivos utilizado (BTRFS, ZFS).
Portanto, para um pequeno servidor, é necessário garantir um esquema de backup que atenda aos seguintes requisitos:
- Simples de usar — não requer ações adicionais especiais durante o funcionamento, e tem ações mínimas para a criação e restauração de cópias.
- Universal — funciona tanto em servidores grandes quanto pequenos; isso é importante à medida que o número servidores ou a escalabilidade aumenta.
- Instalado pelo gerenciador de pacotes, ou em um a dois comandos do tipo ‘baixar e descompactar’.
- Estável — utiliza um formato de armazenamento padrão ou já consolidado há muito tempo.
- Rápida em operação.
Candidatos que mais ou menos atendem aos requisitos:
- rdiff-backup
- rsnapshot
- burp
- duplicati
- duplicity
- deja dup
- dar
- zbackup
- restic
- borgbackup
Uma máquina virtual (baseada em XenServer) será utilizada como ambiente de teste com as seguintes características:
- 4 núcleos de 2,5 GHz,
- 16 GB de memória RAM,
- 50 GB de armazenamento híbrido (armazenamento em nuvem com cache em SSD de 20% do tamanho do disco virtual) em um disco virtual separado sem partição,
- canal de 200 Mbit/s para a Internet.
O servidor receptor de backups será quase idêntico, apenas com um disco rígido de 500 GB.
Sistema operacional — Centos 7 x64: partição padrão, uma seção adicional será usada como fonte de dados.
Como dados de origem, utilizaremos um site WordPress, com arquivos de mídia de 40 GB e um banco de dados MySQL. Como servidores virtuais as características variam significativamente, e para melhor reprodutibilidade, aqui estão
os resultados dos testes do servidor usando o sysbench.sysbench —threads=4 —time=30 —cpu-max-prime=20000 cpu run
sysbench 1.1.0-18a9f86 (usando LuaJIT 2.1.0-beta3 incluído)
Executando o teste com as seguintes opções:
Número de threads: 4
Inicializando o gerador de números aleatórios a partir do tempo atual
Limite de números primos: 20000
Inicializando threads de trabalho…
Threads iniciadas!
Velocidade da CPU:
eventos por segundo: 836,69
Taxa de transferência:
eventos/s (eps): 836,6908
tempo decorrido: 30,0039s
número total de eventos: 25104
Latência (ms):
mínimo: 2,38
média: 4,78
máximo: 22,39
percentil 95: 10,46
soma: 119923,64
Equidade de threads:
eventos (média/desvio padrão): 6276,0000/13,91
tempo de execução (média/desvio padrão): 29,9809/0,01
sysbench —threads=4 —time=30 —memory-block-size=1K —memory-scope=global —memory-total-size=100G —memory-oper=read memory run
sysbench 1.1.0-18a9f86 (usando LuaJIT 2.1.0-beta3 incluído)
Executando o teste com as seguintes opções:
Número de threads: 4
Inicializando o gerador de números aleatórios a partir do tempo atual
Executando o teste de velocidade de memória com as seguintes opções:
tamanho do bloco: 1KiB
tamanho total: 102400MiB
operação: leitura
escopo: global
Inicializando threads de trabalho…
Threads iniciadas!
Total de operações: 50900446 (1696677,10 por segundo)
49707,47 MiB transferidos (1656,91 MiB/s)
Taxa de transferência:
eventos/s (eps): 1696677,1017
tempo decorrido: 30,0001s
número total de eventos: 50900446
Latência (ms):
mínimo: 0,00
média: 0,00
máximo: 24,01
percentil 95: 0,00
soma: 39106,74
Equidade de threads:
eventos (média/desvio padrão): 12725111,5000/137775,15
tempo de execução (média/desvio padrão): 9,7767/0,10
sysbench —threads=4 —time=30 —memory-block-size=1K —memory-scope=global —memory-total-size=100G —memory-oper=write memory run
sysbench 1.1.0-18a9f86 (usando LuaJIT 2.1.0-beta3 incluído)
Executando o teste com as seguintes opções:
Número de threads: 4
Inicializando o gerador de números aleatórios a partir do tempo atual
Executando o teste de velocidade de memória com as seguintes opções:
tamanho do bloco: 1KiB
tamanho total: 102400MiB
operação: escrita
escopo: global
Inicializando threads de trabalho…
Threads iniciadas!
Total de operações: 35910413 (1197008,62 por segundo)
35068,76 MiB transferidos (1168,95 MiB/s)
Taxa de transferência:
eventos/s (eps): 1197008,6179
tempo decorrido: 30,0001s
número total de eventos: 35910413
Latência (ms):
mínimo: 0,00
média: 0,00
máximo: 16,90
percentil 95: 0,00
soma: 43604,83
Equidade de threads:
eventos (média/desvio padrão): 8977603,2500/233905,84
tempo de execução (média/desvio padrão): 10,9012/0,41
sysbench —threads=4 —file-test-mode=rndrw —time=60 —file-block-size=4K —file-total-size=1G fileio run
sysbench 1.1.0-18a9f86 (usando LuaJIT 2.1.0-beta3 incluído)
Executando o teste com as seguintes opções:
Número de threads: 4
Inicializando o gerador de números aleatórios a partir do tempo atual
Flags extras para abertura de arquivo: (nenhum)
128 arquivos, 8MiB cada
1GiB de tamanho total de arquivo
Tamanho do bloco 4KiB
Número de solicitações de IO: 0
Relação de leitura/escrita para teste aleatório combinado de IO: 1,50
FSYNC periódico ativado, chamando fsync() a cada 100 solicitações.
Chamando fsync() ao final do teste, ativado.
Usando modo de I/O síncrono
Realizando teste de leitura/escrita aleatória
Inicializando threads de trabalho…
Threads iniciadas!
Taxa de transferência:
leitura: IOPS=3868,21 15,11 MiB/s (15,84 MB/s)
escrever: IOPS=2578.83 10.07 MiB/s (10.56 MB/s)
fsync: IOPS=8226.98
Latência (ms):
mínimo: 0,00
média: 0.27
máx: 18.01
percentil 95: 1.08
soma: 238469.45
Este artigo inicia um grande
ciclo de artigos sobre backup
- Backup, parte 1: Por que o backup é necessário, visão geral dos métodos e tecnologias,
- Backup, parte 2: Visão geral e teste de ferramentas de backup baseadas em rsync
- Backup, parte 3: Revisão e teste do duplicity, duplicaty, deja dup
- Backup, parte 4: Visão geral e teste do zbackup, restic, borgbackup,
- Backup, parte 5: Teste do bacula e veeam backup for linux
- Backup, Parte 6: Comparação de ferramentas de backup
- Backup, parte 7: Conclusões
Fonte: habr.com
