

No início deste mês, em 3 de maio, foi anunciado um grande lançamento do "sistema de gerenciamento para armazenamento de dados distribuído no Kubernetes" — . Mais de um ano atrás, já uma visão geral do Rook. Naquela ocasião, fomos solicitados a falar sobre a experiência de seu uso na prática — e agora, com este marco tão significativo na história do projeto, estamos felizes em compartilhar as impressões acumuladas.
Se resumirmos, o Rook é um conjunto de para Kubernetes que assumem totalmente o controle do provisionamento, gerenciamento e recuperação automática de soluções de armazenamento de dados, como Ceph, EdgeFS, Minio, Cassandra e CockroachDB.
Atualmente, a solução mais avançada (e em desempenho em fase) é .
Nota: entre as mudanças significativas no lançamento do Rook 1.0.0 relacionadas ao Ceph, podemos destacar o suporte para Ceph Nautilus e a capacidade de usar NFS para buckets CephFS ou RGW. Outras melhorias incluem a "maturação" do suporte ao EdgeFS até o estágio beta.
Assim, neste artigo nós:
- responderemos à pergunta sobre quais vantagens vemos no uso do Rook para implantar o Ceph em um cluster Kubernetes;
- compartilharemos experiências e impressões sobre o uso do Rook em produção;
- contaremos por que dizemos "Sim!" ao Rook e nossos planos para ele.
Vamos começar com conceitos e teoria gerais.
"Eu tenho uma vantagem de uma Torre!" (jogador de xadrez desconhecido)
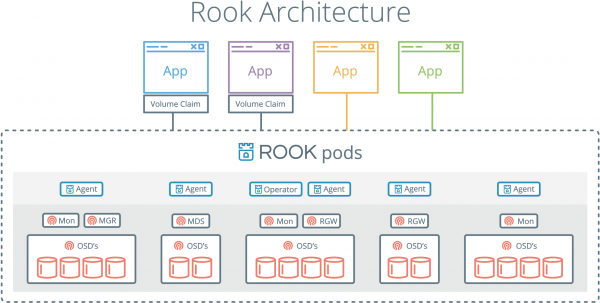
Uma das principais vantagens do Rook é que a interação com os armazenamentos de dados é feita através dos mecanismos do Kubernetes. Isso significa que não é mais necessário copiar comandos para configurar o Ceph de um papel para o console.
— Quer implantar o CephFS no cluster? Basta escrever um arquivo YAML!
— O quê? Quer implantar também um armazenamento de objetos com a API S3? Basta escrever um segundo arquivo YAML!
O Rook é criado de acordo com todas as regras de um operador típico. A interação com ele ocorre através de , nas quais descrevemos as características necessárias das entidades Ceph (uma vez que esta é a única implementação estável, o artigo tratará principalmente do Ceph, a menos que explicitamente indicado de outra forma). De acordo com os parâmetros especificados, o operador executará automaticamente os comandos necessários para a configuração.
Vamos considerar os detalhes usando o exemplo da criação de um Armazenamento de Objetos, ou melhor, CephObjectStoreUser.
apiVersion: ceph.rook.io/v1
kind: CephObjectStore
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  metadataPool:
    failureDomain: host
    replicated:
      size: 3
  dataPool:
    failureDomain: host
    erasureCoded:
      dataChunks: 2
      codingChunks: 1
  gateway:
    type: s3
    sslCertificateRef:
    port: 80
    securePort:
    instances: 1
    allNodes: false
---
apiVersion: ceph.rook.io/v1
kind: CephObjectStoreUser
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  store: {{ .Values.s3.crdName }}
  displayName: {{ .Values.s3.username }}
Os parâmetros especificados no anúncio são bastante padrão e provavelmente não precisam de comentários, no entanto, deve-se prestar especial atenção àqueles que estão destacados nas variáveis dos modelos.
O esquema geral de funcionamento resume-se ao fato de que, através do arquivo YAML, “encomendamos” recursos, para os quais o operador executa os comandos necessários e nos retorna um “segredo não tão verdadeiro”, com o qual podemos trabalhar posteriormente. (veja abaixo). E a partir das variáveis mencionadas acima, será montado um comando e o nome do segredo.
O que é esse comando? Ao criar um usuário para o armazenamento de objetos, o operador Rook dentro do pod executará o seguinte:
radosgw-admin user create --uid="rook-user" --display-name="{{ .Values.s3.username }}"O resultado da execução deste comando será uma estrutura JSON:
{
    "user_id": "rook-user",
    "display_name": "{{ .Values.s3.username }}",
    "keys": [
        {
           "user": "rook-user",
           "access_key": "NRWGT19TWMYOB1YDBV1Y",
           "secret_key": "gr1VEGIV7rxcP3xvXDFCo4UDwwl2YoNrmtRlIAty"
        }
    ],
    ...
}
Chaves — o que será necessário no futuro para os aplicativos acessarem o armazenamento de objetos através da API S3. O operador Rook gentilmente escolhe essas chaves e as armazena em seu namespace sob a forma de um segredo chamado rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}.
Para usar os dados deste segredo, basta adicioná-los ao contêiner como variáveis de ambiente. Como exemplo, apresento um modelo para uma Job, onde automaticamente criamos buckets para cada ambiente de usuário:
{{- range $bucket := $.Values.s3.bucketNames }}
apiVersion: batch/v1
kind: Job
metadata:
  name: create-{{ $bucket }}-bucket-job
  annotations:
    "helm.sh/hook": post-install
    "helm.sh/hook-weight": "2"
spec:
  template:
    metadata:
      name: create-{{ $bucket }}-bucket-job
    spec:
      restartPolicy: Never
      initContainers:
      - name: waitdns
        image: alpine:3.6
        command: ["/bin/sh", "-c", "while ! getent ahostsv4 rook-ceph-rgw-{{ $.Values.s3.crdName }}; do sleep 1; done" ]
      - name: config
        image: rook/ceph:v1.0.0
        command: ["/bin/sh", "-c"]
        args: ["s3cmd --configure --access_key=$(ACCESS-KEY) --secret_key=$(SECRET-KEY) -s --no-ssl --dump-config | tee /config/.s3cfg"]
        volumeMounts:
        - name: config
          mountPath: /config
        env:
        - name: ACCESS-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: AccessKey
        - name: SECRET-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: SecretKey
      containers:
      - name: create-bucket
        image: rook/ceph:v1.0.0
        command:
        - "s3cmd"
        - "mb"
        - "--host=rook-ceph-rgw-{{ $.Values.s3.crdName }}"
        - "--host-bucket= "
        - "s3://{{ $bucket }}"
        ports:
        - name: s3-no-sll
          containerPort: 80
        volumeMounts:
        - name: config
          mountPath: /root
      volumes:
      - name: config
        emptyDir: {}
---
{{- end }}
Todas as ações listadas neste Job foram realizadas sem sair do Kubernetes. As estruturas descritas nos arquivos YAML estão organizadas em um repositório Git e podem ser reutilizadas várias vezes. Isso representa uma grande vantagem para os engenheiros DevOps e para o processo CI/CD como um todo.
Com Rook e Rados, é uma alegria.
O uso da combinação Ceph + RBD impõe certas limitações na montagem de volumes em pods.
Em particular, deve haver um segredo no namespace para acesso ao Ceph, para que aplicativos stateful possam funcionar. É aceitável ter 2-3 ambientes em seus namespaces: você pode simplesmente copiar o segredo manualmente. Mas o que fazer se um ambiente separado é criado para cada feature para os desenvolvedores?
Nós resolvemos esse problema com , que copiava automaticamente os segredos para novos namespaces (um exemplo de um hook semelhante está descrito em ).
#! /bin/bash

if [[ $1 == “--config” ]]; then
   cat <<EOF
{"onKubernetesEvent":[
 {"name": "OnNewNamespace",
  "kind": "namespace",
  "event": ["add"]
  }
]}
EOF
else
    NAMESPACE=$(kubectl get namespace -o json | jq '.items | max_by( .metadata.creationTimestamp ) | .metadata.name')
    kubectl -n ${CEPH_SECRET_NAMESPACE} get secret ${CEPH_SECRET_NAME} -o json | jq ".metadata.namespace="${NAMESPACE}"" | kubectl apply -f -
fi
No entanto, ao usar o Rook, esse problema simplesmente não existe. O processo de montagem ocorre através de seus próprios drivers baseados em ou (ainda em estágio beta) e, portanto, não requer segredos.
O Rook resolve automaticamente muitos problemas, o que nos leva a usá-lo em novos projetos.
O Cerco de Rook
Vamos concluir a parte prática implantando o Rook e o Ceph para que possamos realizar nossos próprios experimentos. Para facilitar a tomada dessa torre intransponível, os desenvolvedores prepararam um pacote Helm. Vamos baixá-lo:
$ helm fetch rook-master/rook-ceph --untar --version 1.0.0 No arquivo rook-ceph/values.yaml podemos encontrar várias configurações diferentes. O mais importante é especificar as tolerâncias para os agentes e a busca. Para que podemos usar o mecanismo de taints/tolerations, discutimos em detalhes em .
Resumidamente, não queremos que os pods com o aplicativo cliente fiquem nos mesmos nós onde estão os discos para armazenamento de dados. A razão é simples: assim, o funcionamento dos agentes Rook não afetará o próprio aplicativo.
Então, abrimos o arquivo rook-ceph/values.yaml com nosso editor favorito e adicionamos o seguinte bloco ao final:
discover:
  toleration: NoExecute
  tolerationKey: node-role/storage
agent:
  toleration: NoExecute
  tolerationKey: node-role/storage
  mountSecurityMode: Any
Em cada nó reservado para armazenamento de dados, adicionamos o corresponde taint:
$ kubectl taint node ${NODE_NAME} node-role/storage="":NoExecuteEm seguida, instalamos o gráfico Helm com o comando:
$ helm install --namespace ${ROOK_NAMESPACE} ./rook-cephAgora, é necessário criar um cluster e especificar a localização :
apiVersion: ceph.rook.io/v1
kind: CephCluster
metadata:
  clusterName: "ceph"
  finalizers:
  - cephcluster.ceph.rook.io
  generation: 1
  name: rook-ceph
spec:
  cephVersion:
    image: ceph/ceph:v13
  dashboard:
    enabled: true
  dataDirHostPath: /var/lib/rook/osd
  mon:
    allowMultiplePerNode: false
    count: 3
  network:
    hostNetwork: true
  rbdMirroring:
    workers: 1
  placement:
    all:
      tolerations:
      - key: node-role/storage
        operator: Exists
  storage:
    useAllNodes: false
    useAllDevices: false
    config:
      osdsPerDevice: "1"
      storeType: filestore
    resources:
      limits:
        memory: "1024Mi"
      requests:
        memory: "1024Mi"
    nodes:
    - name: host-1
      directories:
      - path: "/mnt/osd"
    - name: host-2
      directories:
      - path: "/mnt/osd"
    - name: host-3
      directories:
      - path: "/mnt/osd"
Verificamos o status do Ceph — devemos esperar ver HEALTH_OK:
$ kubectl -n ${ROOK_NAMESPACE} exec $(kubectl -n ${ROOK_NAMESPACE} get pod -l app=rook-ceph-operator -o name -o jsonpath='{.items[0].metadata.name}') -- ceph -sTambém vamos verificar se os pods com o aplicativo cliente não estão sendo alocados nos nós reservados para o Ceph:
$ kubectl -n ${APPLICATION_NAMESPACE} get pods -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeNameEm seguida, opcionalmente, configure os componentes adicionais. Mais detalhes podem ser encontrados em . Para a administração, recomendamos fortemente a instalação do dashboard e do toolbox.
Rook e suas armadilhas: será que o Rook dá conta de tudo?
Como pode ser visto, o desenvolvimento do Rook está em pleno andamento. No entanto, ainda existem problemas que nos impedem de renunciar completamente à configuração manual do Ceph:
- Nenhum driver Rook exportar métricas de uso de blocos montados, o que nos priva de monitoramento.
- Flexvolume e CSI não conseguem redimensionar volumes (diferente do RBD), portanto, o Rook perde uma ferramenta útil (e às vezes até crítica!).
- O Rook ainda não é tão flexível quanto o Ceph convencional. Se quisermos configurar para que o pool de metadados CephFS seja armazenado em SSD, enquanto os dados fiquem em HDD, será necessário especificar grupos de dispositivos separados nas CRUSH maps manualmente.
- Apesar de o rook-ceph-operator ser considerado estável, atualmente existem certos problemas na atualização do Ceph da versão 13 para a 14.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
«Atualmente, a Torre está fechada para o mundo exterior por peões, mas acreditamos que um dia ela desempenhará um papel crucial na partida!» (citação inventada especialmente para este artigo)
O projeto Rook, sem dúvida, conquistou nossos corações - acreditamos que [com todos os seus prós e contras] ele definitivamente merece a sua atenção.
Nossos planos futuros se resumem a fazer do rook-ceph um módulo para , o que tornará seu uso em nossos numerosos clusters Kubernetes ainda mais simples e conveniente.
P.S.
Confira também em nosso blog:
- «»;
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
