

Em 29 de janeiro, o comitê técnico da organização CNCF (Cloud Native Computing Foundation), responsável por Kubernetes, Prometheus e outros produtos Open Source do mundo dos containers e cloud native, aprova o projeto Rook em seu grupo. Uma ótima oportunidade para conhecer melhor este "orquestrador de sistemas de armazenamento de dados distribuídos no Kubernetes".
O que é o Rook?
— é um software escrito em Go ( sobre a licença Apache License 2.0), destinado a dotar os armazenamentos de dados com funções automatizadas que os tornam autogerenciáveis, autoescaláveis e autorrecuperáveis. Para isso, o Rook automatiza (para os armazenamentos de dados utilizados no ambiente Kubernetes): implantação, inicialização, configuração, provisionamento, escalonamento, atualizações, migrações, recuperação de falhas, monitoramento e gerenciamento de recursos.
O projeto está em fase alfa e se especializa na orquestração do sistema de armazenamento distribuído Ceph nos clusters Kubernetes. Os autores também afirmam planos para suportar outros sistemas de armazenamento, mas isso não ocorrerá nas versões mais próximas.
Componentes e estrutura técnica
A base do funcionamento do Rook dentro do Kubernetes é um operador especial (falamos mais sobre Kubernetes Operators em ), que automatiza a configuração do armazenamento e implementa seu monitoramento.
Então, o operador Rook é apresentado como um container que contém tudo o que é necessário para a implantação e manutenção subsequente do armazenamento. Entre as responsabilidades do operador estão:
- criação de um DaemonSet para os demônios de armazenamento Ceph () com um cluster RADOS simples;
- criação de pods para monitoramento do Ceph (com , que verificam o estado do cluster; para um quórum, na maioria dos casos, são implantadas três instâncias, e se qualquer uma delas falha, uma nova é levantada);
- gerenciamento de CRDs () para o próprio , , (conjuntos de recursos e serviços para atender solicitações HTTP, que executam PUT/GET para objetos, — eles são compatíveis com S3 e Swift API), além de ;
- inicialização de pods para executar todos os serviços necessários;
- criação de agentes Rook.
Os agentes Rook são apresentados como pods separados, que são implantados em cada nó do Kubernetes. A finalidade do agente é configurar o plugin , que fornece suporte para volumes de armazenamento no Kubernetes. O agente gerencia o armazenamento: conecta dispositivos de armazenamento em rede, monta volumes, formata o sistema de arquivos, etc.
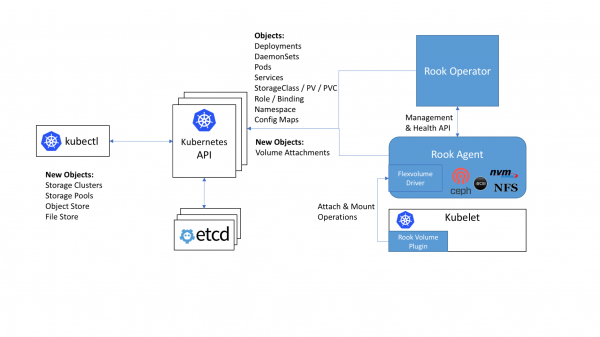
O lugar e o papel dos componentes Rook no esquema geral do cluster Kubernetes
O Rook oferece três tipos de armazenamento:
- (Block,
StorageClass) — monta o armazenamento a um único pod; - (Object,
ObjectStore) — disponível dentro e fora do cluster Kubernetes (via API S3); - (Shared File System,
Filesystem) — sistema de arquivos que pode ser montado como leitura e escrita por múltiplos pods.
O dispositivo interno do Rook inclui:
- Mons — pods para monitorar o Ceph (com os já mencionados ceph-mon);
- OSDs — pods com demônios ceph-osd (Demônios de Armazenamento de Objetos);
- MGR — pods com o demônio (Ceph Manager), que fornece funcionalidades adicionais de monitoramento e interfaces para sistemas externos (monitoramento/gestão);
- RGW (opcional) — pods com armazenamento de objeto;
- MDS (opcional) — pods com sistema de arquivos compartilhado.
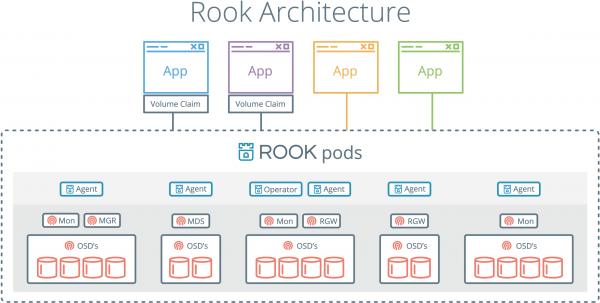
Todos os demônios do Rook (Mons, OSDs, MGR, RGW, MDS) são compilados em um único binário (rook), executado em um contêiner.
Para uma breve apresentação do projeto Rook, também pode ser útil este pequeno (12 slides) de Bassam Tabbara (CTO da Quantum Corp).
Operação do Rook
O operador Rook oferece suporte total ao Kubernetes na versão 1.6 e superior (e, parcialmente, a versão mais antiga do K8s — 1.5.2). Sua instalação em é assim:
cd cluster/examples/kubernetes
kubectl create -f rook-operator.yaml
kubectl create -f rook-cluster.yaml
Além disso, para o operador Rook, foi preparado um , permitindo que a instalação possa ser realizada também dessa maneira:
helm repo add rook-alpha https://charts.rook.io/alpha
helm install rook-alpha/rook
Há um pequeno número de (por exemplo, você pode desativar o suporte a , se essa funcionalidade não for utilizada no seu cluster), que são passadas ao helm install através do parâmetro --set key=value[,key=value] (ou armazenar em um arquivo YAML separado e passar — através de -f values.yaml).
Após a instalação do operador Rook e a execução dos pods com seus agentes, resta criar o próprio cluster Rook, cuja configuração mais simples é a seguinte (rook-cluster.yaml):
apiVersion: v1
kind: Namespace
metadata:
  name: rook
---
apiVersion: rook.io/v1alpha1
kind: Cluster
metadata:
  name: rook
  namespace: rook
spec:
  dataDirHostPath: /var/lib/rook
  storage:
    useAllNodes: true
    useAllDevices: false
    storeConfig:
      storeType: bluestore
      databaseSizeMB: 1024
journalSizeMB: 1024Nota: deve-se prestar atenção especial ao atributo dataDirHostPath, cujo valor correto é necessário para manter o cluster após reinicializações. Para casos de uso como um local de armazenamento permanente de dados, os autores do Rook recomendam ter pelo menos 5 GB de espaço livre em disco neste diretório nos hosts Kubernetes.
Resta criar o cluster a partir da configuração e garantir que os pods foram criados no cluster (no namespace rook):
kubectl create -f rook-cluster.yaml
kubectl -n rook get pod
NOME                              PRONTO     STATUS    REINICIAÇÕES   IDADE
rook-api-1511082791-7qs0m         1/1       Em Execução   0          5m
rook-ceph-mgr0-1279756402-wc4vt   1/1       Em Execução   0          5m
rook-ceph-mon0-jflt5              1/1       Em Execução   0          6m
rook-ceph-mon1-wkc8p              1/1       Em Execução   0          6m
rook-ceph-mon2-p31dj              1/1       Em Execução   0          6m
rook-ceph-osd-0h6nb               1/1       Em Execução   0          5m
Atualização do cluster Rook (para uma nova versão) é um procedimento que neste estágio requer a atualização sequencial de todos os seus componentes em uma ordem específica, e pode ser iniciado apenas depois de garantir que a instalação atual do Rook está em estado completamente 'saudável'. Um guia passo a passo detalhado usando a atualização do Rook da versão 0.5.0 para 0.5.1 pode ser encontrado na .
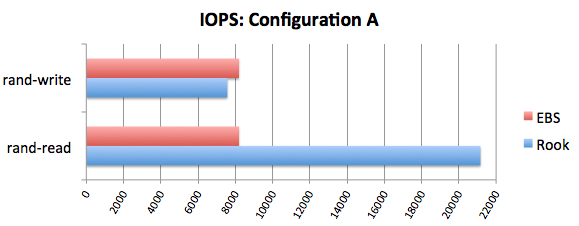
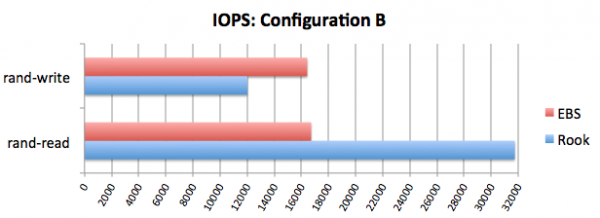
Em novembro do ano passado, no blog do Rook uma comparação de desempenho com EBS. Os resultados merecem atenção e, em resumo, são os seguintes:
Perspectivas
O status atual do Rook é alpha, e o último grande lançamento até o momento é , lançada em novembro de 2017 (a correção atual é — lançada em 14 de dezembro). Já na primeira metade de 2018, são esperados lançamentos de versões mais maduras: betas e estáveis (oficialmente prontas para uso em produção).
De acordo com do projeto, os desenvolvedores têm uma visão detalhada sobre o desenvolvimento do Rook, pelo menos em dois lançamentos próximos: 0.7 (sua prontidão no rastreador do GitHub como 60%) e 0.8. Entre as mudanças esperadas estão a transição do suporte a Ceph Block e Ceph Object para o status beta, provisionamento dinâmico de volumes para CephFS, um sistema de logging avançado, atualizações automatizadas do cluster, suporte a snapshots para volumes.
A aceitação do Rook entre ainda está em uma fase inicial — 'inception-level', — ao lado de e ) é uma garantia única do crescente interesse pelo produto. O quanto ele se consolidará no mundo das aplicações em nuvem ficará mais claro após o lançamento de versões estáveis, que certamente trarão novos 'testadores' e usuários para o Rook.
P.S.
Confira também em nosso blog:
- «»;
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
