

Ideias e reuniões sobre quais outros processos podem ser automatizados surgem em empresas de diferentes escalas diariamente. Mas além do tempo que pode ser gasto na criação do modelo, é necessário investir tempo na sua avaliação e na verificação se o resultado obtido não é aleatório. Após a implementação, qualquer modelo deve ser monitorado e periodicamente verificado.
E essas são todas etapas que devem ser percorridas em qualquer empresa, independentemente de seu tamanho. Se falamos sobre a escala e a infraestrutura do Sberbank, o número de ajustes finos aumenta exponencialmente. Até o final de 2019, já havia mais de 2000 modelos em uso no Sber. Não basta apenas desenvolver um modelo; é preciso se integrar aos sistemas industriais, desenvolver data lakes para construir modelos e garantir o controle de suas operações em cluster.
Nossa equipe está desenvolvendo a plataforma Sber.DS. Ela permite resolver problemas de machine learning, acelera o processo de verificação de hipóteses, simplifica, em geral, o processo de desenvolvimento e validação de modelos, além de monitorar o resultado do trabalho do modelo em produção.
Para não frustrar suas expectativas, quero dizer antecipadamente que este post é introdutório, e abaixo falaremos sobre o que, em essência, está por trás da plataforma Sber.DS. A história do ciclo de vida de um modelo, da criação à implementação, será contada separadamente.
O Sber.DS é composto por vários componentes, dos quais os principais são a biblioteca, o sistema de desenvolvimento e o sistema de execução de modelos.
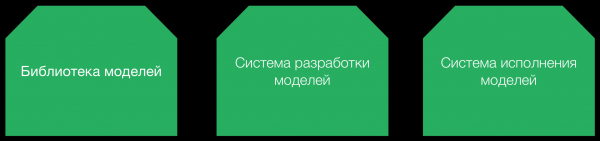
A biblioteca controla o ciclo de vida do modelo desde o momento em que a ideia de desenvolvê-lo surge até a implementação em produção, monitoramento e descontinuação. Muitas das capacidades da biblioteca são ditadas pelas regras do regulador, por exemplo, relatórios e armazenamento de conjuntos de dados de treinamento e validação. Na prática, é um registro de todos os nossos modelos.
O sistema de desenvolvimento é destinado ao desenvolvimento visual de modelos e metodologias de validação. Os modelos desenvolvidos passam por uma validação inicial e são enviados ao sistema de execução para desempenhar suas funções de negócio. Além disso, no sistema de execução, o modelo pode ser colocado em monitoramento com o objetivo de executar periodicamente metodologias de validação para controlar seu desempenho.
O sistema possui vários tipos de nós. Alguns são destinados a se conectar a diferentes fontes de dados, enquanto outros servem para transformar os dados brutos e enriquecê-los (com anotações). Existem muitos nós para construir diferentes modelos e nós para validação. O desenvolvedor pode carregar dados de quaisquer fontes, transformá-los, filtrá-los, visualizar dados intermediários e dividi-los em partes.
A plataforma também contém módulos prontos que podem ser arrastados para a área do projeto. Todas as ações são realizadas utilizando uma interface visualizada. Na verdade, é possível resolver a tarefa sem escrever uma única linha de código.
Se as capacidades incorporadas não forem suficientes, o sistema oferece a possibilidade de criar rapidamente seus próprios módulos. Criamos um modo de desenvolvimento integrado baseado em para aqueles que estão criando novos módulos "do zero".
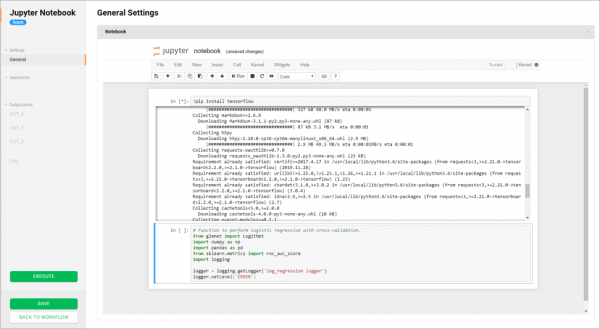
A arquitetura Sber.DS é construída em microserviços. Há muitas opiniões sobre o que são microserviços. Alguns acreditam que basta dividir um código monolítico em partes, mas ainda assim todos acessam o mesmo banco de dados. Em nosso caso, um microserviço deve se comunicar com outro microserviço apenas através de REST API. Sem caminhos alternativos de acesso direto ao banco de dados.
Nos esforçamos para que os serviços não se tornem muito grandes e pesados: uma instância não deve consumir mais de 4 a 8 gigabytes de memória RAM e deve garantir a possibilidade de escalabilidade horizontal das requisições iniciando novas instâncias. Cada serviço se comunica com os outros apenas via REST API (). A equipe responsável pelo serviço deve manter a compatibilidade retroativa da API até o último cliente que a utiliza.
O núcleo da aplicação é escrito em Java utilizando o Spring Framework. A solução foi projetada originalmente para um rápido desdobramento na infraestrutura de nuvem, portanto o aplicativo é construído utilizando um sistema de conteinerização (). A plataforma está em constante evolução, tanto no que diz respeito ao aumento da funcionalidade de negócios (novos conectores, AutoML) quanto em termos de eficiência tecnológica.
Uma das características da nossa plataforma é que podemos executar código desenvolvido na interface visual em qualquer sistema de execução de modelos do Sberbank. Atualmente, existem dois sistemas: um baseado em Hadoop e outro em OpenShift (Docker). Não paramos por aqui e estamos criando módulos de integração para implementar código em qualquer infraestrutura, incluindo on-premise e na nuvem. Em termos de capacidade de integração na ecossistema do Sberbank, também planejamos suportar o uso de ambientes de execução existentes. No futuro, a solução poderá ser facilmente integrada "pronta para uso" em qualquer infraestrutura de qualquer organização.
Aqueles que já tentaram manter uma solução que executa Python no Hadoop em PROМ sabem que não é suficiente apenas preparar e entregar o ambiente Python para cada node de dados. Um grande número de bibliotecas C/C++ para aprendizado de máquina, que utilizam módulos Python, torna impossível relaxar. É preciso lembrar de atualizar os pacotes ao adicionar novas bibliotecas ou servidores, garantindo compatibilidade com o código de modelos já implementado.
Existem várias abordagens para fazer isso. Por exemplo, preparar antecipadamente algumas das bibliotecas mais utilizadas e integrá-las no PROМ. No pacote Hadoop da Cloudera, geralmente utiliza-se . Além disso, agora o Hadoop está permitindo a execução de -containers. Em alguns casos simples, é possível entregar o código junto com o pacote .
O banco leva a segurança na execução de código de terceiros muito a sério, por isso utilizamos ao máximo os novos recursos do núcleo do Linux, onde um processo executado em um ambiente isolado , pode ser restrito, por exemplo, quanto ao acesso à rede e ao disco local, o que reduz significativamente as possibilidades de código malicioso. As áreas de dados de cada departamento são protegidas e acessíveis apenas para os proprietários desses dados. A plataforma garante que os dados de uma área só possam entrar em outra área através de um processo de publicação de dados com controle em todas as etapas, desde o acesso às fontes até a chegada dos dados na vitrine de destino.
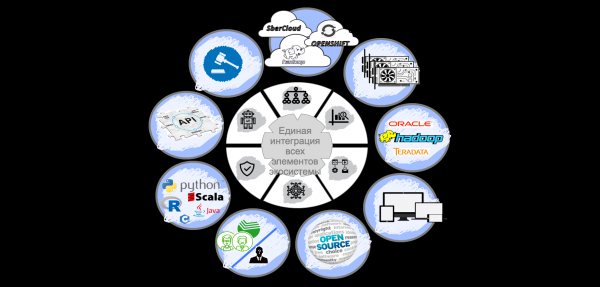
Este ano, planeamos concluir o MVP do lançamento de modelos escritos em Python/R/Java no Hadoop. Estabelecemos a ambiciosa meta de aprender a executar qualquer ambiente do usuário no Hadoop, para não limitar os usuários da nossa plataforma.
Além disso, como se revelou, muitos especialistas em DS conhecem bem matemática e estatística, criam ótimos modelos, mas não têm muita familiaridade com transformações de grandes dados, e precisam da ajuda de nossos engenheiros de dados para preparar conjuntos de dados para treinamento. Decidimos ajudar nossos colegas e criar módulos práticos para transformações padrão e preparação de recursos para modelos no mecanismo Spark. Isso permitirá dedicar mais tempo ao desenvolvimento de modelos sem esperar que os engenheiros de dados preparem um novo conjunto de dados.
Temos pessoas com conhecimentos em diversas áreas: Linux e DevOps, Hadoop e Spark, Java e Spring, Scala e Akka, OpenShift e Kubernetes. Na próxima vez, falaremos sobre a biblioteca de modelos, sobre como o modelo passa pelo ciclo de vida dentro da empresa, como ocorre a validação e a implementação.
Fonte: habr.com
