

Olá, Habr! Apresento a vocês a tradução do artigo autor Matt Klein.
Desta vez, "surgiu a vontade e consegui traduzir" a descrição de ambos os componentes da malha de serviços, plano de dados e plano de controle. Essa descrição me pareceu a mais clara e interessante, e, principalmente, conduz ao entendimento de "É realmente necessário?".
Como a ideia de "Malha de serviços (Service mesh)" se torna cada vez mais popular nos últimos dois anos (artigo original de 10 de outubro de 2017), e o número de participantes no espaço aumentou, percebi um crescimento proporcional da confusão entre toda a comunidade técnica em relação a como comparar e contrastar diferentes soluções.
A situação é melhor descrita pelas seguintes séries de tweets que escrevi em julho:
Confusão na malha de serviços (service mesh) nº 1: Linkerd ~ = Nginx ~ = Haproxy ~ = Envoy. Nenhum deles é igual ao Istio. Istio é algo completamente diferente. 1 /
Os primeiros são apenas planos de dados (data planes). Sozinhos, eles não fazem nada. Eles precisam ser configurados para algo maior. 2 /
O Istio é um exemplo de plano de controle (control plane) que conecta as partes juntas. É uma camada diferente. / fim
Nos tweets anteriores, mencionei vários projetos diferentes (Linkerd, NGINX, HAProxy, Envoy e Istio), mas, mais importante, introduzi conceitos gerais de plano de dados (data plane), malha de serviços (service mesh) e plano de controle (control plane). Neste post, farei um passo atrás e explicarei o que entendo pelos termos "plano de dados (data plane)" e "plano de controle (control plane)" em um nível muito alto, e depois explicarei como os termos se relacionam com os projetos mencionados nos tweets.
O que é uma malha de serviços (What is a service mesh, really)?
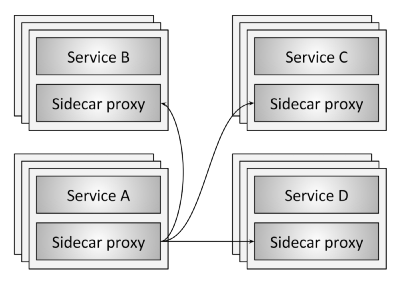
Figura 1: Visão geral da malha de serviços (Service mesh overview)
Figura 1 ilustra o conceito de malha de serviços (service mesh) no seu nível mais básico. Existem quatro clusters de serviços (A-D). Cada instância de serviço está conectada a um servidor proxy local. Todo o tráfego da rede (HTTP, REST, gRPC, Redis, etc.) de uma instância individual do aplicativo é passado através do servidor proxy local para os respectivos clusters de serviços externos. Assim, a instância do aplicativo não sabe sobre a rede como um todo e conhece apenas seu proxy local. De fato, a rede de um sistema distribuído foi abstraída do serviço.
Plano de dados (Data plane)
Na malha de serviços (service mesh), o servidor proxy localizado para o aplicativo executa as seguintes funções:
- Descoberta de serviços (Service discovery). Quais serviços/applications estão disponíveis para sua aplicação?
- Verificação de saúde (Health checking). As instâncias de serviço retornadas pela descoberta de serviços (service discovery) estão operacionais e prontas para receber tráfego de rede? Isso pode incluir verificações ativas (por exemplo, verificação de resposta / healthcheck) e passivas (por exemplo, usando 3 erros 5xx consecutivos como indicação de um estado não saudável do serviço).
- Roteamento (Routing). Recebendo uma solicitação REST para "\/foo", para qual cluster de serviço a solicitação deve ser enviada?
- Balanceamento de carga (Load balancing). Depois que um cluster de serviço foi escolhido durante o roteamento, qual instância de serviço deve receber a solicitação? Com qual timeout? Com quais configurações de interrupção de circuitos (circuit breaking)? Se a solicitação falhar, deve ser repetida?
- Autenticação e autorização (Authentication and authorization). Para solicitações de entrada, o serviço chamador pode ser criptograficamente identificado/autorizado usando mTLS ou algum outro mecanismo? Se identificado/autorizado, ele pode invocar a operação solicitada (endpoint) no serviço, ou deve ser retornada uma resposta não autenticada?
- Observabilidade (Observability). Para cada solicitação, devem ser gerados dados estatísticos detalhados, logs e dados de rastreamento distribuído, para que os operadores possam entender o fluxo de tráfego distribuído e problemas de depuração à medida que surgem.
Por todos os pontos anteriores na rede de serviços (service mesh), é responsável o plano de dados (data plane). Essencialmente, o proxy local do serviço (sidecar) é o plano de dados (data plane). Em outras palavras, o plano de dados (data plane) é responsável pela retransmissão, redireção e monitoramento de cada pacote de rede que é enviado para o serviço ou enviado dele.
O plano de controle (The control plane)
A abstração de rede fornecida pelo proxy local no plano de dados é mágica (?). No entanto, como é que o proxy realmente sabe o caminho «/foo» para o serviço B? Como os dados de descoberta de serviços, que são preenchidos pelas solicitações do proxy, podem ser utilizados? Como são configurados os parâmetros de balanceamento de carga, tempo limite (timeout), interrupção de circuito (circuit breaking) etc.? Como é feito o deployment de aplicativos usando o método azul/verde (blue/green) ou o método de transferência gradual de tráfego? Quem configura os parâmetros de autenticação e autorização do sistema em geral?
Todos os pontos acima mencionados estão sob a responsabilidade do plano de controle (control plane) da malha de serviços (service mesh). O plano de controle (control plane) aceita um conjunto de proxies isolados sem estado e os transforma em um sistema distribuído.servidores Acredito que a razão pela qual muitos tecnólogos acham confusas as ideias separadas do plano de dados (data plane) e do plano de controle (control plane) é que, para a maioria das pessoas, o plano de dados é familiar, enquanto o plano de controle é estranho/incompreensível. Já trabalhamos há muito tempo com roteadores e switches de rede físicos. Entendemos que pacotes/solicitações devem ir do ponto A ao ponto B, e o que podemos usar para isso é hardware e software. A nova geração de proxies de software é apenas versões modernas de ferramentas que usamos há muito tempo..
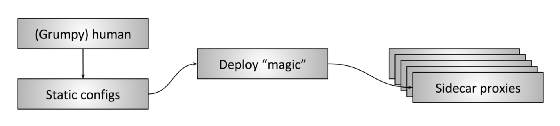
Figura 2: Plano de controle humano (Human control plane)
No entanto, já utilizamos planos de controle (control plane) há muito tempo, embora a maioria dos operadores de rede possa não conectar essa parte do sistema a qualquer componente tecnológico. A razão para isso é simples:
A maioria dos planos de controle (control plane) utilizados hoje é... nós
na figura 2.
Sobre figura 2 Mostra o que eu chamo de "Plano de Controle Humano (Human control plane)". Nesse tipo de implantação, que ainda é muito comum, um operador humano, provavelmente rabugento, cria configurações estáticas — potencialmente, com o auxílio de scripts — e as implanta através de algum processo especial em todos os servidores proxy. Em seguida, os proxies começam a utilizar essa configuração e passam a processar o plano de dados (data plane) com as configurações atualizadas.
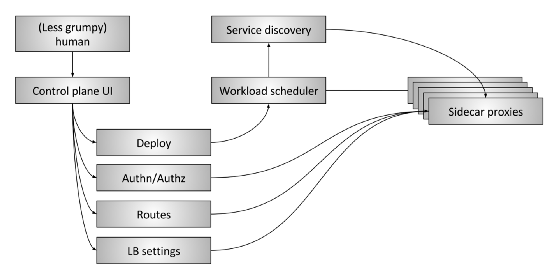
Figura 3: Plano de controle de malha de serviço avançada (Advanced service mesh control plane)
Sobre na figura 3 mostra o "plano de controle avançado" (control plane) da malha de serviço (service mesh). Ele consiste nas seguintes partes:
- O humano (The human): Ainda há um humano (tomara que menos irritado), que toma decisões de alto nível em relação a todo o sistema como um todo.
- Interface do plano de controle (Control plane UI): O humano interage com algum tipo de interface de usuário para gerenciar o sistema. Isso pode ser um portal web, uma aplicação de linha de comando (CLI) ou algum outro interface. Através da interface, o operador tem acesso a configurações globais do sistema, como:
- Gerenciamento de implantações, blue/green e/ou transição gradual de tráfego
- Configurações de autenticação e autorização
- Especificações da tabela de roteamento, por exemplo, quando o aplicativo A solicita informações sobre "/foo", o que acontece
- Configurações do balanceador de carga, como timeouts, retries, circuit breaking etc.
- Agendador de carga de trabalho (Workload scheduler): Os serviços são iniciados na infraestrutura através de um sistema de agendamento/orquestração de determinado tipo, como Kubernetes ou Nomad. O agendador é responsável por carregar o serviço junto com seu proxy local.
- Descoberta de serviço (Service discovery). Quando o agendador inicia e para instâncias de serviço, ele reporta seu estado de saúde para o sistema de descoberta de serviço.
- APIs de configuração do proxy local (Sidecar proxy configuration APIs) : Os proxies locais extraem dinamicamente o estado de vários componentes do sistema com base no modelo de «consistência eventual» sem a intervenção do operador. Todo o sistema, composto por todas as instâncias de serviços em execução e proxies locais, converge em um único ecossistema. A API do plano de dados (data plane) universal no Envoy é um dos exemplos de como isso funciona na prática.
Essencialmente, o objetivo do plano de controle (control plane) é estabelecer políticas que, em última instância, serão adotadas pelo plano de dados (data plane). Planos de controle mais avançados removerão mais detalhes de certos sistemas do operador e exigirã menos gerenciamento manual, desde que funcionem corretamente!..
O plano de dados e o plano de controle. Resumo (Data plane vs. control plane summary)
- O plano de dados da malha de serviços (Service mesh data plane): abrange cada pacote / solicitação no sistema. É responsável pela descoberta de aplicativos / serviços, verificação de integridade, roteamento, balanceamento de carga, autenticação / autorização e observabilidade.
- O plano de controle da malha de serviços (Service mesh control plane): fornece política e configuração para todos os planos de dados em operação dentro da malha de serviços. Não toca em nenhum pacote / solicitação no sistema. O plano de controle transforma todos os planos de dados em um sistema distribuído.
Estado atual do projeto (Current project landscape)
Depois de entender a explicação acima, vamos dar uma olhada no estado atual do projeto de malha de serviços (service mesh).
- Planos de dados (Data planes): Linkerd, NGINX, HAProxy, Envoy, Traefik
- Planos de controle (Control planes): Istio, Nelson, SmartStack
Em vez de realizar uma análise aprofundada de cada uma das soluções mencionadas acima, vou abordar brevemente alguns pontos que, na minha opinião, geram a maior parte da confusão no ecossistema atualmente.
No início de 2016, o Linkerd foi um dos primeiros proxies de plano de dados para redes de serviço e fez um trabalho fantástico em aumentar a conscientização e o interesse pelo modelo de design de 'rede de serviços'. Aproximadamente seis meses depois, o Envoy se juntou ao Linkerd (embora já estivesse trabalhando na Lyft desde o final de 2015). Linkerd e Envoy são os dois projetos mais frequentemente mencionados nas discussões sobre redes de serviço.
O Istio foi anunciado em maio de 2017. Os objetivos do projeto Istio são bastante semelhantes à camada de controle ampliada mostrada em na figura 3. O Envoy é o proxy 'padrão' para o Istio. Assim, o Istio é a camada de controle, enquanto o Envoy é o plano de dados. Em pouco tempo, o Istio gerou muita comoção, e outras camadas de dados começaram a ser integradas como substitutas do Envoy (tanto o Linkerd quanto o NGINX demonstraram integração com o Istio). O fato de que diferentes planos de dados podem ser usados em uma única camada de controle significa que a camada de controle e o plano de dados não precisam estar intimamente relacionados. Uma API como a API universal do plano de dados do Envoy pode formar uma ponte entre as duas partes do sistema.
Nelson e SmartStack ajudam a ilustrar ainda mais a separação entre a camada de controle e o plano de dados. O Nelson utiliza o Envoy como seu proxy e constrói uma camada de controle robusta para a rede de serviços com base na pilha HashiCorp, ou seja, Nomad, etc. O SmartStack talvez tenha sido o primeiro de uma nova onda de redes de serviço. O SmartStack forma a camada de controle ao redor do HAProxy ou NGINX, demonstrando a possibilidade de desacoplar a camada de controle da rede de serviços e o plano de dados.
A arquitetura de microsserviços com rede de serviços (service mesh) está atraindo cada vez mais atenção (certo!) e cada vez mais projetos e fornecedores começam a trabalhar nessa direção. Nos próximos anos, veremos muitas inovações tanto nas camadas de dados (data plane) quanto nas camadas de controle (control plane), além de uma maior mistura de diferentes componentes. No final, a arquitetura de microsserviços deve se tornar mais transparente e mágica (?) para o operador.
Espero que todos estejam cada vez menos irritados.
Principais pontos (Key takeaways)
- A rede de serviços (service mesh) é composta por duas partes diferentes: a camada de dados (data plane) e a camada de controle (control plane). Ambos os componentes são essenciais, e sem eles, o sistema não funcionará.
- Todos estão familiarizados com a camada de controle (control plane), e neste momento, a camada de controle (control plane) pode ser você!
- Todas as camadas de dados (data plane) competem entre si em termos de funcionalidades, desempenho, configurabilidade e escalabilidade.
- Todas as camadas de controle (control plane) competem entre si em termos de funcionalidades, configurabilidade, escalabilidade e facilidade de uso.
- Uma camada de controle (control plane) pode conter as abstrações e APIs corretas para que várias camadas de dados (data plane) possam ser usadas.
Fonte: habr.com
