

O diretor de operações do portal Banki.ru, Andrey Nikolsky, falou na conferência do ano passado sobre serviços órfãos: como identificar um órfão na infraestrutura, quais são os problemas dos serviços órfãos, o que fazer com eles, e como proceder se nada funcionar.
Abaixo, você encontrará a versão em texto da apresentação.
Olá, colegas! Meu nome é Andrey, sou responsável pela operação na empresa Banki.ru.
Temos grandes serviços, são serviços monolíticos, há serviços no entendimento mais clássico e também serviços muito pequenos. Em minha terminologia de trabalho, costumo dizer que, se um serviço é simples e pequeno, é um microserviço; se não é muito simples e nem pequeno, é apenas um serviço.
Vantagens dos serviços
Vou passar rapidamente pelas vantagens dos serviços.
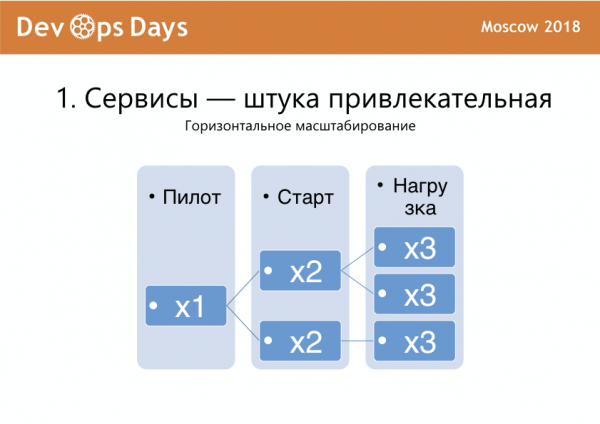
Primeiro — escalabilidade. Você pode rapidamente fazer algo em um serviço e levar para produção. Se você recebe tráfego, clona o serviço. Se mais tráfego chega, clona novamente e vive com isso. Isso é um bom bônus e, na verdade, quando começamos, era considerado o mais importante, a razão pela qual estamos fazendo tudo isso.
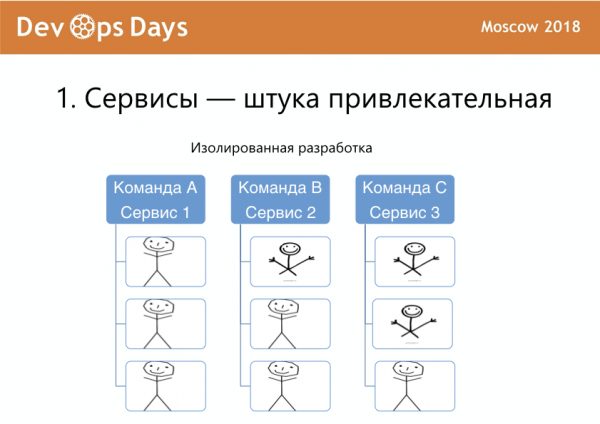
Em segundo lugar, desenvolvimento isolado, onde você tem várias equipes de desenvolvimento, diferentes desenvolvedores em cada equipe, e cada equipe trabalha em seu próprio serviço.
Com as equipes, surgem nuances. Os desenvolvedores são diferentes. E existem, por exemplo, . Eu vi isso pela primeira vez com Maxim Dorofeev. Às vezes, pessoas-neve estão em algumas equipes, mas em outras não. Isso torna os diferentes serviços utilizados na empresa um pouco desiguais.
Olhe para a imagem: este é um bom desenvolvedor, ele tem grandes mãos e pode fazer muita coisa. O principal problema é de onde vêm essas mãos.
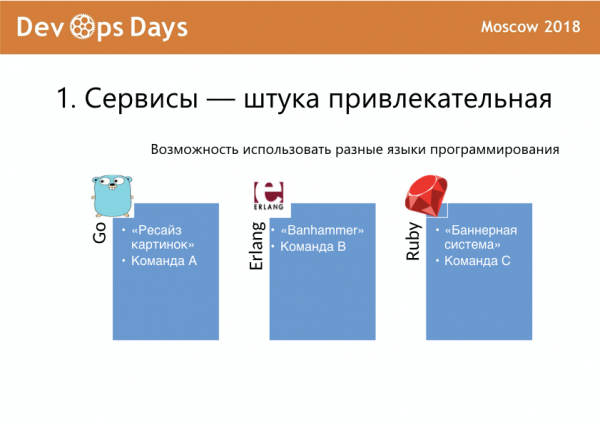
Os serviços permitem o uso de diferentes linguagens de programação, mais adequadas para várias tarefas. Algum serviço em Go, algum em Erlang, algum em Ruby, algo em PHP, algo em Python. Em geral, é possível se expandir bastante. Aqui também há nuances.
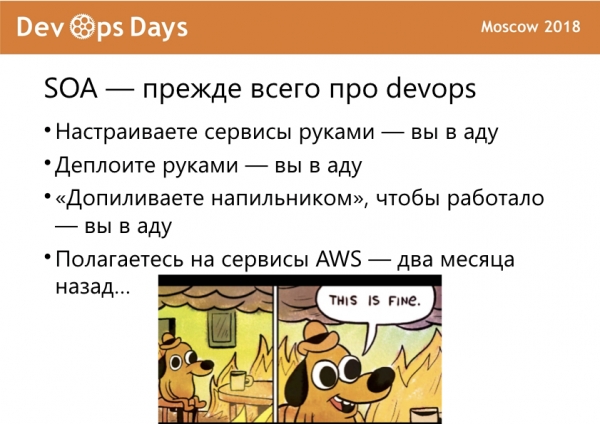
A arquitetura orientada a serviços é, acima de tudo, sobre devops. Ou seja, se você não tem automação, não tem processo de deployment, se você configura manualmente, suas configurações podem mudar de instância de serviço para instância, e você precisa entrar lá para fazer algo, então você está no inferno.
Por exemplo, se você tem 20 serviços e precisa fazer o deploy manualmente, você tem 20 consoles e ao mesmo tempo pressiona ‘enter’, como um ninja. Isso não é muito bom.
Se você tem um serviço após os testes (se houver testes, claro), e precisa ainda de um ajuste fino para que funcione em produção, eu também tenho más notícias para você.
Se você depende de serviços específicos da Amazon e está trabalhando na Rússia, há dois meses você também estava dizendo ‘Tudo está pegando fogo, estou bem, tudo ótimo’.
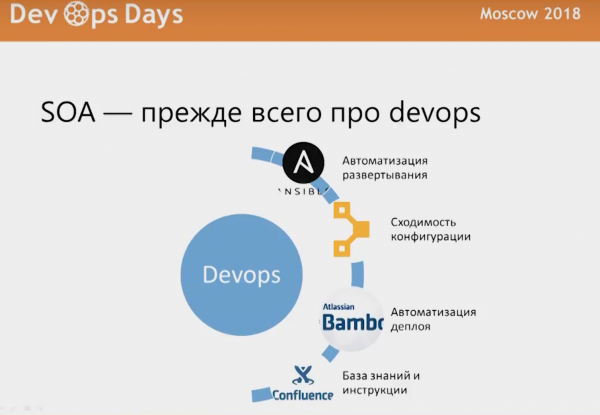
Usamos o Ansible para automatizar o deployment, Puppet para convergência, Bamboo para automatização do deploy e Confluence para descrever tudo isso de alguma forma.
Não vou me aprofundar nisso, pois a apresentação é mais sobre práticas de interação do que sobre implementação técnica.
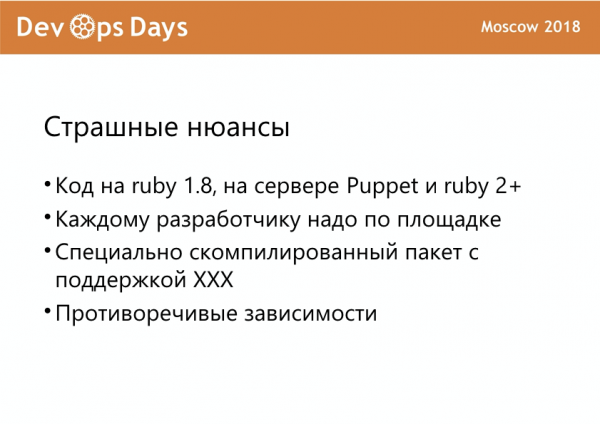
Já tivemos, por exemplo, problemas onde o Puppet no servidor funciona com Ruby 2, enquanto alguma aplicação foi escrita para Ruby 1.8, e eles não funcionam juntos. Acontece um erro qualquer. E quando você precisa manter várias versões do Ruby em uma mesma máquina, geralmente começam os problemas.
Por exemplo, para cada desenvolvedor, fornecemos um ambiente que tem praticamente tudo que temos, todos os serviços que podem ser desenvolvidos, para que ele tenha um ambiente isolado onde pode quebrar e construir como quiser.
Às vezes, é necessário um pacote especialmente compilado com suporte para algo específico. Isso é bastante rigoroso. Ouvi uma apresentação onde a imagem do Docker pesa 45 GB. No Linux, claro, é um pouco mais simples, tudo é menor, mas ainda assim, não há espaço suficiente.
Além disso, há dependências conflitantes, quando uma parte do projeto depende de uma versão de biblioteca, e outra parte do projeto depende de outra versão, e as bibliotecas não podem ser instaladas juntas de forma alguma.
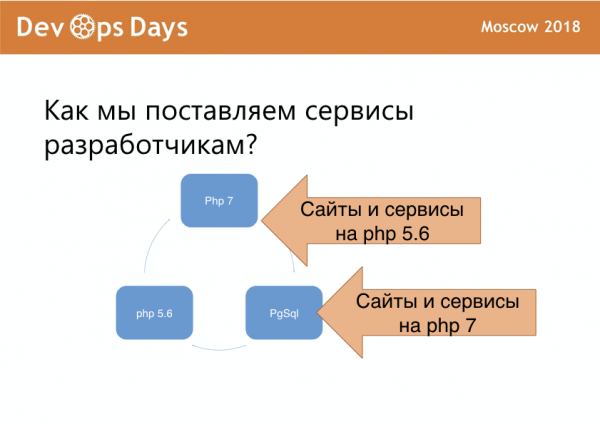
Temos sites e serviços em PHP 5.6, estamos envergonhados por isso, mas o que fazer? É uma de nossas plataformas. Existem sites e serviços em PHP 7, estes são mais numerosos, não nos envergonhamos deles. E cada desenvolvedor tem seu próprio banco de dados, onde ele se diverte programando.
Se você está programando na empresa em uma única linguagem, ter três máquinas virtuais por desenvolvedor parece normal. Se você tem diferentes linguagens de programação, a situação piora.
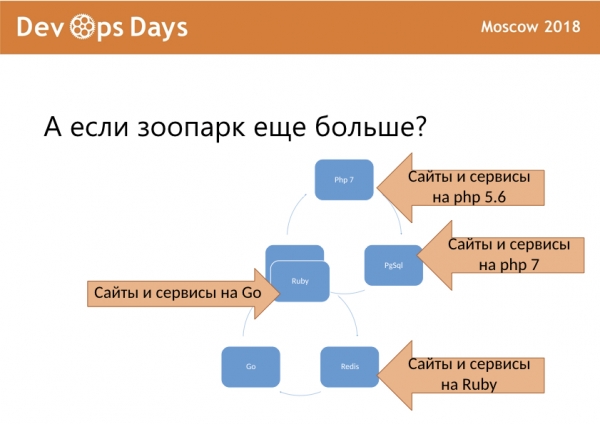
Você tem sites e serviços aqui, e aqui, depois mais uma plataforma para Go, uma plataforma para Ruby, e algum Redis ao lado. No final, tudo isso se transforma em um grande campo de suporte, onde algo pode quebrar a qualquer momento.
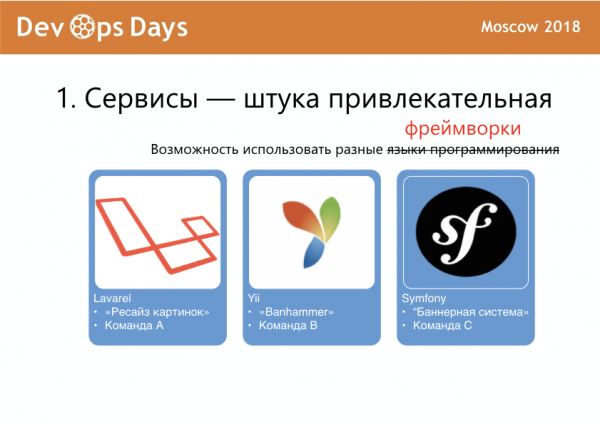
Por isso, substituímos os recursos da linguagem de programação pelo uso de diferentes frameworks, uma vez que os frameworks em PHP são bastante variados, possuem diferentes capacidades, comunidades distintas e suportes diversos. Assim, é possível criar serviços já com algo pronto para eles.
Cada serviço tem sua própria equipe
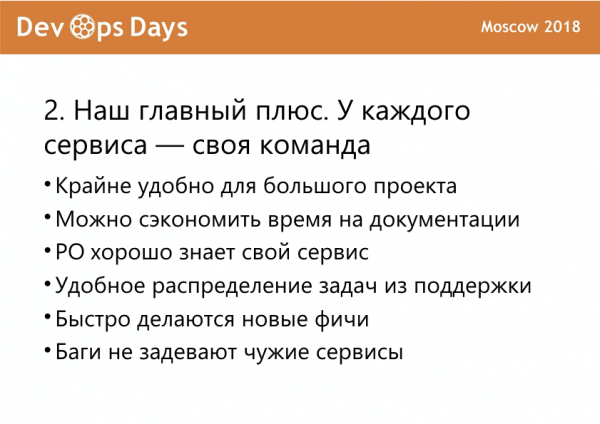
Nossa principal vantagem, que se cristalizou ao longo dos anos, é que cada serviço possui sua própria equipe. Isso é conveniente para grandes projetos, pois economiza tempo com documentação e os gerentes conhecem bem seus projetos.
As tarefas de suporte podem ser facilmente delegadas. Por exemplo, se um serviço de seguros falhar, a equipe que cuida do seguro imediatamente se junta para consertá-lo.
Novos recursos são desenvolvidos rapidamente, porque quando você tem um serviço atômico, é possível implementar algo novo de forma ágil.
E quando você quebra seu serviço, o que inevitavelmente acontece, você não afeta outros serviços, e os desenvolvedores de outras equipes não vêm até você com paus e dizem: 'Ei, não faça isso'.
Como sempre, existem nuances. Temos equipes estáveis, e os gerentes estão firmemente ligados às equipes. Existem documentos claros, e os gerentes supervisionam tudo de perto. Cada gerente tem várias equipes sob sua responsabilidade, e há um ponto de competência específico.
Se as equipes são flutuantes (o que também acontece às vezes), existe um bom método chamado 'mapa estelar'.
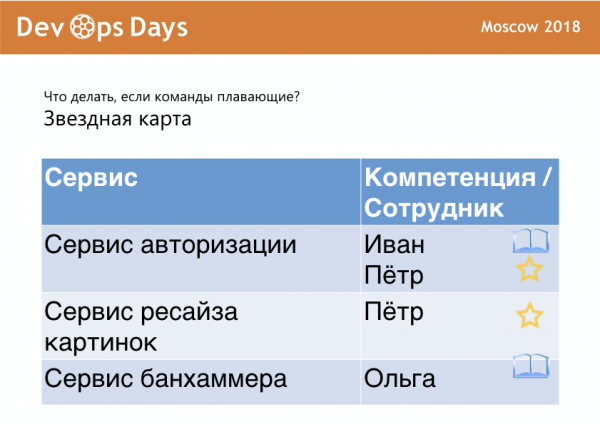
Você tem uma lista de serviços e pessoas. A estrela indica que a pessoa é uma especialista naquele serviço, enquanto o livro indica que a pessoa está estudando o serviço. A tarefa da pessoa é trocar o livro pela estrela. E se não houver nada escrito ao lado do serviço, começam os problemas, sobre os quais falarei em seguida.
Como surgem serviços órfãos?
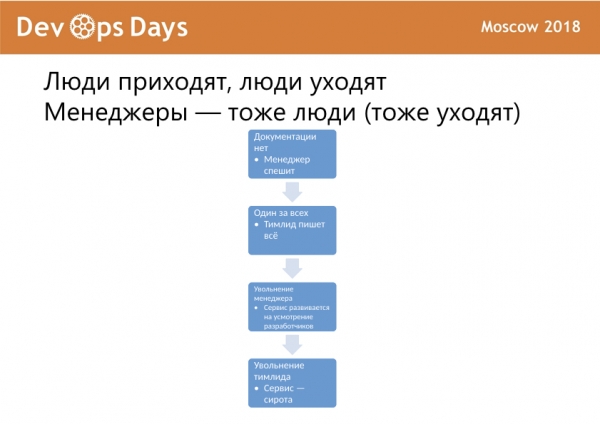
O primeiro problema, a primeira maneira de ter um serviço órfão em sua infraestrutura é a demissão de pessoas. Alguém já passou por isso, quando prazos chegam no negócio antes que as tarefas sejam avaliadas? Às vezes, os prazos são apertados e simplesmente não há tempo para a documentação. "Precisamos entregar o serviço em produção, depois escribemos mais."
Se a equipe é pequena, pode haver apenas um desenvolvedor escrevendo tudo, enquanto os outros apoiam. "Eu escrevi a arquitetura principal, você pode criar as interfaces." Depois, em algum momento, o gerente pode sair. E nesse período, enquanto o gerente saiu e nenhum novo foi designado, os desenvolvedores decidem por conta própria para onde o serviço está indo, o que está acontecendo. E como sabemos (vamos voltar alguns slides), em algumas equipes há pessoas especiais, às vezes um desses leads. Então ele se demite, e obtemos um serviço órfão.
Enquanto isso, as tarefas de suporte e de negócios não desaparecem, elas se acumulam no backlog. Se durante o desenvolvimento do serviço houveram algum erro arquitetônico, eles também se acumulam no backlog. O serviço vai lentamente degradando.
Como identificar um órfão?
Essa lista descreve bem a situação. Quem se identificou com algo em sua infraestrutura?
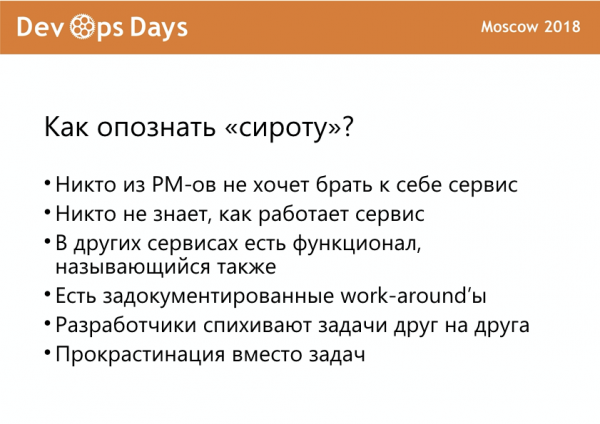
Sobre as soluções documentadas: temos um serviço e, no geral, ele funciona, possui um manual de duas páginas sobre como usá-lo, mas como ele funciona internamente, ninguém sabe.
Ou, por exemplo, temos um encurtador de links. No nosso caso, agora temos três encurtadores de links para diferentes fins em diferentes serviços. Essas são consequências.
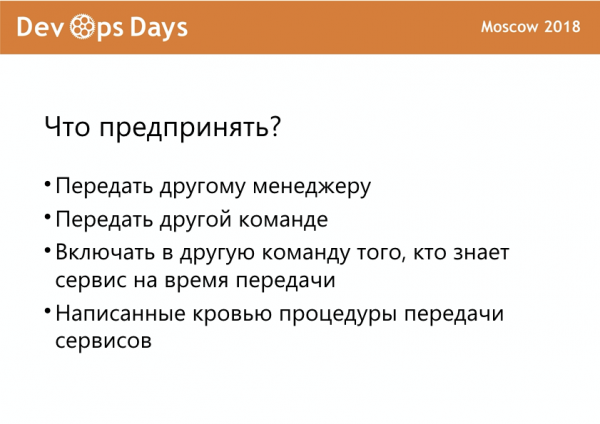
Agora vou ser o capitão óbvio. O que deve ser feito? Primeiro, o serviço deve ser passado para outro gerente, outra equipe. Se seu líder ainda não se demitiu, você deve incluir alguém que entenda um pouco do serviço na nova equipe quando perceber que ele está se tornando um órfão.
A principal coisa: você deve ter procedimentos de transferência escritos claramente. No nosso caso, geralmente sou eu que supervisiono isso, porque preciso que tudo funcione. Para os gerentes, é importante que seja entregue rapidamente, e o que acontecer depois já não é tão relevante para eles.
A próxima maneira de criar um serviço sem dono é: 'Vamos terceirizar, assim será mais rápido, e depois passaremos para a equipe'. É claro que todos têm algum planejamento na equipe, uma fila de espera. Muitas vezes, o cliente empresarial pensa que os terceirizados farão exatamente como o departamento técnico da empresa. No entanto, seus motivadores são diferentes. Na terceirização, podemos encontrar soluções tecnológicas estranhas e algoritmos incomuns.
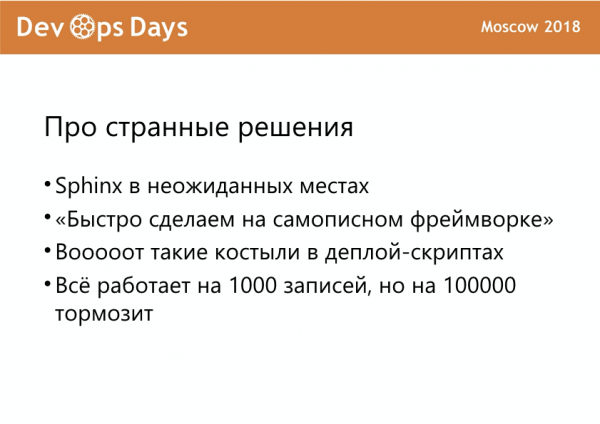
Por exemplo, tivemos um serviço onde o Sphinx estava em lugares inesperados. Vou contar mais sobre o que tivemos que fazer mais adiante.
Os terceirizados costumam ter frameworks próprios. É simplesmente PHP puro com cópia e colagem de projetos anteriores, onde você pode encontrar de tudo. Há grandes gambiarras nos scripts de deploy, quando você precisa modificar algumas linhas em um arquivo usando scripts Bash complexos, e esses scripts de deploy são chamados por algum terceiro. No final, você altera o sistema de deploy, escolhe outra coisa e, de repente, seu serviço para de funcionar. Porque precisávamos colocar mais 8 links entre diferentes pastas. Ou ocorre que mil registros funcionam, mas cem mil já não funcionam.
Continuarei no comando. A aceitação de um serviço terceirizado é um procedimento obrigatório. Alguém já passou pela situação em que um serviço terceirizado chega, mas não é aceito? Isso não é tão comum quanto um serviço sem dono, mas ainda assim.
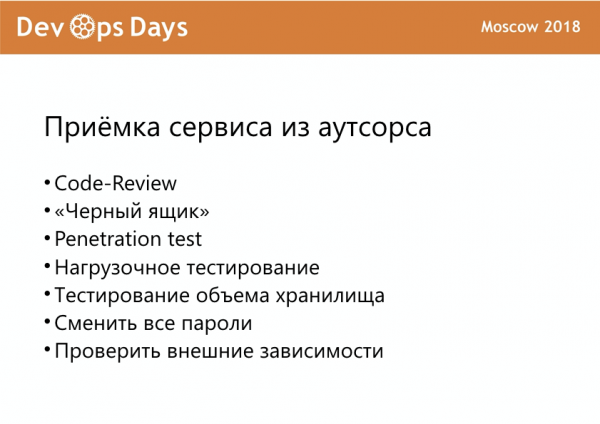
É necessário verificar o serviço, revisá-lo e mudar as senhas. Tivemos um caso em que nos entregaram um serviço com uma administração que tinha 'if login == ‘admin’ && password == ‘admin’…', claramente escrito no código. Nós nos perguntamos, e isso é escrito por pessoas em 2018?
Testar o volume de armazenamento também é essencial. É necessário observar o que acontecerá com cem mil registros antes de você colocar esse serviço em produção.
Não deve ser vergonhoso enviar um serviço para rework. Quando você diz: 'Não aceitaremos esse serviço, temos 20 tarefas, façam-nas, então aceitaremos', isso é normal. A consciência não deve pesar porque você colocará o gerente em uma situação difícil ou porque a empresa gastará dinheiro. Depois, a empresa gastará ainda mais.
Tivemos um caso em que decidimos realizar um projeto piloto terceirizado.
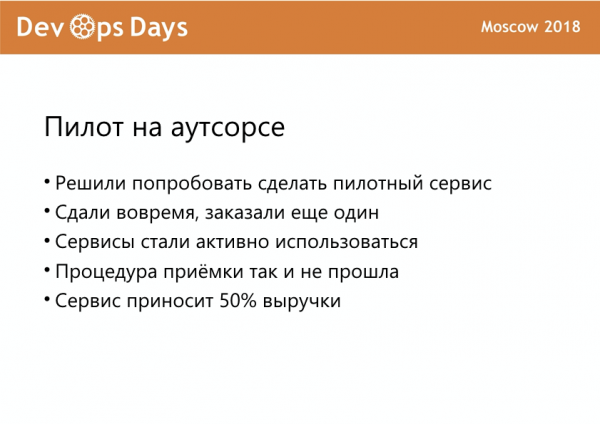
Ele foi entregue a tempo, e esse foi o único critério de qualidade. Portanto, fizeram mais um projeto piloto, já nem totalmente piloto. Esses serviços foram aceitos, de maneira administrativa disseram, aqui está o seu código, aqui está a equipe, aqui está o seu gerente. Os serviços realmente começaram a gerar lucro. No entanto, na prática, eles ainda permanecem órfãos, ninguém entende como funcionam, e os gerentes se afastam de suas tarefas.
Há também um conceito excelente — desenvolvimento clandestino. Quando algum departamento, normalmente o de marketing, quer testar uma hipótese e encomenda o serviço inteiro por outsourcing. Começa a receber tráfego, eles fecham documentos, assinam contratos com o prestador, entra em operação e dizem: ‘Pessoal, temos um serviço aqui, já está recebendo tráfego, ele nos traz dinheiro, vamos aceitá-lo’. Nós ficamos: ‘Opa, como assim?’.
E mais uma maneira de obter um serviço órfão: quando alguma equipe de repente fica sobrecarregada, a gerência diz: ‘Vamos passar o serviço dessa equipe para outra equipe, que está com menos carga de trabalho’. E depois passamos para uma terceira equipe e mudamos o gerente. E no final, temos novamente um órfão.
Qual é o problema com os órfãos?
Quem não sabe, este é o navio de guerra Wasa, lançado na Suécia, famoso por ter afundado cinco minutos após ser botado na água. E o rei da Suécia, aliás, não puniu ninguém por isso. Foi construído por duas gerações de engenheiros que não sabiam construir tais navios. Um efeito previsível.
O navio poderia ter afundado, aliás, de forma muito pior, por exemplo, quando o rei já estivesse a bordo indo para algum lugar em uma tempestade. Mas assim, afundou logo, de acordo com o ágil isso é bom — falhar cedo.
Se falhamos cedo, geralmente não há problemas. Por exemplo, durante a aceitação, foi enviado para melhorias. Mas se falhamos já na produção, quando o dinheiro foi investido, podem haver problemas. Consequências, como são chamadas nos negócios.
Quais são os perigos dos serviços órfãos:
- O serviço pode quebrar inesperadamente.
- O serviço demora a ser consertado ou não é consertado de forma alguma.
- Problemas de segurança.
- Problemas com melhorias e atualizações.
- Se um serviço importante quebra, a reputação da empresa sofre.
O que fazer com os serviços órfãos?
Devo repetir que é isso que se deve fazer. Primeiro, deve haver documentação. Sete anos no Banki.ru me ensinaram que os testers não devem acreditar no que os desenvolvedores dizem e que a operação não deve confiar na palavra de ninguém. É preciso verificar.
Em segundo lugar, é necessário escrever esquemas de interação, porque pode acontecer que os serviços, que não foram muito bem aceitos, contêm dependências das quais ninguém falou. Por exemplo, os desenvolvedores conectaram o serviço à sua chave de algum serviço como Yandex.Maps ou Dadata. Seu limite gratuito acabou, tudo quebrou e você não sabe o que aconteceu. Todas essas armadilhas devem ser descritas: o serviço utiliza Dadata, Sms, algo mais.
Em terceiro lugar, o trabalho com a dívida técnica. Quando você faz alguns improvisos ou aceita um serviço e diz que algo precisa ser feito, deve-se acompanhar para garantir que seja feito. Porque depois pode acontecer que um pequeno problema não seja tão pequeno e você acabe caindo nele.
Tivemos uma história sobre tarefas de arquitetura relacionada ao Sphinx. Em um dos serviços, o Sphinx era usado para inserir listas. Apenas uma lista com paginação, mas ao mesmo tempo ela era reindexada toda noite. Era composta por dois índices: um indexado à noite e um pequeno índice que era acoplado a ele. Todo dia, com 50% de chance, ou funcionava ou não, ao fazer a atualização o índice quebrava e as notícias paravam de ser atualizadas na página principal. No começo, isso levava 5 minutos, enquanto o índice era reindexado, depois cresceu, e em algum momento começou a levar 40 minutos. Quando eliminamos isso, respiramos aliviados, porque ficou claro que, se continuasse assim, teríamos um índice sendo reindexado durante todo o horário de trabalho. Isso seria um fracasso para nosso portal, oito horas sem notícias — tudo, o negócio parou.
Plano de trabalho com o serviço órfão
Na verdade, é muito difícil fazer isso, porque DevOps é sobre comunicação. Quero ter boas relações com meus colegas, mas quando você bate com regulamentos na cabeça dos colegas e gerentes, eles podem ter sentimentos contraditórios em relação às pessoas que fazem isso.
Além de todos esses pontos, há uma coisa importante: para cada serviço específico, para cada parte do processo de implantação, devem haver pessoas específicas responsáveis. Quando não há pessoas e você precisa envolver outras pessoas, estudar tudo isso, fica difícil.
Se tudo isso não ajudou, e o seu serviço órfão ainda é um órfão, ninguém quer assumir, a documentação não é escrita e a equipe convocada para esse serviço se recusa a fazer algo, há uma maneira simples — refazer tudo.
Ou seja, você pega os requisitos do serviço novamente e escreve um novo serviço, melhor, em uma plataforma superior, sem soluções tecnológicas estranhas. E migra para ele em produção.
Tivemos uma situação em que pegamos um serviço em Yii 1 e percebemos que não podíamos mais desenvolvê-lo, pois não tínhamos desenvolvedores que soubessem programar bem em Yii 1. Todos os desenvolvedores eram proficientes em Symfony 3. O que fazer? Reservamos tempo, formamos uma equipe, designamos um gerente, reescrevemos o projeto e transferimos o tráfego suavemente.
Depois disso, o antigo serviço pode ser eliminado. Este é meu procedimento favorito, quando precisamos limpar um serviço do sistema de gerenciamento de configurações e depois verificar se todas as instâncias em produção foram desativadas, para que não restem vestígios para os desenvolvedores. O repositório no Git permanece.
Era tudo o que eu queria compartilhar, estou pronto para discutir, é um tema polêmico, muitos têm suas opiniões.
Nos slides, falamos sobre unificar linguagens. Um exemplo foi o redimensionamento de imagens. Mas é realmente necessário padronizar para uma única linguagem? Porque o redimensionamento de imagens em PHP, realmente poderia ter sido feito em Golang.
Na verdade, isso não é obrigatório, assim como todas as práticas. Pode ser que, em alguns casos, até seja indesejável. Mas é preciso entender que se na sua empresa há 50 pessoas no departamento técnico, das quais 45 são programadores PHP, mais 3 são devops que manjam de Python, Ansible, Puppet e coisas desse tipo, e apenas um deles desenvolve um serviço em Go para redimensionar imagens, então quando ele sai, a expertise vai junto. Além disso, você precisará procurar um desenvolvedor no mercado que conheça essa linguagem, especialmente se for algo raro. Ou seja, do ponto de vista organizacional, isso é problemático. Do ponto de vista do devops, você não precisará apenas clonar um conjunto pronto de playbooks que você usa para implantar serviços, mas terá que escrevê-los do zero.
Atualmente, estamos desenvolvendo um serviço em Node.js, e isso será uma plataforma adjacente para cada desenvolvedor com uma linguagem separada. Mas pensamos e decidimos que vale a pena. Ou seja, a questão é realmente sentar e refletir sobre isso.
Como você monitora seus serviços? Como coleta e rastreia logs?
Nós coletamos logs no Elasticsearch e os armazenamos no Kibana, e dependendo se é um ambiente de produção ou de teste, utilizamos coletores diferentes. Em alguns lugares, usamos Lumberjack, em outros, não lembro mais. E também há certos lugares em serviços específicos onde colocamos Telegraf e enviamos os dados para outro lugar separado.
Como conviver com Puppet e Ansible em um mesmo ambiente?
Na verdade, temos atualmente dois ambientes, um com Puppet, outro com Ansible. Estamos trabalhando para hibridizá-los. Ansible é um bom ambiente para a configuração inicial, Puppet é uma solução ruim para configuração inicial, pois requer trabalho manual diretamente na plataforma, e Puppet garante a convergência da configuração. Isso significa que a plataforma se auto-mantém atualizada, enquanto para que uma máquina gerenciada por Ansible permaneça atualizada, é preciso sempre executar playbooks nela com alguma periodicidade. Essa é a diferença.
Como você mantém a compatibilidade? Você tem configurações tanto no Ansible quanto no Puppet?
Esta é uma grande dor para nós, estamos lidando com a compatibilidade de forma manual e pensando em como migrar tudo isso. O Puppeteer instala pacotes e mantém algumas referências, enquanto o Ansible, por exemplo, implementa código e ajusta as configurações frescas das aplicações.
Na apresentação, falamos sobre diferentes versões do Ruby. Qual é a solução?
Enfrentamos isso em um determinado ponto e precisamos manter isso em mente o tempo todo. Simplesmente desativamos a parte que estava rodando a versão do Ruby que não era compatível com as aplicações e a mantivemos separada.
Neste ano, a conferência ocorrerá em 7 de dezembro no 'Tecnopólis'. Até 11 de novembro, estamos aceitando propostas para palestras. nós, se você quiser se apresentar.
As inscrições para os participantes estão abertas, junte-se a nós!
Fonte: habr.com
