

Introdução filosófica
Como é sabido, existem apenas dois métodos para resolver problemas:
- Método de análise ou método de dedução, ou do geral para o específico.
- Método de síntese ou método de indução, ou do específico para o geral.
Para resolver o problema de "melhorar o desempenho do banco de dados", isso pode parecer assim.
Análise — dividimos o problema em partes separadas e, ao resolvê-las, tentamos melhorar o desempenho do banco de dados como um todo.
Na prática, a análise se parece com isso:
- Surge um problema (incidente de desempenho)
- Coletamos informações estatísticas sobre o estado do banco de dados
- Buscamos gargalos (bottlenecks)
- Resolvemos problemas nos gargalos
Gargalos do banco de dados — infraestrutura (CPU, Memória, Discos, Rede, OS), configurações (postgresql.conf), consultas:
Infraestrutura: possibilidades de influência e alteração para o engenheiro — quase nulas.
Configurações do banco de dados: possibilidades de alterações um pouco maiores que no caso anterior, mas geralmente ainda bastante difíceis, especialmente em nuvens.
Consultas ao banco de dados: a única área para manobras.
Síntese — melhoramos o desempenho de partes individuais, esperando que, assim, o desempenho geral do banco de dados melhore.
Introdução lírica ou por que tudo isso é necessário
Como ocorre o processo de resolução de incidentes de desempenho, se o desempenho do banco de dados não é monitorado:
Cliente - "está tudo ruim, lento, façam-nos bem"
Engenheiro - "ruim isso como?"
Cliente – "assim como agora (uma hora atrás, ontem, na última vez estava), lento"
Engenheiro – "e quando estava bom?"
Cliente – "uma semana (duas semanas) atrás estava razoável." (Isso foi sorte)
Cliente – "não me lembro de quando estava bom, mas agora está ruim" (Resposta comum)
No final, obtemos um quadro clássico:
Quem é o culpado e o que fazer?
A primeira parte da pergunta é a mais fácil de responder — o culpado é sempre o engenheiro DBA.
A segunda parte também não é muito difícil de responder — é necessário implementar um sistema de monitoramento de desempenho do banco de dados.
Surge a primeira questão — o que monitorar?
Caminho 1. Vamos monitorar TUDO
Carga de CPU, o número de operações de leitura/gravação no disco, o tamanho da memória alocada e uma tonelada de diferentes contadores que qualquer sistema de monitoramento razoável pode fornecer.
O resultado é uma série de gráficos, tabelas resumidas e avisos contínuos por e-mail, além de 100% de ocupação do engenheiro resolvendo uma infinidade de tickets idênticos, geralmente com a mesma informação padrão — “Problema temporário. Nenhuma ação necessária”. No entanto, todos estão ocupados e sempre há algo para mostrar ao cliente — o trabalho está em andamento.
Caminho 2. Monitorar apenas o que é necessário, e o que não é necessário, não deve ser monitorado.
Pode-se monitorar, um pouco diferente — apenas entidades e eventos:
- Sobre os quais o engenheiro DBA pode ter influência.
- Para os quais existe um algoritmo de ação quando ocorre um evento ou uma alteração de entidade.
A partir dessa suposição e lembrando do “Introdução filosófica” para evitar a repetição regular de “Introdução lírica ou por que tudo isso é necessário” será razoável monitorar o desempenho de consultas específicas, para otimização e análise, o que no final deve levar a uma melhora na performance de todo o banco de dados.
Mas, para melhorar uma consulta pesada que afeta a performance geral do banco de dados, primeiro é preciso encontrá-la.
Assim, surgem duas questões interligadas:
- qual consulta é considerada pesada
- como buscar consultas pesadas.
Evidentemente, uma consulta pesada é aquela que utiliza muitos recursos do sistema operacional para obter um resultado.
Passamos para a segunda questão — como buscar e, em seguida, monitorar consultas pesadas?
Quais são as opções para monitorar consultas no PostgreSQL?
Comparado ao Oracle, as opções são limitadas, mas ainda assim, é possível fazer algo.
PG_STAT_STATEMENTS
Para encontrar e monitorar consultas pesadas no PostgreSQL, existe a extensão padrão pg_stat_statements.
Após a instalação da extensão, uma visão homônima aparece no banco de dados alvo, que deve ser usada para propósitos de monitoramento.
As colunas alvo pg_stat_statements para construir um sistema de monitoramento:
- queryid Um código hash interno calculado a partir da árvore de análise do operador.
- max_time O tempo máximo gasto na operação, em milissegundos.
Ao acumular e usar estatísticas dessas duas colunas, é possível construir um sistema de monitoramento.
Como o pg_stat_statements é utilizado para monitorar o desempenho do PostgreSQL.
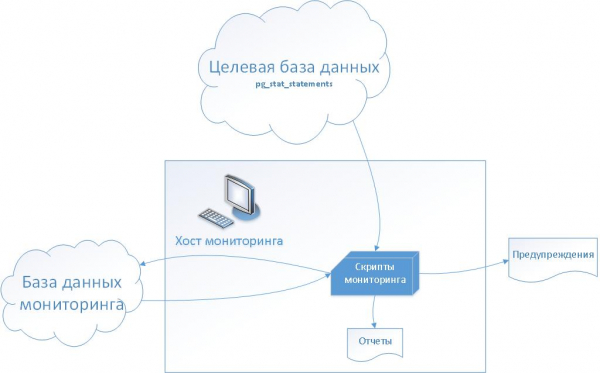
Para monitorar o desempenho das consultas, é utilizado:
No lado do banco de dados de destino — a visualização pg_stat_statements
Do lado servidor e do banco de dados de monitoramento — um conjunto de scripts bash e tabelas de serviço.
Etapa 1 — coleta de dados estatísticos
No host de monitoramento, um script é executado regularmente via cron, que copia o conteúdo da visualização pg_stat_statements do banco de dados de destino para a tabela pg_stat_history no banco de dados de monitoramento.
Dessa forma, é formada a história da execução de consultas individuais, que pode ser utilizada para gerar relatórios de desempenho e ajustar métricas.
Etapa 2 — configuração das métricas de desempenho
Com base nos dados coletados, escolhemos as consultas cuja execução é mais crítica/importante para o cliente (aplicação). Com a concordância do cliente, estabelecemos os valores das métricas de desempenho utilizando os campos queryid e max_time.
Resultado — início do monitoramento de desempenho
- O script de monitoramento, ao ser executado, verifica as métricas de desempenho configuradas, comparando o valor max_time da métrica com o valor da visualização pg_stat_statements no banco de dados de destino.
- Se o valor no banco de dados de destino exceder o valor da métrica – um alerta é gerado (incidente no sistema de tickets)
Possibilidade adicional 1
Histórico dos planos de execução de consultas
Para uma melhor resolução de incidentes de desempenho, é muito útil ter um histórico das alterações nos planos de execução das consultas.
Para armazenar o histórico, utiliza-se uma tabela de serviço chamada log_query. A tabela é preenchida durante a análise do arquivo de log carregado do PostgreSQL. Como no arquivo de log, ao contrário da visualização pg_stat_statements, entra o texto completo com valores dos parâmetros de execução, e não um texto normalizado, é possível registrar não apenas o tempo e a duração das consultas, mas também armazenar os planos de execução no momento atual.
Possibilidade adicional 2
Processo contínuo de melhoria de desempenho
O monitoramento de consultas individuais, de modo geral, não é destinado a resolver a questão da melhoria contínua do desempenho do banco de dados como um todo, pois controla e resolve problemas de desempenho apenas para consultas individuais. No entanto, é possível expandir o método e ajustar o monitoramento para consultas em todos os bancos de dados.
Para isso, é necessário inserir métricas de desempenho adicionais:
- Nos últimos dias
- Para o período base
O script seleciona consultas da visualização pg_stat_statements no banco de dados de destino e compara o valor max_time com a média do max_time, no primeiro caso para os últimos dias ou para o período de tempo selecionado (baseline) e no segundo caso.
Assim, em caso de degradação do desempenho de qualquer consulta, um alerta será gerado automaticamente, sem a necessidade de análise manual dos relatórios.
E qual é a relação com a síntese?
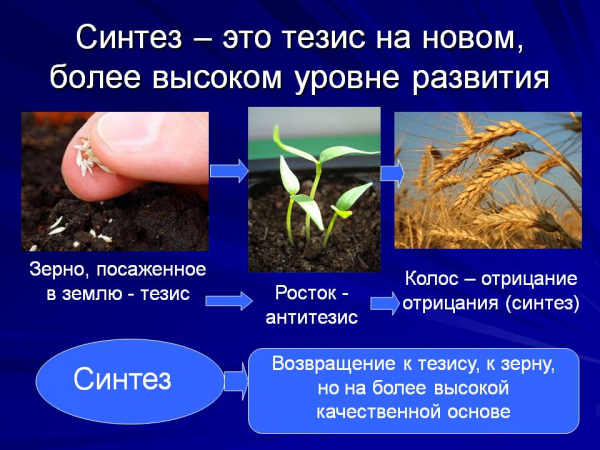
No método descrito, conforme propõe o método da síntese — ao melhorar partes individuais do sistema, melhoramos o sistema como um todo.
- A consulta executada pelo banco de dados – tese
- A consulta modificada – antítese
- Mudança no estado do sistema — síntese
Desenvolvimento do sistema
- Ampliação da estatística coletada com a adição de histórico para a vista do sistema pg_stat_activity
- Ampliação da estatística coletada com a adição de histórico para estatísticas de tabelas individuais participantes nas consultas
- Integração com o sistema de monitoramento na nuvem AWS
- E ainda, podemos pensar em mais alguma coisa...
Fonte: habr.com
