

Objetivo do sistema
Suporte ao acesso remoto a arquivos em computadores na rede. O sistema "virtualmente" suporta todas as operações básicas de arquivos (criação, exclusão, leitura, gravação, etc.) através da troca de transações (mensagens) pelo protocolo TCP.
Áreas de aplicação
O funcionamento do sistema é eficaz nas seguintes situações:
- em aplicativos nativos para dispositivos móveis e embutidos (smartphones, sistemas de controle embarcados, etc.), que exigem acesso rápido a arquivos em servidores remotos em condições de possíveis interrupções temporárias de conexão (quando saindo do modo offline);
- em bancos de dados carregados, se o processamento das solicitações é realizado em servidores, enquanto o armazenamento de dados ocorre em outros;
- em redes corporativas distribuídas para coleta e processamento de informações, que exigem alta velocidade na troca de dados, reserva e confiabilidade;
- em sistemas complexos com arquitetura de microserviços, onde os atrasos na troca de informações entre módulos são críticos.
Estrutura
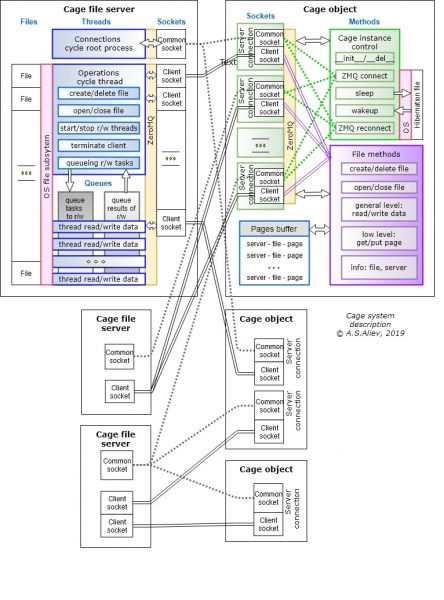
O sistema Cage (possui uma implementação — versão beta em Python 3.7 no Windows) inclui duas partes principais:
- Cageserver — um programa servidor de arquivos (pacote de funções) que é executado em computadores na rede, cujos arquivos requerem acesso remoto;
- classe Cage com uma biblioteca de métodos para software cliente, facilitando a codificação da interação com servidores.
Uso do sistema do lado do cliente
Os métodos da classe Cage substituem operações "rotineiras" comuns do sistema de arquivos: criação, abertura, fechamento, exclusão de arquivos, bem como leitura/gravação de dados em formato binário (indicando a posição e o tamanho dos dados). Conceitualmente, esses métodos são semelhantes às funções de arquivo da linguagem C, onde a abertura/fechamento de arquivos é realizada "em canais" de entrada/saída.
Em outras palavras, o programador trabalha não com os métodos de objetos de "arquivo" (classe _io em Python), mas sim com os métodos da classe Cage.
Ao criar uma instância do objeto Cage, ele estabelece a conexão inicial com o servidor (ou vários servidores), passa pela autenticação com o Id do cliente e recebe a confirmação com o número da porta designada para realizar todas as operações de arquivo. Ao remover o objeto Cage, ele envia ao servidor um comando para encerrar a conexão e fechar os arquivos. A interrupção da conexão pode ser iniciada pelos próprios servidores.
O sistema aumenta o desempenho de leitura/gravação com base no armazenamento em cache de fragmentos de arquivos frequentemente utilizados nas aplicações clientes na memória RAM.
O software cliente pode utilizar qualquer número de objetos Cage com diferentes configurações (tamanho da memória cache, tamanho dos blocos na troca com o servidor, etc.).
Um objeto Cage pode trocar dados com vários arquivos em vários servidores. Os parâmetros de conexão (endereço IP ou DNS do servidor, porta principal para autorização, caminho e nome do arquivo) são definidos na criação do objeto.
Como cada objeto Cage pode trabalhar simultaneamente com muitos arquivos, um espaço de memória comum é utilizado para o armazenamento em cache. O tamanho do cache - a quantidade de páginas e o seu tamanho - é definido dinamicamente na criação do objeto Cage. Por exemplo, um cache de 1 GB equivale a 1000 páginas de 1 MB, ou 10.000 páginas de 100 KB, ou 1 milhão de páginas de 1 KB. A escolha do tamanho e da quantidade de páginas é uma tarefa específica para cada caso de uso.
É possível utilizar vários objetos Cage simultaneamente para definir diferentes configurações de memória cache, dependendo das características de acesso às informações em diferentes arquivos. Um algoritmo de buffering simples é aplicado como padrão: após o esgotamento da quantidade definida de memória, novas páginas substituem antigas com base no princípio da substituição com o mínimo de acessos. O armazenamento em cache é particularmente eficaz em caso de acesso desigual (em um sentido estatístico), tanto a diferentes arquivos quanto a fragmentos de cada arquivo.
A classe Cage suporta entrada/saída não apenas por endereços de dados (especificando a posição e o comprimento do array, "substituindo" operações do sistema de arquivos), mas também em um nível mais baixo, "físico" - por números de páginas na memória cache.
Para os objetos Cage, é suportada uma função original "hibernação" («hibernação») – eles podem ser «encerrados» (por exemplo, em caso de interrupção da conexão com os servidores ou ao parar o aplicativo, etc.) em um arquivo de despejo local do lado do cliente e rapidamente restaurados a partir desse arquivo (após a restauração da conexão, ao reiniciar o aplicativo). Isso permite uma redução significativa do tráfego ao ativar o programa cliente após uma saída temporária «offline», já que fragmentos frequentemente usados dos arquivos estarão em cache.
Cage — são cerca de 3600 linhas de código.
Princípios de construção de servidores
Os servidores de arquivo Cageserver podem ser iniciados com um número qualquer de portas, uma das quais («principal») é usada apenas para a autorização de todos os clientes, enquanto as outras são para troca de dados. O programa do servidor Cage requer apenas Python. Paralelamente, o computador com o servidor de arquivos pode realizar qualquer outro trabalho.
O servidor é iniciado inicialmente como uma combinação de dois processos principais:
- «Conexões» – processo para realizar operações de estabelecimento e encerramento de conexão com os clientes por iniciativa do servidor;
- «Operações» – processo para realizar tarefas (operações) dos clientes relacionadas a arquivos, bem como para fechar sessões de conexão por comandos dos clientes.
Ambos os processos não são sincronizados e são organizados como ciclos infinitos de recebimento e envio de mensagens baseadas em filas multiprocessadas, proxies, semáforos e sockets.
O processo «Conexões» atribui a cada cliente uma porta para transmissão de dados. O número de portas é definido ao iniciar o servidor. A correspondência entre portas e clientes é armazenada na memória proxy compartilhada entre processos.
O processo «Operações» mantém a divisão de recursos de arquivos, onde vários clientes diferentes podem ler (quase paralelamente, uma vez que o acesso é controlado por bloqueios) dados de um único arquivo, se isso foi permitido no seu primeiro acesso pelo «primeiro» cliente.
O processamento de comandos para criar/excluir/abrir/fechar arquivos é servidor realizado dentro do próprio processo «Operações» de forma estritamente sequencial, utilizando o subsistema de arquivos do sistema operacional do servidor.
Para acelerar a leitura/gravação, essas operações são realizadas em threads criadas pelo processo "Operações". O número de threads geralmente é igual ao número de arquivos abertos. As tarefas de leitura/gravação dos clientes são enviadas a uma fila geral, e a primeira thread livre pega uma tarefa do início da fila. Uma lógica especial permite excluir operações de reescrita de dados na memória RAM do servidor.
O processo "Operações" monitora a atividade dos clientes e interrompe seu atendimento tanto por seus comandos quanto quando o tempo limite de inatividade é excedido.
Para garantir a confiabilidade, o Cageserver mantém registros de todas as transações. Um registro geral contém cópias das mensagens dos clientes com tarefas de criar/abrir/renomear/remover arquivos. Para cada arquivo em uso, é criado um registro separado, onde são registradas cópias das mensagens com tarefas de leitura e gravação de dados nesse arquivo, assim como matrizes de dados gravados (novos) e matrizes de dados que foram destruídos durante a reescrita (gravação de novos dados "sobre" os antigos).
Esses registros permitem tanto a recuperação de novas alterações em backups quanto o "rollback" do conteúdo atual para um momento desejado no passado.
Cageserver consiste em cerca de 3100 linhas de código.
Início do programa servidor de arquivos Cageserver
Ao iniciar, deve-se definir no diálogo:
— a porta principal para autorização;
— o número de portas para troca de transações com clientes autorizados (de 1 ou mais, o pool de números começa a partir do número seguinte à porta principal).
Uso da classe Cage
classe cage.Cage( cage_name=", pagesize=0, numpages=0, maxstrlen=0, server_ip={}, wait=0, awake=False, cache_file=" )
Objetos são criados a partir dessa classe, que interagem com servidores de arquivos e contêm memória buffer.
Parâmetros
- cage_name(str) — nome condicional do objeto, que é usado na identificação dos clientes no lado do servidor
- pagesize(int) — tamanho de uma página de memória buffer (em bytes)
- numpages(int) — número de páginas de memória buffer
- maxstrlen(int) — comprimento máximo da string em bytes nas operações de gravação e leitura
- server_ip(dict) — dicionário com os endereços utilizados servidores, onde a chave é o nome condicional do servidor (id do servidor dentro do aplicativo), e o valor é uma string com o endereço: “ip address:port” ou “DNS:port” (mapeamento de nomes e endereços reais é temporário, pode ser alterado)
- wait(int) — tempo de espera pela resposta do servidor ao receber portas (em seg.)
- despertar(booleano) — flag do método de criação do objeto (False — se um novo objeto é criado, Verdadeiro — se o objeto é criado a partir de um anteriormente ‘suspendido’ — usando a operação ‘hibernação’, por padrão Falso)
- arquivo_cache(str) — nome do arquivo para hibernação
Métodos
Cage.criar_arquivo( servidor, caminho ) – criar um novo arquivo
Cage.renomear_arquivo( servidor, caminho, novo_nome ) – renomear arquivo
Cage.remover_arquivo( servidor, caminho) – excluir arquivo
Cage.open( servidor, caminho, mod ) – abrir arquivo
Retorna fchannel número do canal. O parâmetro mod — é o modo de abertura do arquivo: ‘wm’ — monopolizado (leitura/gravação), ‘rs’ — apenas leitura, e compartilhado apenas para leitura por outros clientes, ‘ws’ — leitura/gravação, e compartilhado apenas para leitura por outros clientes.
Cage.fechar (fchannel) – fechar arquivo
Cage.exit (fchannel, begin, dados ) – gravar uma string de bytes no arquivo
Cage.write (fchannel, begin, len_dados ) – ler uma string de bytes do arquivo
Cage.colocar_páginas ( fchannel ) – ‘empurra’ do buffer para o servidor todas as páginas do canal especificado que foram modificadas. Usado nos pontos do algoritmo onde é necessário ter certeza de que todas as operações no canal estão fisicamente salvas no arquivo no servidor.
Cage.push_all () – ‘empurra’ do buffer para o servidor todas as páginas de todos os canais para a instância da classe Cage, que foram modificadas. Usado quando é necessário ter certeza de que todas as operações em todos os canais estão salvas no servidor.
Fonte: habr.com
