

TL;DR: Descrição da arquitetura cliente-servidor do nosso sistema interno de gerenciamento de configuração de rede, QControl. Na base está um protocolo de transporte de dois níveis, operando com mensagens compactadas em gzip sem descompressão entre os endpoints. Roteadores distribuídos e endpoints recebem atualizações de configuração, enquanto o próprio protocolo permite a instalação de relés intermediários localizados. O sistema é construído com base no princípio ('recent-stable', explicado abaixo) e utiliza a linguagem de consulta JMESpath juntamente com o template engine Jinja para renderizar arquivos de configuração.
A Qrator Labs gerencia uma rede de neutralização de ataques globalmente distribuída. Nossa rede opera segundo o princípio anycast, e sub-redes são anunciadas por meio do BGP. Sendo uma rede BGP anycast, fisicamente localizada em várias regiões do mundo, podemos processar e filtrar o tráfego ilegítimo mais próximo do núcleo da internet — operadores Tier-1.
Por outro lado, ser uma rede geograficamente distribuída não é simples. A comunicação entre pontos de presença de rede é criticamente importante para o provedor de serviços de segurança, a fim de manter uma configuração consistente de todos os nós da rede, atualizando-os de forma oportuna. Portanto, para fornecer o nível máximo possível de serviço principal ao consumidor, era necessário encontrar uma maneira de sincronizar de forma confiável os dados de configuração entre os continentes.
No princípio era a Palavra. Ela rapidamente se tornou um protocolo de comunicação que precisava de atualização.
A pedra angular da existência do QControl e, ao mesmo tempo, a principal razão para o investimento significativo de tempo e recursos na construção desse tipo de protocolo é a necessidade de obter uma fonte de configuração única e autoritativa e, em última análise, sincronizar nossas pontos de presença com ela. O próprio armazenamento foi apenas uma das várias exigências durante o desenvolvimento do QControl. Além disso, também precisávamos de integrações com serviços existentes e planejados nas Pontos de Presença (PP), formas inteligentes (e configuráveis) de validação de dados, além da delimitação de acesso. Além disso, também queríamos gerenciar esse sistema por meio de comandos e não fazendo modificações em arquivos. Antes do QControl, os dados eram enviados para os pontos de presença praticamente de forma manual. Se um dos pontos de presença estivesse indisponível, e esquecêssemos de atualizá-lo mais tarde, a configuração ficava desincronizada — era necessário gastar tempo para colocá-la de volta em funcionamento.
No final, elaboramos o seguinte esquema:
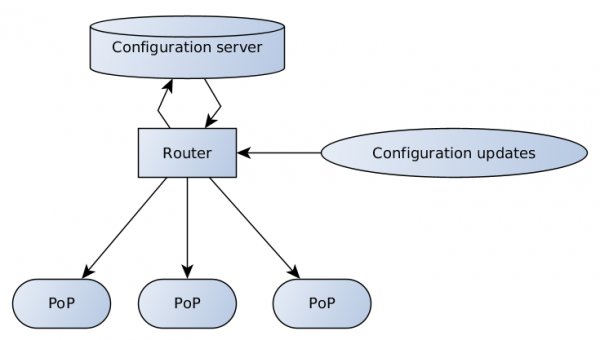
O servidor de configuração é responsável pela validação de dados e armazenamento, o roteador possui vários endpoints que recebem e transmitem atualizações de configuração dos clientes e da equipe de suporte para o servidor, e deste para os pontos de presença.
A qualidade da conexão à internet ainda varia significativamente em diferentes partes do mundo — para ilustrar esse ponto, vamos dar uma olhada em um MTR simples de Praga, República Checa, para Cingapura e Hong Kong.
MTR de Praga para Cingapura
O mesmo para Hong Kong
Altas latências significam velocidades menores. Além disso, há perda de pacotes. A largura de banda não compensa esse problema, que deve ser sempre levado em consideração ao construir sistemas descentralizados.
A configuração completa do ponto de presença é um volume significativo de dados que precisa ser enviado a muitos destinatários por conexões não confiáveis. Felizmente, embora a configuração mude constantemente, isso acontece em pequenas porções.
Design recent-stable
Pode-se dizer que a construção de uma rede distribuída com base em atualizações incrementais é uma solução bastante óbvia. Mas os diffs estão associados a uma série de problemas. Precisamos manter todos os diffs entre os pontos de referência, além de ser capaz de enviá-los novamente caso alguém perca parte dos dados. Cada ponto de destino deve aplicá-los em uma sequência estrita. Geralmente, no caso de múltiplos pontos de destino, essa operação pode levar um tempo considerável. O receptor também deve ser capaz de solicitar partes perdidas e, claro, a parte central deve responder a tal solicitação corretamente, enviando apenas os dados ausentes.
No final, chegamos a uma solução bastante interessante — temos apenas uma camada de referência, fixa, que chamaremos de stable, e apenas um diff para ela — recent. Cada recent é baseado no último stable formado e é suficiente para reconstruir os dados de configuração. Assim que um novo recent chega ao destino, o antigo já não é mais necessário.
Resta apenas enviar periodicamente uma nova configuração stable, por exemplo, porque o recent se tornou grande demais. Também é importante notar que enviamos todas essas atualizações em modo broadcast/multicast, sem nos preocupar com receptores individuais e sua capacidade de juntar pedaços de dados. Assim que garantimos que todos têm a stable correta — enviamos apenas os novos recent. Vale a pena esclarecer que isso funciona? Funciona. O stable é armazenado em cache no servidor de configuração e nos receptores, e o recent é criado conforme necessário.
Arquitetura de Transporte em Duas Camadas
Por que construímos nosso transporte em duas camadas? A resposta é bastante simples — queríamos separar o roteamento da lógica de alto nível, inspirando-nos no modelo OSI com seu nível de transporte e nível de aplicação. Para o protocolo de transporte, utilizamos o Thrift, e para o formato de alto nível das mensagens de controle — o formato de serialização msgpack. É por isso que o roteador (que executa multicast/broadcast/relay) não olha para dentro do msgpack, não desempacota e não empacota o conteúdo novamente, realizando apenas a retransmissão dos dados.
Thrift (do inglês — 'frugalidade', pronunciado como [θrift]) é uma linguagem de descrição de interfaces, usada para definir e criar serviços em várias linguagens de programação. Serve como um framework para chamada de procedimentos remotos (RPC). Combina um pipeline de software com um mecanismo de geração de código para o desenvolvimento de serviços que funcionam de forma eficaz e fácil entre linguagens.
Escolhemos o framework Thrift por causa do RPC e do suporte a muitas linguagens. Como de costume, os componentes principais foram o cliente e o servidor. No entanto, o roteador se mostrou desafiador, em parte pela falta de uma solução pronta durante nosso desenvolvimento.
 Existem outras opções, como protobuf / gRPC, no entanto, quando iniciamos nosso projeto, o gRPC ainda era bastante novo e não decidimos adotá-lo.
Claro, poderíamos (e na verdade, deveríamos) ter criado nossa própria solução. Seria mais fácil criar um protocolo para o que precisávamos, pois a arquitetura cliente-servidor é relativamente direta em comparação a construir um roteador com Thrift. De qualquer forma, há uma tradição de preconceito em relação a soluções próprias e implementações de bibliotecas populares (não sem razão), além disso, sempre surge a questão: 'Como iremos portar isso para outras linguagens?'. Portanto, descartamos imediatamente a ideia de criar uma solução própria.
Msgpack é um análogo do JSON, mas mais rápido e menor. É um formato binário de serialização de dados que permite a troca de informações entre várias linguagens.
No primeiro nível, temos Thrift com as informações mínimas necessárias para o roteador transmitir a mensagem. No segundo nível, estão as estruturas empacotadas em msgpack.
Escolhemos msgpack porque é mais rápido e compacto em comparação ao JSON. Mas o que é ainda mais importante, ele suporta tipos de dados personalizados, permitindo-nos usar recursos avançados como a transmissão de binários brutos ou objetos especiais que representam a ausência de dados, o que era importante para nosso esquema de 'recent-stable'.
JMESPath
JMESPath é uma linguagem de consulta para JSON.
Este é exatamente como a descrição que obtemos da documentação oficial do JMESPath, mas na verdade, ele oferece muito mais. O JMESPath permite buscar e filtrar subárvores em uma estrutura de árvore arbitrária, além de aplicar alterações aos dados em tempo real. Ele também permite adicionar filtros especiais e procedimentos de transformação de dados. Embora, é claro, exija um certo esforço mental para entendimento.
Jinja
Para alguns consumidores, precisamos transformar a configuração em um arquivo — por isso usamos um mecanismo de templates, e o Jinja é uma escolha óbvia. Com ele, geramos o arquivo de configuração a partir do template e dos dados recebidos no ponto de destino.
Para gerar o arquivo de configuração, precisamos de uma consulta JMESPath, um template para a localização do arquivo no sistema de arquivos e um template para a própria configuração. Também neste estágio, é bom esclarecer as permissões de acesso ao arquivo. Conseguimos combinar tudo isso de forma eficaz em um único arquivo — antes do início do template de configuração, colocamos um cabeçalho no formato YAML que descreve o restante.
Por exemplo:
---
 seletor: "[@][?@.fft._meta.version == `42`] | itens([0].fft_config || `{}`)"
 nome_arquivo_destino: "fft/{{ match[0] }}.json"
 modo_arquivo: 0644
 recarregar_daemons: [fft]
 ...
 {{ dict(match[1]) | json(indent=2, sort_keys=True) }}
Para fazer o arquivo de configuração para um novo serviço, adicionamos apenas um novo arquivo de template. Não são necessárias alterações no código-fonte ou no software nos pontos de presença.
O que mudou após a introdução do QControl nas operações? A primeira e mais importante — a entrega consistente e confiável de atualizações de configuração em todos os nós da rede. A segunda — a obtenção de uma poderosa ferramenta de verificação de configurações e a possibilidade de modificá-las pela nossa equipe de suporte, bem como pelos consumidores do serviço.
Conseguimos tudo isso utilizando o esquema de atualizações recent-stable para simplificar a comunicação entre o servidor de configuração e os receptores da configuração. Usando um protocolo de dois níveis para suportar uma forma independente do conteúdo de roteamento de dados. Integramos com sucesso um mecanismo de geração de configurações baseado em Jinja em uma rede distribuída de filtragem. Este sistema suporta uma ampla gama de métodos de configuração para nossa periferia distribuída e diversificada.
Obrigado pela ajuda na redação do material , , .
postagem.
Fonte: habr.com
