

Este artigo é o segundo na série sobre compressão rápida de dados. No primeiro artigo, foi descrito um compressor que opera a uma velocidade de 10GB/s por núcleo de processador (compressão mínima, RTT-Min).
Este compressor já foi integrado a equipamentos de duplicação forense para compressão rápida de dumps de mídias de informação e fortalecimento da resistência da criptografia. Ele também pode ser usado para compactar imagens de máquinas virtuais e arquivos de swap de memória RAM ao salvá-los em SSDs de alta performance.
No primeiro artigo, também foi anunciado o desenvolvimento de um algoritmo de compressão para a compressão de backups de discos HDD e SSD (compressão média, RTT-Mid) com parâmetros de compressão de dados substancialmente melhorados. Até o momento, este compressor está completamente pronto e este artigo é precisamente sobre ele.
O compressor que implementa o algoritmo RTT-Mid proporciona um nível de compressão comparável a arquivos compactadores padrão como WinRar e 7-Zip, funcionando em modo rápido. Ao mesmo tempo, sua velocidade de operação é pelo menos uma ordem de magnitude superior.
A velocidade de empacotamento/desempacotamento de dados é um parâmetro crítico que determina o campo de aplicação das tecnologias de compressão. Poucas pessoas teriam a ideia de compactar um terabyte de dados a uma velocidade de 10-15 Megabytes por segundo (exatamente essa é a velocidade dos compactadores em modo padrão), pois levaria quase vinte horas com o processador completamente em carga...
Por outro lado, o mesmo terabyte pode ser copiado a velocidades de cerca de 2-3 Gigabytes por segundo em cerca de dez minutos.
Portanto, a compressão de grandes volumes de informações é relevante se for realizada em velocidades não inferiores à taxa real de entrada/saída. Para sistemas modernos, isso equivale a pelo menos 100 Megabytes por segundo.
Essas velocidades só podem ser alcançadas por compressores modernos em modo 'rápido'. É nesse modo atual que vamos comparar o algoritmo RTT-Mid com compressores tradicionais.
Teste comparativo do novo algoritmo de compressão
O compressor RTT-Mid foi testado dentro de um programa de teste. Em um aplicativo ‘real’, ele funciona significativamente mais rápido, pois utiliza eficientemente a multithreading e aplica um compilador ‘normal’, e não C#.
Como os compressores utilizados no teste comparativo são baseados em diferentes princípios e diferentes tipos de dados são comprimidos de maneiras distintas, para assegurar a objetividade do teste, foi utilizado o método de medição da 'temperatura média do hospital'...
Foi criado um arquivo de despejo setorial do disco lógico com o sistema operacional Windows 10, que é a mistura mais natural de diferentes estruturas de dados que realmente existem em cada computador. A compressão deste arquivo permitirá comparar a velocidade e o grau de compressão do novo algoritmo com os compressores mais avançados utilizados nos atuais compactadores.
Este é o arquivo de despejo:
O arquivo de despejo foi comprimido pelos compressores RTT-Mid, 7-zip e WinRar. O compressor WinRar e o 7-zip foram configurados para a máxima velocidade de operação.
O compressor está funcionando 7-zip:
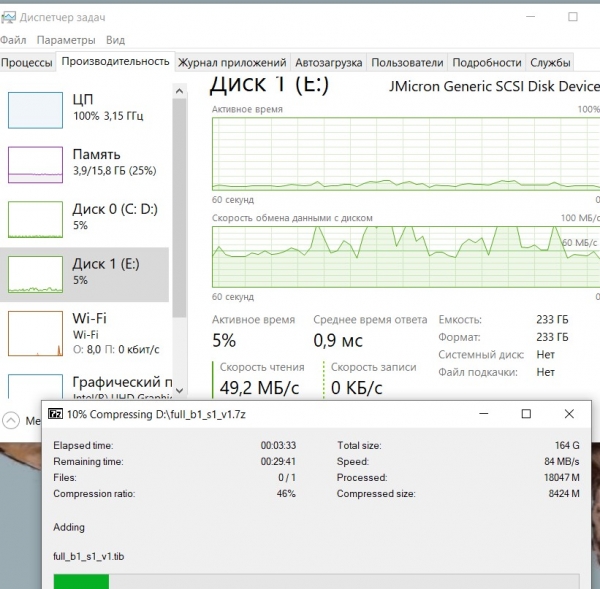
Ele utiliza 100% do processador, enquanto a velocidade média de leitura do despejo original é de cerca de 60 Megabytes/segundo.
O compressor está funcionando WinRar:
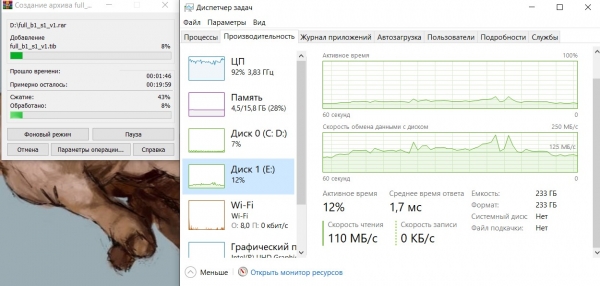
A situação é semelhante, a carga do processador é praticamente de 100%, e a velocidade média de leitura do despejo é de cerca de 125 Megabytes/segundo.
Como no caso anterior, a velocidade de operação do compactador é limitada pelas capacidades do processador.
Agora, o programa de teste do compressor está em execução RTT-Mid:
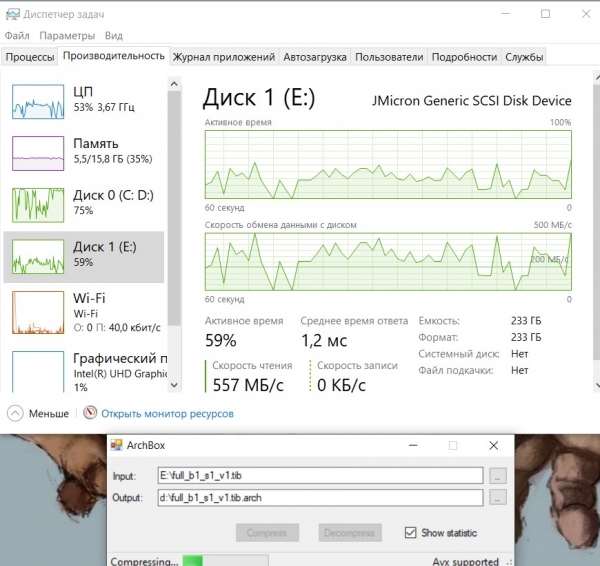
A captura de tela mostra que o processador está carregado em 50% e fica ocioso o restante do tempo, pois não há para onde descarregar os dados comprimidos. O disco de saída de dados (Disco 0) está praticamente cheio. A velocidade de leitura de dados (Disco 1) oscila bastante, mas em média é superior a 200 Megabytes/segundo.
A velocidade de operação do compressor é limitada, neste caso, pela capacidade de gravação dos dados comprimidos no Disco 0.
Agora, o grau de compressão dos arquivos gerados:
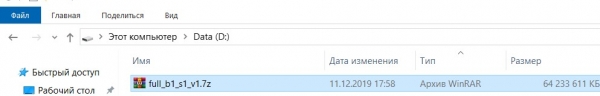
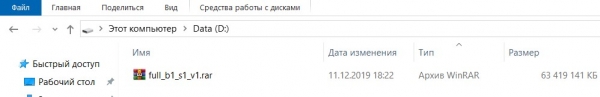
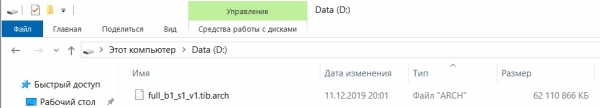
É evidente que o compressor RTT-Mid se saiu melhor em termos de compressão, o arquivo criado por ele tem 1,3 Gigabytes a menos que o arquivo do WinRar e 2,1 Gigabytes a menos que o arquivo 7z.
O tempo gasto para criar o arquivo:
- 7-zip – 26 minutos e 10 segundos;
- WinRar – 17 minutos e 40 segundos;
- RTT-Mid – 7 minutos e 30 segundos.
Assim, mesmo o programa de teste, que não foi otimizado, utilizando o algoritmo RTT-Mid, conseguiu criar o arquivo mais de duas vezes e meia mais rápido, e, além disso, o arquivo resultante foi significativamente menor do que os concorrentes...
Aqueles que não acreditam nas capturas de tela podem verificar sua autenticidade por conta própria. O programa de teste está disponível em , baixe e verifique.
Mas apenas em processadores que suportam AVX-2; sem suporte a essas instruções, o compressor não funcionará, e não teste o algoritmo em processadores AMD antigos, pois eles são lentos na execução de comandos AVX…
Método de compressão utilizado
O algoritmo utiliza um método de indexação de fragmentos de texto repetidos em granulação de bytes. Esse método de compressão é conhecido há muito tempo, mas não era utilizado, uma vez que a operação de busca de correspondências era muito dispendiosa em recursos e exigia muito mais tempo do que a construção de um dicionário. Assim, o algoritmo RTT-Mid é um exemplo clássico do movimento 'de volta para o futuro'...
No compressor RTT, utiliza-se um scanner de busca de correspondências exclusivo e de alta velocidade, que é o que permitiu acelerar o processo de compressão. O scanner é de fabricação própria, é 'meu tesouro...', 'custa muito, pois é completamente feito à mão' (escrito em assembly).
O scanner de busca de correspondências é realizado em um esquema probabilístico de dois níveis; primeiro, é escaneada a presença de um 'sinal' de correspondência, e somente após a identificação do 'sinal' nesse local, é iniciada a rotina de detecção da real correspondência.
A janela de busca de correspondências tem um tamanho imprevisível, dependendo do grau de entropia no bloco de dados processado. Para dados totalmente aleatórios (não comprimíveis), seu tamanho é de megabytes; para dados que têm repetições, sempre tem um tamanho superior a um megabyte.
Mas muitos formatos de dados modernos não são comprimíveis, e 'fazer correr' um scanner que consome muitos recursos sobre eles é inútil e desperdiçador, portanto, o scanner utiliza dois modos de operação. Primeiro, são buscadas seções do texto original com possíveis repetições; essa operação também é realizada de modo probabilístico e é feita muito rapidamente (a uma velocidade de 4-6 Gigabytes/segundo). Em seguida, as seções com possíveis correspondências são processadas pelo scanner principal.
A compressão indexada não é muito eficiente, pois é necessário substituir fragmentos repetidos por índices, e o array de índices reduz significativamente a taxa de compressão.
Para aumentar o grau de compressão, não são indexadas apenas as coincidências completas de strings de bytes, mas também as parciais, quando a string contém bytes coincidentes e não coincidentes. Para isso, o formato do índice inclui um campo de máscara de coincidências que indica os bytes coincidentes de dois blocos. Para uma compressão ainda maior, é utilizada a indexação sobreposta de vários blocos parcialmente coincidentes ao bloco atual.
Tudo isso permitiu que o compressor RTT-Mid alcançasse um grau de compressão comparável aos compressores que utilizam o método de dicionário, mas funcionando de maneira muito mais rápida.
A velocidade do novo algoritmo de compressão
Se o compressor opera com uso exclusivo da cache de memória (4 Megabytes por thread), a velocidade de operação varia entre 700-2000 Megabytes/segundo por núcleo de processador, dependendo do tipo de dados comprimidos e pouco depende da frequência de operação do processador.
Na implementação multithread do compressor, a escalabilidade efetiva é determinada pelo volume da cache de terceiro nível. Por exemplo, tendo "a bordo" 9 Megabytes de cache, não faz sentido iniciar mais de dois threads de compressão, pois a velocidade não aumentará com isso. Mas com 20 Megabytes de cache, já é possível iniciar cinco threads de compressão.
Outro parâmetro significativo que determina a velocidade do compressor é a latência da memória RAM. O algoritmo utiliza acessos aleatórios à RAM, parte dos quais não entra na cache (cerca de 10%) e ele acaba aguardando os dados da RAM, o que reduz a velocidade de operação.
A velocidade do compressor também é significativamente influenciada pelo trabalho do sistema de entrada/saída de dados. Solicitações à RAM do sistema de entrada/saída bloqueiam os acessos a dados pela CPU, o que também diminui a velocidade de compressão. Esse problema é relevante para notebooks e desktops, servidores mas é menos crítico devido a um bloco de controle de acesso mais avançado ao barramento do sistema e à memória RAM de múltiplos canais.
Em todo o texto do artigo, fala-se sobre compressão, enquanto a descompressão fica de fora deste artigo, pois "tudo está perfeito". A descompressão é realizada significativamente mais rápido e é limitada pela velocidade de entrada/saída. Um núcleo físico em um único thread pode facilmente proporcionar velocidades de descompactação de 3 a 4 Gigabytes/segundo.
Isso está relacionado à ausência da operação de busca de correspondências no processo de descompactação, que "consome" os principais recursos do processador e da cache durante a compressão.
Confiabilidade do armazenamento de dados comprimidos
Como o nome de toda a classe de ferramentas de software que utilizam compressão de dados (arquivadores) sugere, elas são destinadas ao armazenamento de informações por longos períodos, não por anos, mas por séculos e milênios...
Durante o armazenamento, os meios de informação perdem parte dos dados, veja este exemplo:
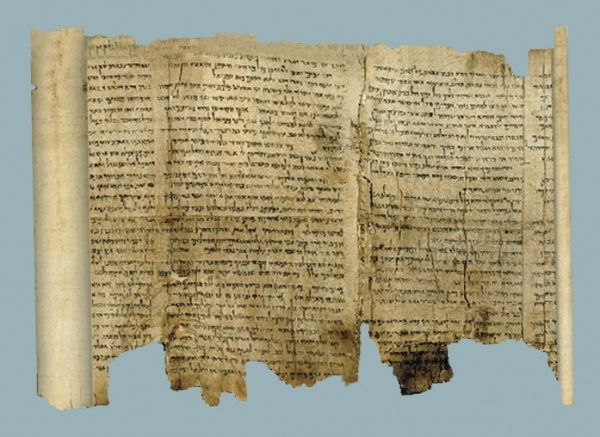
Este meio de informação "analógico" tem mil anos, alguns fragmentos estão perdidos, mas no geral a informação é "legível"...
Nenhum dos fabricantes responsáveis por sistemas modernos de armazenamento digital e seus meios digitais oferece garantias de completa integridade dos dados por mais de 75 anos.
E isso é um problema, mas um problema adiado, que será resolvido por nossos descendentes...
Sistemas de armazenamento de dados digitais podem perder dados não apenas após 75 anos, erros nos dados podem surgir a qualquer momento, mesmo durante sua gravação; essas distorções tentam ser minimizadas usando redundância e sistemas de correção de erros. A redundância e os sistemas de correção podem recuperar informações perdidas nem sempre, e se o fazem, não há garantias de que a operação de recuperação foi realizada corretamente.
E isso também é um grande problema, mas não adiado, e sim atual.
Os modernos compressores utilizados para arquivamento de dados digitais são baseados em várias modificações do método de dicionário e, para tais arquivos, a perda de um fragmento de informação será um evento fatal; existe até um termo estabelecido para essa situação — "arquivo corrompido"...
A baixa confiabilidade do armazenamento de informações em arquivos compactados por dicionário está relacionada à estrutura dos dados compactados. As informações em tal arquivo não contêm o texto original; em vez disso, armazenam números de registros no dicionário, que é dinamicamente modificado pelo texto atualmente compactado. Quando um fragmento do arquivo é perdido ou corrompido, todos os registros subsequentes no arquivo não podem ser identificados, nem pelo conteúdo nem pelo comprimento do registro no dicionário, pois não é claro a que corresponde o número de registro do dicionário.
Recuperar informações de um arquivo "corrompido" como esse é impossível.
O algoritmo RTT é baseado em um método de armazenamento de dados compactados mais confiável. Ele utiliza um método de indexação para rastrear fragmentos repetidos. Essa abordagem de compressão permite minimizar as consequências da corrupção de informações no meio de armazenamento e, em muitos casos, corrigir automaticamente as distorções que ocorrem durante o armazenamento das informações.
Isso se deve ao fato de que um arquivo compactado, no caso da compressão indexada, contém dois campos:
- um campo do texto original com as seções repetidas removidas;
- um campo de índices.
O campo de índices, crítico para a recuperação de informações, não é grande e pode ser duplicado para maior segurança no armazenamento de dados. Portanto, mesmo que um fragmento do texto original ou do array de índices seja perdido, toda a informação restante pode ser recuperada sem problemas, assim como na imagem de um meio de informação "analógico".
Desvantagens do algoritmo
Não existem vantagens sem desvantagens. O método de compressão por índices não comprime sequências repetidas de pequeno tamanho. Isso está relacionado às limitações do método indexado. Os índices têm um tamanho mínimo de 3 bytes e podem ter até 12 bytes. Se ocorrer uma repetição menor do que o tamanho descrito pelo índice, ela não será contabilizada, não importa com que frequência essas repetições sejam encontradas no arquivo compactado.
O método de compressão tradicional, baseado em dicionário, comprime efetivamente múltiplas repetições curtas e, por isso, alcança uma maior taxa de compressão do que a compressão indexada. No entanto, isso é conseguido à custa de uma alta carga no processador central, pois para que o método baseado em dicionário comece a comprimir dados de forma mais eficiente do que o método indexado, ele precisa reduzir a velocidade de processamento de dados para 10-20 megabytes por segundo em configurações computacionais reais com carga total da CPU.
Essas velocidades baixas são inaceitáveis para os sistemas de armazenamento de dados modernos e representam mais um interesse "acadêmico" do que prático.
O grau de compressão de informações será significativamente aumentado na próxima modificação do algoritmo RTT (RTT-Max), que já está em desenvolvimento.
Portanto, como sempre, a continuação virá…
Fonte: habr.com
