

Na Badoo, monitoramos constantemente novas tecnologias e avaliamos se devemos usá-las em nosso sistema. Um desses estudos, queremos compartilhar com a comunidade. Ele é dedicado ao Loki — um sistema de agregação de logs.
Loki é uma solução para armazenamento e visualização de logs, e também oferece um sistema flexível para análise e envio de dados para Prometheus. Em maio, uma nova atualização foi lançada, que está sendo amplamente divulgada pelos criadores. Ficamos curiosos sobre o que o Loki pode fazer, quais oportunidades oferece e até que ponto pode servir como uma alternativa ao ELK — o stack que usamos atualmente.
O que é Loki
Grafana Loki é um conjunto de componentes para um sistema completo de gerenciamento de logs. Ao contrário de outros sistemas semelhantes, Loki baseia-se na ideia de indexar apenas os metadados dos logs — labels (assim como no Prometheus), enquanto os logs em si são compactados em chunks separados.
,
Antes de passar para a descrição do que é possível fazer com o Loki, quero esclarecer o que se entende por "ideia de indexar apenas os metadados". Vamos comparar a abordagem do Loki com a abordagem de indexação em soluções tradicionais, como o Elasticsearch, usando um exemplo de uma linha de log do nginx:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Sistemas tradicionais analisam a linha inteira, incluindo campos com muitos valores únicos como user_id e item_id, e armazenam tudo em grandes índices. A vantagem dessa abordagem é que é possível realizar consultas complexas rapidamente, pois quase todos os dados estão no índice. Mas isso tem um custo: o índice se torna grande, o que resulta em maiores requisitos de memória. No final, o índice de texto completo dos logs é comparável em tamanho aos próprios logs. Para pesquisar rapidamente, o índice deve ser carregado na memória. E quanto mais logs há, mais rápido o índice cresce e mais memória ele consome.
A abordagem do Loki exige que apenas os dados necessários sejam extraídos da string, cujo número de valores é pequeno. Assim, obtemos um pequeno índice e podemos buscar dados filtrando-os por tempo e por campos indexados, e então escaneando o restante com expressões regulares ou busca de substrings. O processo pode não parecer o mais rápido, mas o Loki divide a consulta em várias partes e as executa em paralelo, processando uma grande quantidade de dados em pouco tempo. O número de shards e consultas paralelas dentro deles é configurável; assim, a quantidade de dados que pode ser processada por unidade de tempo depende linearmente da quantidade de recursos fornecidos.
Esse compromisso entre um grande índice rápido e um pequeno índice com uma varredura completa paralela permite que o Loki controle o custo do sistema. Ele pode ser configurado e expandido de forma flexível de acordo com as necessidades.
A pilha Loki consiste em três componentes: Promtail, Loki, Grafana. O Promtail coleta logs, os processa e os envia para o Loki. O Loki os armazena. E o Grafana pode consultar dados do Loki e exibi-los. Na verdade, o Loki não é usado apenas para armazenar logs e pesquisar neles. Toda a pilha oferece grandes possibilidades de processamento e análise dos dados recebidos, utilizando o modo Prometheus.
A descrição do processo de instalação pode ser encontrada .
Busca nos logs
A pesquisa nos logs pode ser feita em uma interface especial do Grafana — Explorer. Para as consultas, utiliza-se a linguagem LogQL, que é muito semelhante ao PromQL usado no Prometheus. Basicamente, pode ser considerado como um grep distribuído.
A interface de busca é assim:
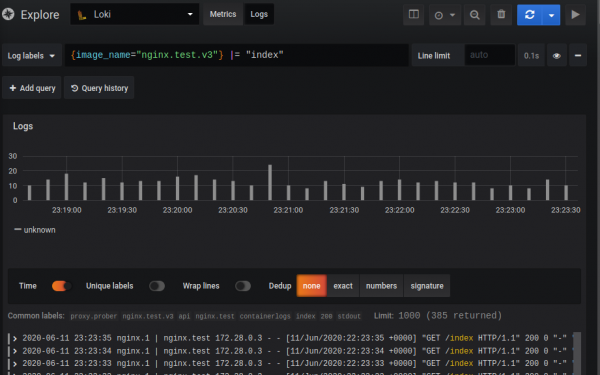
A consulta consiste em duas partes: o selector e o filter. O selector é a pesquisa em metadados indexados (rótulos) atribuídos aos logs, e o filter é a string de pesquisa ou regexp, com a qual os registros definidos pelo selector são filtrados. No exemplo apresentado: Entre chaves — o selector, tudo o que vem depois — o filter.
{image_name="nginx.promtail.test"} |= "index"Devido ao princípio de funcionamento do Loki, não é possível fazer consultas sem um selector, mas os rótulos podem ser tão gerais quanto se quiser.
O selector é uma combinação de valores key-value entre chaves. É possível combinar selectors e definir diferentes condições de pesquisa usando os operadores =, != ou expressões regulares:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Encontrará logs com o rótulo instance, contendo os valores kafka-2, kafka-3, e excluirá dev
O filtro é um texto ou regex que filtrará todos os dados obtidos pelo seletor.
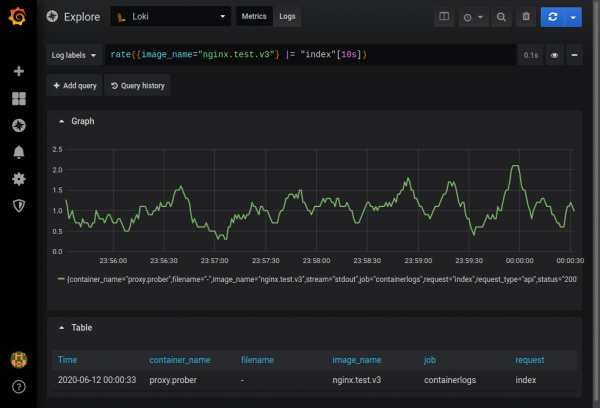
É possível obter gráficos ad-hoc a partir dos dados obtidos no modo metrics. Por exemplo, é possível descobrir a frequência de ocorrências em logs do nginx contendo a string index:
A descrição completa das funcionalidades pode ser encontrada na documentação .
Análise de logs
Existem várias maneiras de coletar logs:
- Usando o Promtail, um componente padrão do stack de coleta de logs.
- Diretamente do contêiner Docker usando
- Utilizando Fluentd ou Fluent Bit, que conseguem enviar dados para o Loki. Ao contrário do Promtail, eles possuem parsers prontos para praticamente qualquer tipo de log e lidam, inclusive, com logs multiline.
Normalmente, o Promtail é utilizado para análise. Ele faz três coisas:
- Encontra fontes de dados.
- Anexa a elas rótulos.
- Envia os dados para o Loki.
Atualmente, o Promtail pode ler logs de arquivos locais e do journal do systemd. Ele deve ser instalado em cada máquina da qual os logs são coletados.
Há integração com Kubernetes: o Promtail descobre automaticamente o estado do cluster através da API REST do Kubernetes e coleta logs do nó, serviço ou pod, imediatamente atribuindo rótulos com base em metadados do Kubernetes (nome do pod, nome do arquivo, etc.).
Os rótulos também podem ser atribuídos com base em dados do log usando o Pipeline. O Pipeline do Promtail pode consistir em quatro tipos de estágios. Para mais detalhes — em , aqui mencionarei algumas particularidades.
- Estágios de parsing. Este é o estágio RegEx e JSON. Nesta etapa, extraímos dados dos logs para o que chamamos de extracted map. É possível extrair de JSON, copiando simplesmente os campos necessários para o extracted map, ou através de expressões regulares (RegEx), onde no extracted map “mapeamos” grupos nomeados. O extracted map representa um armazenamento key-value, onde key é o nome do campo e value é seu valor nos logs.
- Estágios de transformação. Este estágio possui duas opções: transform, onde definimos as regras de transformação, e source — a fonte de dados para a transformação a partir do extracted map. Se no extracted map não houver tal campo, ele será criado. Assim, é possível criar rótulos que não são baseados no extracted map. Nesta etapa, podemos manipular dados no extracted map usando um Além disso, deve-se lembrar que o mapa extraído é carregado completamente durante o parsing, o que permite, por exemplo, verificar seu valor: “{{if .tag}tag value exists{end}}”. O template suporta condições, ciclos e algumas funções de string, como Replace e Trim.
- Estágios de açãoNesta etapa, é possível fazer algo com os dados extraídos:
- Criar um rótulo a partir dos dados extraídos, que será indexado pelo Loki.
- Alterar ou definir o horário do evento a partir do log.
- Modificar os dados (texto do log) que serão enviados ao Loki.
- Criar métricas.
- Estágios de filtragemA fase de correspondência, onde você pode enviar para /dev/null os registros que não precisamos ou direcioná-los para processamento adicional.
Vou mostrar como processar logs de nginx comuns e como é possível analisar logs com o Promtail.
Para o teste, usaremos uma imagem modificada do nginx jwilder/nginx-proxy:alpine como proxy do nginx e um pequeno daemon que pode consultar a si mesmo via HTTP. O daemon possui vários endpoints, para os quais pode responder com diferentes tamanhos, diferentes status HTTP e diferentes latências.
Iremos coletar logs de contêineres Docker, que podem ser encontrados no caminho /var/lib/docker/containers//-json.log
No docker-compose.yml, configuramos o Promtail e indicamos o caminho para o config:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Adicionamos no promtail.yml o caminho para os logs (no config há uma opção "docker", que faz o mesmo em uma linha, mas isso não seria tão claro):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # apenas para linux
Com essa configuração habilitada, os logs de todos os contêineres serão enviados ao Loki. Para evitar isso, alteramos as configurações do nginx de teste no docker-compose.yml — adicionamos a field de log tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Corrigimos o promtail.yml e configuramos o Pipeline. No início, os logs têm o seguinte formato:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /api/index HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.096"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /200 HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.000"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Fase do pipeline:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Extraímos do JSON de entrada os campos stream, attrs, attrs.tag (se existirem) e os colocamos no mapa extraído.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
Se conseguimos colocar o campo tag no mapa extraído, então usamos regex para extrair os nomes da imagem e do contêiner.
 - labels:
     image_name:
     container_name:
Atribuímos os rótulos. Se os dados extraídos tiverem as chaves image_name e container_name, seus valores serão atribuídos aos rótulos correspondentes.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Descartamos todos os logs que não possuem os rótulos image_name e container_name definidos.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
Para todos os logs em que image_name é igual a nginx.promtail.test, extraímos do log original o campo log e o colocamos no mapa extraído com a chave row.
  - regex:
         # suprimir cores do Forego
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
Limpamos a string de entrada com expressões regulares e extraímos o host virtual do nginx e a linha de log do nginx.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Analisamos o log do nginx com expressões regulares.
    - regex:
           source: request_url
           expression: ^.+\.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?.]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?.]+).*$
Analisamos request_url. Com a ajuda de regex, definimos o destino da solicitação: para estáticos, fotos, API e estabelecemos a chave correspondente no mapa extraído.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Usando operadores condicionais no Template, verificamos os campos definidos no mapa extraído e definimos para o campo request_type os valores necessários: photo, static, API. Atribuímos other se não for possível. Agora, request_type contém o tipo de solicitação.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
Definimos os rótulos api_request, virtual_host, request_type e status (status HTTP) com base no que conseguimos colocar no mapa extraído.
       - output:
           source: nginx_log_row
Alteramos a saída. Agora, o log do nginx limpo vai para o Loki a partir do mapa extraído.
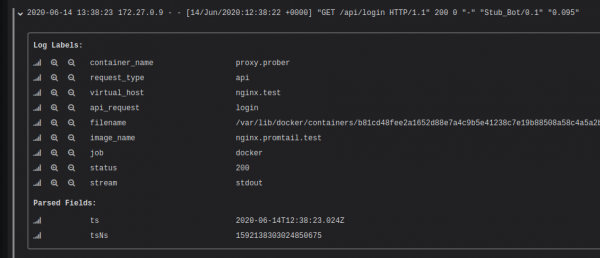
Após a execução da configuração apresentada, pode-se observar que cada registro foi atribuído com rótulos com base nos dados do log.
É importante ter em mente que a extração de rótulos com alta cardinalidade pode desacelerar significativamente o desempenho do Loki. Portanto, não se deve incluir, por exemplo, user_id no índice. Para mais informações, confira o artigo “”. Mas isso não significa que não seja possível pesquisar por user_id sem índices. É necessário usar filtros durante a pesquisa (fazer 'grep' nos dados), e o índice aqui atua como um identificador de fluxo.
Visualização de logs
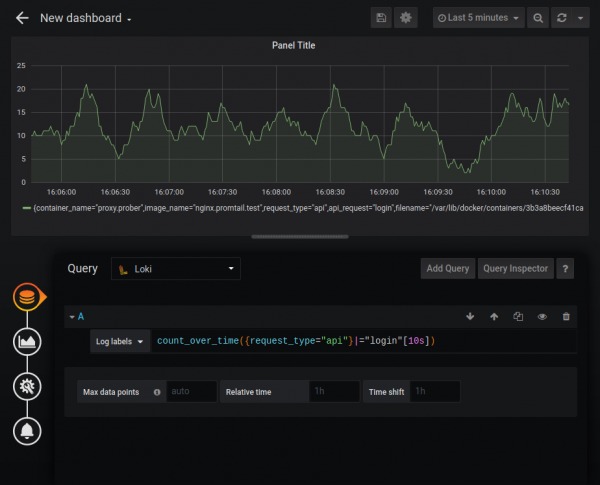
O Loki pode atuar como fonte de dados para gráficos do Grafana, usando LogQL. As seguintes funções são suportadas:
- rate — número de registros por segundo;
- count over time — número de registros em um intervalo específico.
Além disso, há funções agregadoras como Sum, Avg e outras. É possível construir gráficos bastante complexos, como um gráfico de quantidade de erros HTTP:
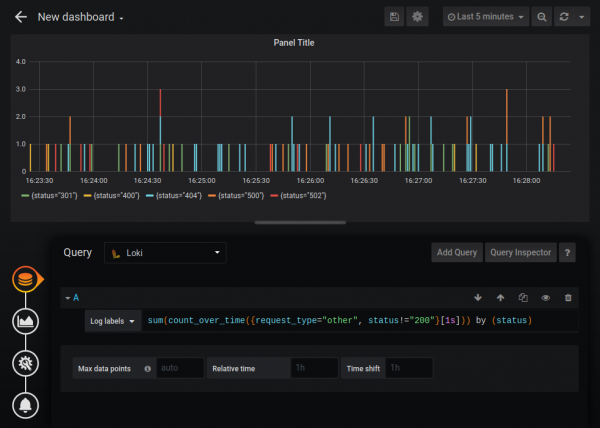
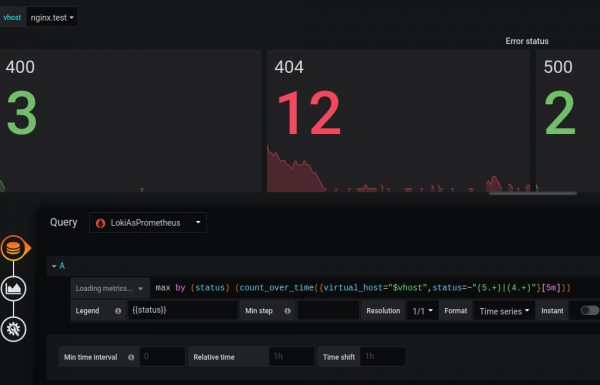
A fonte de dados padrão do Loki é um pouco limitada em funcionalidade em comparação com a fonte de dados do Prometheus (por exemplo, não é possível alterar a legenda), mas o Loki pode ser conectado como fonte do tipo Prometheus. Não tenho certeza se esse comportamento é documentado, mas, de acordo com a resposta dos desenvolvedores “”, isso parece ser perfeitamente válido, e o Loki é totalmente compatível com PromQL.
Adicionamos o Loki como fonte de dados do tipo Prometheus e inserimos a URL /loki:

E podemos criar gráficos, como se estivéssemos trabalhando com métricas do Prometheus:
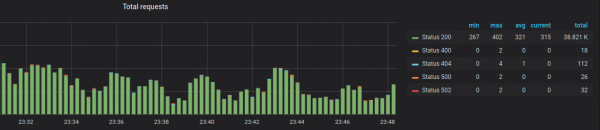
Acredito que a discrepância na funcionalidade é temporária e que os desenvolvedores irão corrigir isso no futuro.
Métricas
No Loki, há a possibilidade de extrair métricas numéricas dos logs e enviá-las ao Prometheus. Por exemplo, no log do nginx, há o número de bytes na resposta e, com uma modificação do formato padrão do log, o tempo em segundos necessário para a resposta. Esses dados podem ser extraídos e enviados ao Prometheus.
Adicionamos mais uma seção no promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "tempo de resposta ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "soma de bytes da resposta"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "contagem de bytes da resposta"
           source: bytes_out
           config:
             action: inc
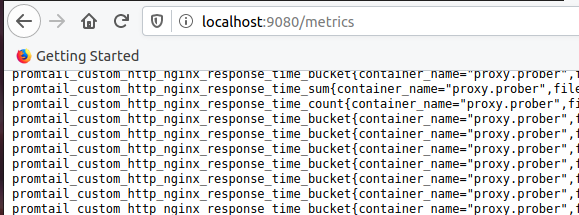
A opção permite definir e atualizar métricas com base em dados do mapa extraído. Essas métricas não são enviadas ao Loki — elas aparecem no endpoint Promtail /metrics. O Prometheus deve ser configurado para receber os dados obtidos nesta fase. No exemplo dado, para request_type="api", coletamos uma métrica de histograma. Com esse tipo de métricas, é conveniente obter percentis. Para estáticas e fotos, coletamos a soma de bytes e o número de linhas em que recebemos bytes, para calcular a média.
Leia mais sobre métricas .
Abrindo a porta no Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
Asseguramos que as métricas com o prefixo promtail_custom apareceram:
Configurando o Prometheus. Adicionamos o trabalho promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
E desenhamos o gráfico:
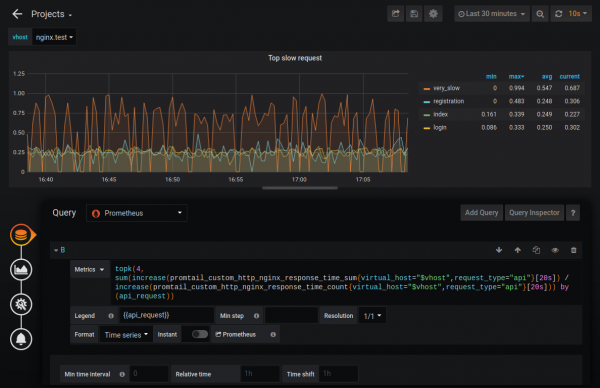
Dessa forma, é possível descobrir, por exemplo, as quatro requisições mais lentas. Além disso, é possível configurar o monitoramento para esses dados de métricas.
Escalabilidade
O Loki pode operar tanto em modo único (single binary mode) quanto em modo escalável horizontalmente (horizontally-scalable mode). No segundo caso, ele pode armazenar dados na nuvem, com chunks e índices armazenados separadamente. A versão 1.5 implementou a capacidade de armazenamento em um só lugar, mas ainda não é recomendada para uso em produção.
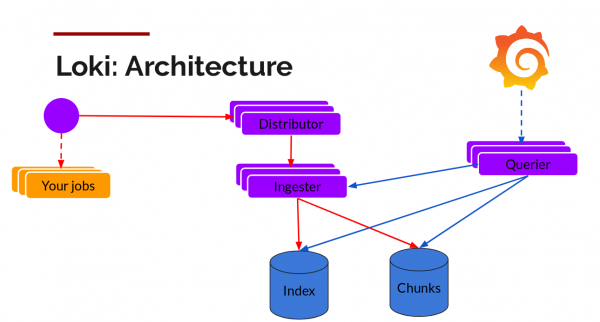
Os chunks podem ser armazenados em um armazenamento compatível com S3, enquanto os índices podem usar bancos de dados escaláveis horizontalmente: Cassandra, BigTable ou DynamoDB. Outras partes do Loki — Distributors (para gravação) e Querier (para consultas) — são sem estado e também escalam horizontalmente.
Na conferência DevOpsDays Vancouver 2019, um dos participantes, Callum Styan, mencionou que com o Loki, seu projeto possui petabytes de logs com um índice inferior a 1% do tamanho total: “”.
Comparação entre Loki e ELK
Tamanho do índice
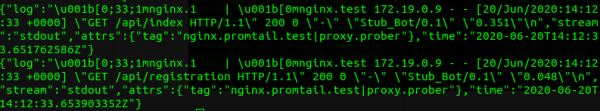
Para testar o tamanho do índice gerado, eu peguei logs do contêiner nginx, para o qual o Pipeline foi configurado acima. O arquivo de logs continha 406.624 linhas com um tamanho total de 109 MB. Os logs foram gerados durante uma hora, aproximadamente 100 registros por segundo.
Exemplo de duas linhas dos logs:
Na indexação do ELK, isso resultou em um tamanho de índice de 30,3 MB:
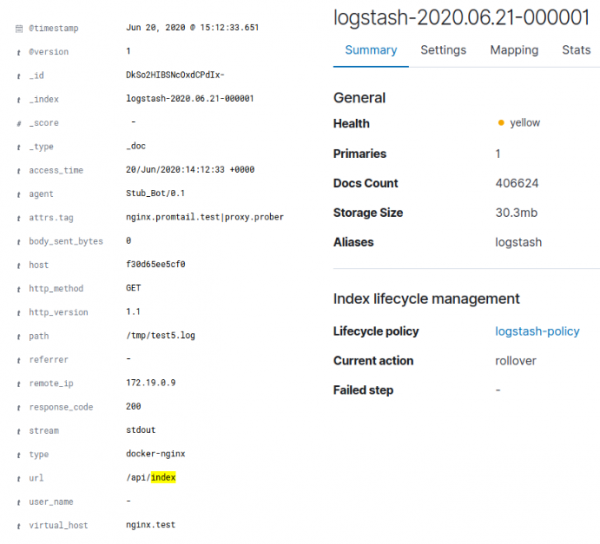
No caso do Loki, isso resultou em cerca de 128 Kb de índice e aproximadamente 3,8 Mb de dados em blocos. Vale ressaltar que o log foi gerado artificialmente e não apresentava grande diversidade de dados. A simples compressão gzip no log JSON original do Docker resultou em uma compressão de 95,4%, e considerando que apenas o log do nginx limpo foi enviado para o Loki, a compressão até 4 Mb é compreensível. O total de valores únicos para os rótulos do Loki era 35, o que explica o pequeno tamanho do índice. Para o ELK, o log também foi limpo. Assim, o Loki comprimiu os dados originais em 96%, enquanto o ELK fez isso em 70%.
Consumo de memória
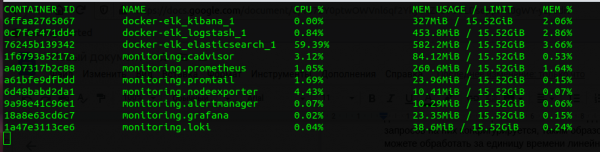
Se compararmos toda a pilha do Prometheus e do ELK, o Loki "consome" várias vezes menos. É claro que um serviço em Go consome menos do que um serviço em Java, e a comparação entre o tamanho da Heap da JVM do Elasticsearch e a memória alocada para o Loki não é precisa, mas ainda assim é importante notar que o Loki utiliza bem menos memória. Sua vantagem em relação ao CPU não é tão evidente, mas também existe.
Velocidade
O Loki consome logs mais rapidamente. A velocidade depende de muitos fatores — que tipo de logs, quão elaborados são os parses que fazemos, rede, disco etc. — mas é definitivamente superior à do ELK (nos meus testes, aproximadamente o dobro). Isso se explica pelo fato de que o Loki coloca muito menos dados no índice e, consequentemente, gasta menos tempo indexando. Por outro lado, a situação é oposta em relação à velocidade de busca: o Loki desacelera significativamente com dados de mais de alguns gigabytes, enquanto a velocidade de busca do ELK não depende do tamanho dos dados.
Busca nos logs
O Loki carece de capacidades de busca nos logs em comparação com o ELK. O Grep com expressões regulares é uma ferramenta poderosa, mas fica atrás de um banco de dados maduro. A falta de consultas de intervalo, agregação apenas por rótulos, e a impossibilidade de buscar sem rótulos — tudo isso limita nossas buscas por informações relevantes no Loki. Isso não significa que nada possa ser encontrado usando o Loki, mas define o fluxo de trabalho com logs, onde primeiro você identifica um problema em gráficos do Prometheus e depois, por esses rótulos, busca o que ocorreu nos logs.
Interface
Primeiramente, é bonito (desculpe, não consegui resistir). O Grafana tem uma interface agradável aos olhos, mas o Kibana é muito mais funcional.
Prós e contras do Loki
Entre os pontos positivos, podemos destacar que o Loki integra-se ao Prometheus, permitindo que recebamos métricas e alertas prontos para uso. Ele é conveniente para coletar e armazenar logs de Pods do Kubernetes, pois possui descoberta de serviços herdada do Prometheus e anexa automaticamente os rótulos.
Entre os pontos negativos, está a documentação fraca. Algumas coisas, como as características e capacidades do Promtail, descobri apenas ao estudar o código, felizmente disponível como open-source. Outro ponto negativo são as fracas capacidades de parsing. Por exemplo, o Loki não consegue analisar logs de várias linhas. Também podemos listar como desvantagem o fato de que o Loki é uma tecnologia relativamente nova (o lançamento da versão 1.0 foi em novembro de 2019).
Conclusão
O Loki é uma tecnologia 100% interessante, adequada para pequenos e médios projetos, permitindo resolver uma variedade de tarefas de agregação de logs, busca de logs, monitoramento e análise de logs.
Não usamos o Loki no Badoo, pois temos um stack ELK que nos atende e que, ao longo de muitos anos, foi enriquecido com várias soluções personalizadas. Para nós, a busca de logs é um obstáculo. Com quase 100 GB de logs por dia, é importante conseguirmos encontrar tudo e um pouco mais, e fazer isso de forma rápida. Para gráficos e monitoramento, usamos outras soluções que são adaptadas às nossas necessidades e integradas entre si. O stack Loki tem vantagens significativas, mas não nos trará mais do que já temos, e suas vantagens não compensarão o custo da migração.
E mesmo que após pesquisa tenha ficado claro que não podemos usar o Loki, esperamos que este post ajude você em sua escolha.
O repositório com o código utilizado no artigo está disponível .
Fonte: habr.com
