

O tema da resiliência em sistemas de armazenamento de dados é sempre atual, pois na era da virtualização e consolidação de recursos, o armazenamento é o elo cuja falha não resulta apenas em um incidente comum, mas em longos períodos de inatividade dos serviços. Portanto, os sistemas de armazenamento modernos possuem muitos componentes redundantes (inclusive controladores). Mas será que essa proteção é suficiente?
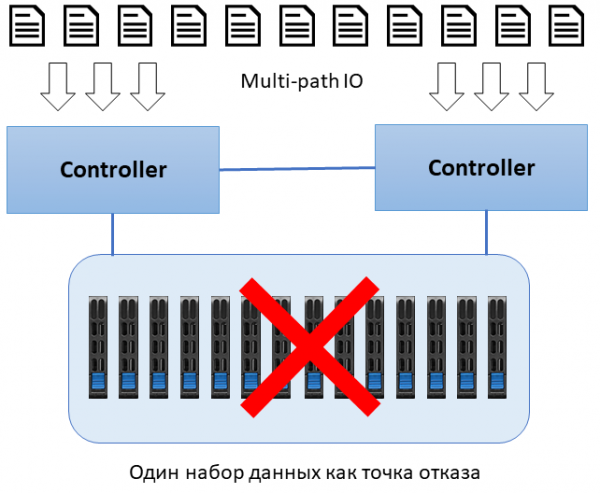
Todos os fornecedores, ao listar as características de seus sistemas de armazenamento, sempre mencionam a alta resiliência de suas soluções, adicionando necessariamente o termo "sem ponto único de falha". Vamos dar uma olhada mais de perto em um sistema típico de armazenamento. Para evitar inatividade durante a manutenção, os sistemas de armazenamento têm fontes de alimentação, módulos de refrigeração, portas de entrada/saída, dispositivos de armazenamento (como RAID) e, claro, controladores redundantes. Se olharmos atentamente para essa arquitetura, podemos notar, no mínimo, dois pontos potenciais de falha que são modestamente omitidos:
- A presença de um único backplane
- A presença de uma única cópia de dados
O backplane é um dispositivo tecnicamente complexo, que passa por rigorosos testes durante a fabricação. Portanto, é extremamente raro que ele falhe completamente. No entanto, mesmo em caso de falhas parciais, como um slot de armazenamento quebrado, será necessária a sua substituição com a total desativação do sistema de armazenamento.
A criação de várias cópias de dados também, à primeira vista, não parece ser um problema. Por exemplo, a funcionalidade Clone em sistemas de armazenamento, que permite a atualização periódica de uma cópia completa de dados, é bastante comum. No entanto, se houver problemas com o mesmo backplane, a cópia estará tão inacessível quanto o original.
Uma solução bastante óbvia para superar essas desvantagens é a replicação em um outro armazenamento. Se ignorarmos o esperado dobro dos custos de hardware (já que supomos que as pessoas que escolhendo tal solução pensam de forma adequada e aceitam esse fato antecipadamente), restarão ainda possíveis despesas para organizar a replicação, como licenças, software adicional e hardware. E o principal – será necessário garantir de alguma forma a consistência dos dados replicados. Ou seja, construir um virtualizador de armazenamento/vSAN/etc., o que também demanda recursos financeiros e de tempo.
Ao criar seus sistemas de Alta Disponibilidade, o objetivo foi eliminar as desvantagens mencionadas acima. Assim, surgiu a interpretação da tecnologia Shared Nothing, que em tradução livre significa “sem usar dispositivos compartilhados”.
Conceito A arquitetura consiste na utilização de dois nós independentes (controladores), cada um com seu próprio conjunto de dados. Entre os nós, realiza-se a replicação síncrona através da interface InfiniBand 56G de forma totalmente transparente para o software que opera sobre o sistema de armazenamento. Como resultado, não é necessário aplicar virtualizadores de armazenamento, agentes de software, etc.
A solução de dois nós da AccelStor pode ser executada em dois modelos:
- — baseada em servidores Twin em um gabinete 2U, se um desempenho moderado e capacidade de até 22TB forem necessários;
- — baseada em servidores individuais de 2U, se um alto desempenho e maior capacidade (até 57TB) forem requeridos.
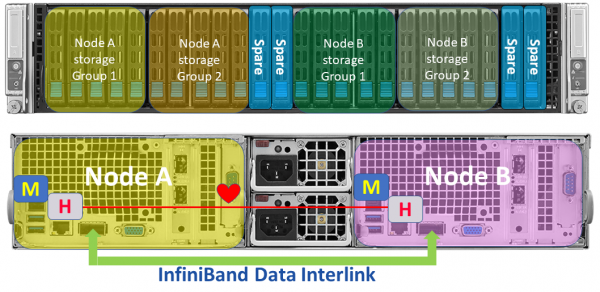
Modelo H510 baseado em servidor Twin
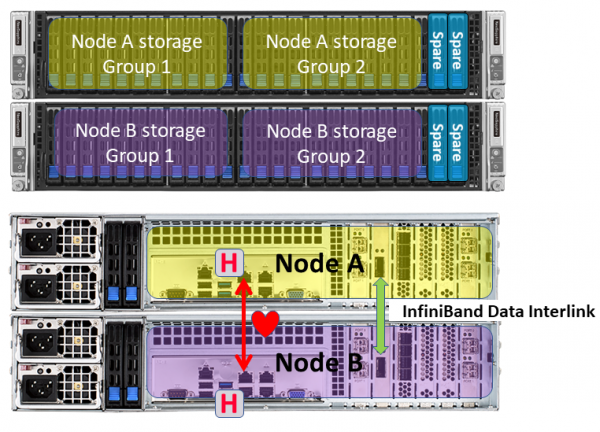
Modelo H710 baseado em servidores individuais
O uso de diferentes fatores de forma é devido à necessidade de diferentes quantidades de SSD para alcançar o volume e desempenho exigidos. Além disso, a plataforma Twin é mais barata e permite oferecer soluções de custo mais acessíveis, embora com um certo “desvantagem” condicional de um único backplane. Todo o restante, incluindo os princípios de operação, é completamente idêntico entre ambos os modelos.
O conjunto de dados em cada nó possui dois grupos , além de 2 hot spare. Cada grupo é capaz de suportar a falha de um SSD. Todas as solicitações de gravação são direcionadas ao nó de acordo com O FlexiRemap reorganiza em cadeias sequenciais com blocos de 4KB, que são então gravados em SSD no modo mais confortável possível (gravação sequencial). O host só recebe a confirmação da gravação após o armazenamento físico dos dados no SSD, ou seja, sem cache em RAM. Como resultado, alcança-se um desempenho impressionante de até 600K IOPS em gravação e 1M+ IOPS em leitura (modelo H710).
Como já mencionado anteriormente, a sincronização dos conjuntos de dados ocorre em tempo real através da interface InfiniBand 56G, que possui alta largura de banda e baixa latência. Para utilizar o canal de comunicação da maneira mais eficaz ao transferir pacotes pequenos, é utilizado um link dedicado de 1GbE para verificação adicional do heartbeat. Através dele são transmitidos apenas dados de heartbeat, portanto, não há requisitos de desempenho exigidos.
No caso de aumento da capacidade do sistema (até 400+ TB) através de eles também são conectados em pares para atender ao conceito de 'sem ponto único de falha'.
Para proteção adicional dos dados (além de que o AccelStor já possui duas cópias), utiliza-se um algoritmo especial de comportamento em caso de falha de qualquer SSD. Se um SSD falhar, o nó começará a reconstruir os dados em um dos drives hot spare. O grupo FlexiRemap, que estiver em estado degradado, mudará para o modo somente leitura. Isso é feito para evitar interferências nas operações de gravação e na reconstrução no disco de reserva, o que, por sua vez, acelera o processo de recuperação e reduz o tempo em que o sistema potencialmente fica vulnerável. Após a conclusão da reconstrução, o nó retorna ao modo normal de operação de leitura e gravação.
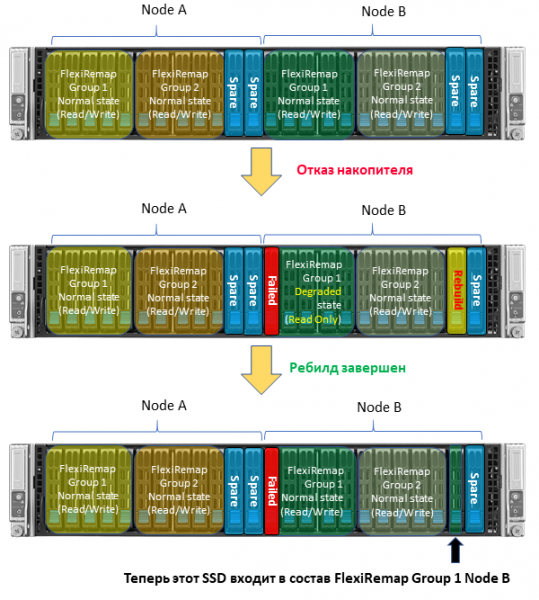
Claro, como em outros sistemas, a performance geral diminui durante a reconstrução (uma vez que um dos grupos FlexiRemap não está operando na gravação). Mas o próprio processo de recuperação ocorre da maneira mais rápida possível, o que distingue de maneira positiva os sistemas AccelStor das soluções de outros fornecedores.
Outra característica útil da tecnologia Nothing Shared na arquitetura é a operação dos nós no chamado modo ativo-ativo verdadeiro. Ao contrário da arquitetura 'clássica', onde um volume/pool específico é propriedade de apenas um controlador, enquanto o segundo apenas executa operações de entrada/saída, nos sistemas cada nó opera com seu próprio conjunto de dados e não transmite solicitações para o "vizinhos". Como resultado, a performance geral do sistema é aumentada devido ao processamento paralelo das solicitações de entrada/saída pelos nós e ao acesso aos dispositivos de armazenamento. Além disso, praticamente não existe o conceito de failover, uma vez que não é necessário transferir o controle dos volumes para outro nó em caso de falha.
Quando comparada à tecnologia Nothing Shared da arquitetura com a replicação total de sistemas de armazenamento, a primeira, à primeira vista, pode parecer um pouco inferior à implementação completa de recuperação de desastres em termos de flexibilidade. Isso se aplica especialmente à organização da linha de comunicação entre os sistemas de armazenamento. Assim, no modelo H710, é possível distribuir os nós a uma distância de até 100m utilizando cabos ópticos ativos InfiniBand, que não são exatamente baratos. Mas até mesmo ao comparar com a implementação convencional de replicação síncrona de outros fornecedores através do FibreChannel disponível, mesmo em distâncias maiores, a solução da AccelStor se mostra mais econômica e simples de instalar/explorar, pois não há necessidade de instalar virtualizadores de sistemas de armazenamento e/ou integrar com softwares (o que nem sempre é possível na prática). Além disso, não esquecemos que as soluções da AccelStor são arrays All Flash com desempenho superior ao das "clássicas" sistemas de armazenamento com SSD apenas.
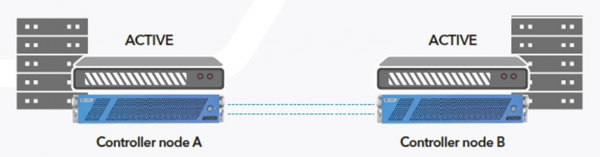
Ao utilizar a tecnologia Nothing Shared na arquitetura da AccelStor, é possível alcançar uma disponibilidade do sistema de armazenamento de 99.9999% a um custo bastante razoável. Juntamente com a alta confiabilidade da solução, em parte devido ao uso de duas cópias de dados, e desempenho impressionante graças a algoritmos proprietários. , as soluções da são excelentes candidatas para posições-chave na construção de um moderno data center.
Fonte: habr.com
