

Olá a todos. Amigos, estamos compartilhando com vocês a tradução de um artigo, preparado especialmente para os estudantes do curso . Vamos lá!
Apache Beam e DataFlow para pipelines em tempo real
O post de hoje é baseado em uma tarefa que eu recentemente trabalhei no trabalho. Fiquei realmente animado em realizá-la e descrever o trabalho realizado em formato de blog, pois isso me deu a oportunidade de me envolver em engenharia de dados, além de fazer algo que seria muito útil para minha equipe. Não muito tempo atrás, descobri que nossos sistemas armazenavam um grande log de usuários relacionado a um de nossos produtos de manipulação de dados. Descobri que ninguém estava utilizando esses dados, então imediatamente me interessei em saber o que poderíamos aprender se começássemos a analisá-los regularmente. No entanto, havia alguns obstáculos. O primeiro obstáculo era que os dados estavam armazenados em muitos arquivos de texto diferentes, que não eram acessíveis para análise imediata. O segundo obstáculo era que eles estavam salvos em um sistema fechado, então não pude usar nenhuma das minhas ferramentas favoritas para análise de dados.
Eu precisava decidir como facilitar o acesso para nós e trazer alguma utilidade embutindo essa fonte de dados em algumas de nossas soluções de interações com os usuários. Após pensar um pouco, decidi construir um pipeline para enviar esses dados para um banco de dados em nuvem, para que eu e a equipe pudéssemos acessá-los e começar a gerar algumas conclusões. Depois que terminei a especialização em Engenharia de Dados na Coursera há algum tempo, estava ansioso para usar alguns dos ferramentas do curso em meu projeto.
Assim, armazenar os dados em um banco de dados em nuvem parecia uma solução sensata para o meu primeiro problema, mas o que eu poderia fazer com o problema número 2? Felizmente, havia uma maneira de transferir esses dados para um ambiente onde eu poderia acessar ferramentas como Python e Google Cloud Platform (GCP). No entanto, foi um processo demorado, então eu precisava fazer algo que me permitisse continuar o desenvolvimento enquanto aguardava a conclusão da transferência de dados. A solução que encontrei foi criar dados falsos usando a biblioteca Faker em Python. Eu nunca usei essa biblioteca antes, mas percebi rapidamente o quão útil ela é. Usar essa abordagem me permitiu começar a escrever código e testar o pipeline sem dados reais.
Considerando o que já foi dito, neste post eu contarei como construí o pipeline descrito acima, usando algumas das tecnologias disponíveis no GCP. Em particular, eu usarei Apache Beam (versão para Python), Dataflow, Pub/Sub e BigQuery para coletar logs de usuários, transformar dados e enviá-los para um banco de dados para análise posterior. No meu caso, eu precisava apenas da funcionalidade em lote do Beam, já que meus dados não chegavam em tempo real, portanto, o Pub/Sub não era necessário. No entanto, eu falarei sobre a versão em streaming, pois é isso que você pode encontrar na prática.
Introdução ao GCP e Apache Beam
A Google Cloud Platform oferece um conjunto de ferramentas realmente úteis para processamento de grandes dados. Aqui estão algumas das ferramentas que eu vou usar:
- é um serviço de mensagens que utiliza o padrão Publicador-Inscritor (Publisher-Subscriber), permitindo-nos receber dados em tempo real.
- é um serviço que facilita a criação de pipelines de dados e resolve automaticamente tarefas como escalonamento de infraestrutura, o que significa que podemos nos concentrar apenas em escrever o código para nosso pipeline.
- é um armazenamento de dados em nuvem. Se você está familiarizado com outros bancos de dados SQL, não será difícil entender o BigQuery.
- E por fim, usaremos o Apache Beam, focando especificamente na versão Python para criar nosso pipeline. Esta ferramenta nos permitirá criar um pipeline para processamento em streaming ou em lote, que se integra ao GCP. É especialmente útil para processamento paralelo e adequado para tarefas de extração, transformação e carga (ETL), então, se precisarmos mover dados de um lugar para outro com transformações ou cálculos, o Beam é uma boa escolha.
Há uma ampla variedade de ferramentas disponíveis no GCP, então pode ser difícil acompanhar todas elas e qual é seu propósito, mas aqui está um resumo delas para referência.
No GCP, há muitos instrumentos disponíveis, por isso pode ser difícil abranger todos, incluindo seu propósito, mas mesmo assim resumo para referência.
Visualização do nosso pipeline
Vamos visualizar os componentes do nosso pipeline na figura 1. Em um nível alto, queremos coletar dados de usuários em tempo real, processá-los e enviá-los para o BigQuery. Logs são gerados quando os usuários interagem com o produto, enviando solicitações ao servidor, que são então registradas. Esses dados podem ser especialmente úteis para entender como os usuários interagem com nosso produto e se ele está funcionando corretamente. No geral, o pipeline conterá as seguintes etapas:
O Beam torna esse processo muito simples, independentemente de termos uma fonte de dados em streaming ou um arquivo CSV, e quisermos realizar um processamento em lote. Mais tarde, você verá que no código há apenas mínimas alterações necessárias para alternar entre eles. Esta é uma das vantagens de usar o Beam.
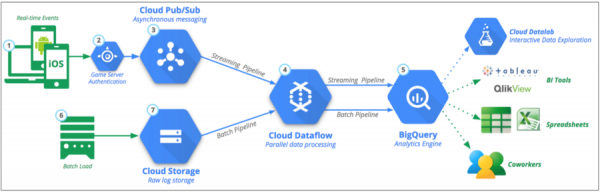
Figura 1: Pipeline de dados principal: Fonte:
Gerando dados simulados com Faker
Como mencionei anteriormente, devido ao acesso limitado aos dados, decidi criar dados simulados no mesmo formato que os reais. Isso foi um exercício realmente útil, pois pude escrever código e testar o pipeline enquanto aguardava os dados. Vamos dar uma olhada no Faker, se você quiser saber o que mais essa biblioteca pode oferecer. Nossos dados de usuário serão, em geral, semelhantes ao exemplo abaixo. Com base nesse formato, podemos gerar dados linha por linha para simular dados em tempo real. Esses logs nos fornecem informações como data, tipo de solicitação, resposta do servidor, endereço IP, etc.
192.52.197.161 - - [30/Abr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
Com base na linha acima, queremos criar nossa variável LINE, utilizando 7 variáveis entre chaves abaixo. Nós também as utilizaremos como nomes de variáveis em nosso esquema de tabelas mais adiante.
LINHA = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Se estivéssemos fazendo processamento em lote, o código seria muito semelhante, embora precisássemos criar um conjunto de amostras em algum intervalo de tempo. Para usar o faker, simplesmente criamos um objeto e chamamos os métodos que precisamos. Em particular, o Faker foi útil para criar endereços IP, bem como sites. Usei os seguintes métodos:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "\/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Fim da primeira parte.
Nos próximos dias, vamos compartilhar com vocês a continuação do artigo, e agora, como de costume, aguardamos os comentários ;-).
Fonte: habr.com
