

Olá a todos. Compartilhamos a tradução da parte final de um artigo preparado especialmente para os alunos do curso . Você pode conferir a primeira parte .
Apache Beam e DataFlow para pipelines em tempo real
Configuração do Google Cloud
Observação: Para executar o pipeline e publicar os dados do log personalizado, utilizei o Google Cloud Shell, pois enfrentei problemas ao executar o pipeline em Python 3. O Google Cloud Shell utiliza Python 2, que é mais compatível com o Apache Beam.
Para executar o pipeline, precisamos explorar um pouco nas configurações. Aqueles de vocês que nunca usaram o GCP antes devem seguir os 6 passos listados nesta .
Após isso, teremos que fazer o upload de nossos scripts para o armazenamento em nuvem do Google e copiá-los para o nosso Google Cloud Shell. O upload para o armazenamento em nuvem é bastante trivial (as instruções podem ser encontradas ). Para copiar nossos arquivos, podemos abrir o Google Cloud Shell a partir da barra de ferramentas, clicando no primeiro ícone à esquerda na imagem 2 abaixo.
Figura 2
Os comandos que precisamos para copiar arquivos e instalar as bibliotecas necessárias estão listados abaixo.
# Copy file from cloud storage
gsutil cp gs://<YOUR-BUCKET>/ * .
sudo pip install apache-beam[gcp] oauth2client==3.0.0
sudo pip install -U pip
sudo pip install Faker==1.0.2
# Environment variables
BUCKET=<YOUR-BUCKET>
PROJECT=<YOUR-PROJECT>
Criando nosso banco de dados e tabela
Depois de realizar todos os passos de configuração, a próxima coisa que precisamos fazer é criar um conjunto de dados e uma tabela no BigQuery. Há várias maneiras de fazer isso, mas a mais simples é usar o console do Google Cloud, começando pela criação do conjunto de dados. Você pode seguir as instruções fornecidas para , para criar a tabela com o esquema. Nossa tabela terá 7 colunas, correspondendo aos componentes de cada log personalizado. Para facilitar, definiremos todas as colunas como strings (tipo string), exceto a variável timelocal, e as nomearemos de acordo com as variáveis que geramos anteriormente. O esquema da nossa tabela deve se parecer com o da figura 3.
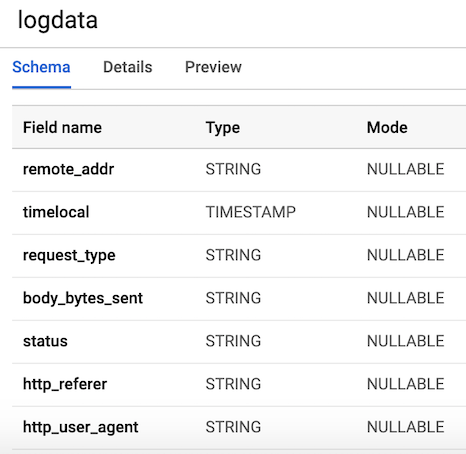
Figura 3. Esquema da tabela
Publicação dos dados do log personalizado
O Pub/Sub é um componente crítico em nossa pipeline, pois permite que vários aplicativos independentes se comuniquem entre si. Em particular, ele atua como um intermediário, permitindo que enviemos e recebamos mensagens entre os aplicativos. A primeira coisa que precisamos fazer é criar um tópico. É simples, basta acessar o Pub/Sub no console e clicar em CRIAR TÓPICO.
O código abaixo chama nosso script para gerar os dados de log definidos acima e, em seguida, se conecta e envia os logs para o Pub/Sub. A única coisa que precisamos fazer é criar um objeto PublisherClient, especificar o caminho para o tópico usando o método topic_path e chamar a função publish com topic_path com os dados. Note que estamos importando generate_log_line de nosso script stream_logs, então certifique-se de que esses arquivos estejam na mesma pasta, caso contrário você receberá um erro de importação. Em seguida, podemos executar isso através do nosso console do Google usando:
python publish.pyfrom stream_logs import generate_log_line
import logging
from google.cloud import pubsub_v1
import random
import time
PROJECT_ID="user-logs-237110"
TOPIC = "userlogs"
publisher = pubsub_v1.PublisherClient()
topic_path = publisher.topic_path(PROJECT_ID, TOPIC)
def publish(publisher, topic, message):
data = message.encode('utf-8')
return publisher.publish(topic_path, data = data)
def callback(message_future):
# Quando o tempo limite não é especificado, o método de exceção espera indefinidamente.
if message_future.exception(timeout=30):
print('Publicar mensagem em {} gerou uma exceção {}.'.format(
topic_name, message_future.exception()))
else:
print(message_future.result())
if __name__ == '__main__':
while True:
line = generate_log_line()
print(line)
message_future = publish(publisher, topic_path, line)
message_future.add_done_callback(callback)
sleep_time = random.choice(range(1, 3, 1))
time.sleep(sleep_time)Assim que o arquivo for executado, poderemos observar a saída dos dados de log no console, como mostrado na figura abaixo. Este script irá funcionar até usarmos CTRL+C, para finalizá-lo.
Figura 4. Saída publish_logs.py
Escrevendo o código de nossa pipeline
Agora que temos tudo preparado, podemos passar para a parte mais interessante — escrever o código da nossa pipeline, usando Beam e Python. Para criar uma pipeline Beam, precisamos criar um objeto de pipeline (p). Depois de criarmos o objeto de pipeline, podemos aplicar várias funções uma após a outra, usando o operador pipe (|). Em geral, o fluxo de trabalho se parece com a figura abaixo.
[Final Output PCollection] = ([Initial Input PCollection] | [First Transform]
             | [Second Transform]
             | [Third Transform])
No nosso código, criaremos duas funções personalizadas. A função regex_clean, que escaneia os dados e extrai a string correspondente com base na lista de PATTERNS, utilizando a função re.search. A função retorna uma string separada por vírgulas. Se você não for um especialista em expressões regulares, eu recomendo consultar este e praticar em um bloco de notas para testar o código. Após isso, definimos uma função ParDo personalizada chamada Split, que é uma variação da transformação Beam para processamento paralelo. Em Python, isso é feito de uma maneira específica — devemos criar uma classe que herda da classe DoFn Beam. A função Split recebe a string analisada da função anterior e retorna uma lista de dicionários com chaves correspondentes aos nomes das colunas na nossa tabela BigQuery. Há algo a se notar sobre esta função: eu tive que importar datetime dentro da função para que funcionasse. Eu recebia uma mensagem de erro ao importar no início do arquivo, o que era estranho. Esta lista é então passada para a função WriteToBigQuery, que simplesmente adiciona nossos dados na tabela. O código para Batch DataFlow Job e Streaming DataFlow Job está listado abaixo. A única diferença entre o código em lote e o código em streaming é que, no processamento em lote, lemos o CSV de src_path, utilizando a função ReadFromText da Beam.
Batch DataFlow Job (processamento em lote)
import apache_beam as beam
from apache_beam.options.pipeline_options import PipelineOptions
from google.cloud import bigquery
import re
import logging
import sys

PROJECT='user-logs-237110'
schema = 'remote_addr:STRING, timelocal:STRING, request_type:STRING, status:STRING, body_bytes_sent:STRING, http_referer:STRING, http_user_agent:STRING'


src_path = "user_log_fileC.txt"

def regex_clean(data):

    PATTERNS =  [r'(^S+.[S+.]+S+)s',r'(?<=[).+?(?=])',
           r'"(S+)s(S+)s*(S*)"',r's(d+)s',r"(?> beam.io.textio.ReadFromText(src_path)
      | "clean address" >> beam.Map(regex_clean)
      | 'ParseCSV' >> beam.ParDo(Split())
      | 'WriteToBigQuery' >> beam.io.WriteToBigQuery('{0}:userlogs.logdata'.format(PROJECT), schema=schema,
        write_disposition=beam.io.BigQueryDisposition.WRITE_APPEND)
   )

   p.run()

if __name__ == '__main__':
  logger = logging.getLogger().setLevel(logging.INFO)
  main()
Job de Streaming DataFlow (processamento em tempo real)
from apache_beam.options.pipeline_options import PipelineOptions
from google.cloud import pubsub_v1
from google.cloud import bigquery
import apache_beam as beam
import logging
import argparse
import sys
import re


PROJECT="user-logs-237110"
schema = 'remote_addr:STRING, timelocal:STRING, request_type:STRING, status:STRING, body_bytes_sent:STRING, http_referer:STRING, http_user_agent:STRING'
TOPIC = "projects/user-logs-237110/topics/userlogs"


def regex_clean(data):

    PATTERNS =  [r'(^S+.[S+.]+S+)s',r'(?<=[).+?(?=])',
           r'"(S+)s(S+)s*(S*)"',r's(d+)s',r"(?> beam.io.ReadFromPubSub(topic=TOPIC).with_output_types(bytes)
      | "Decode" >> beam.Map(lambda x: x.decode('utf-8'))
      | "Clean Data" >> beam.Map(regex_clean)
      | 'ParseCSV' >> beam.ParDo(Split())
      | 'WriteToBigQuery' >> beam.io.WriteToBigQuery('{0}:userlogs.logdata'.format(PROJECT), schema=schema,
        write_disposition=beam.io.BigQueryDisposition.WRITE_APPEND)
   )
   result = p.run()
   result.wait_until_finish()

if __name__ == '__main__':
  logger = logging.getLogger().setLevel(logging.INFO)
  main()
Execução do pipeline
Podemos executar o pipeline de várias maneiras diferentes. Se quiséssemos, poderíamos simplesmente executá-lo localmente a partir do terminal, acessando remotamente o GCP.
python -m main_pipeline_stream.py
 --input_topic "projects/user-logs-237110/topics/userlogs"
 --streaming
No entanto, vamos executá-lo usando o DataFlow. Podemos fazer isso com o comando abaixo, definindo os seguintes parâmetros obrigatórios.
projeto— ID do seu projeto GCP.runner— executável do pipeline que analisará seu programa e construirá seu pipeline. Para execução na nuvem, você deve indicar o DataflowRunner.staging_location— caminho para o armazenamento em nuvem do Cloud Dataflow para indexação dos pacotes de código necessários aos manipuladores que executam o trabalho.temp_location— caminho para o armazenamento em nuvem do Cloud Dataflow para armazenar arquivos temporários de trabalhos criados durante a execução do pipeline.streaming
python main_pipeline_stream.py
--runner DataFlow
--project $PROJECT
--temp_location $BUCKET/tmp
--staging_location $BUCKET/staging
--streaming
Enquanto este comando está sendo executado, podemos ir para a aba DataFlow no console do Google e visualizar nosso pipeline. Ao clicar no pipeline, devemos ver algo parecido com a figura 4. Para fins de depuração, pode ser muito útil acessar os logs e depois o Stackdriver para visualizar os logs detalhados. Isso me ajudou a resolver problemas com o pipeline em várias ocasiões.
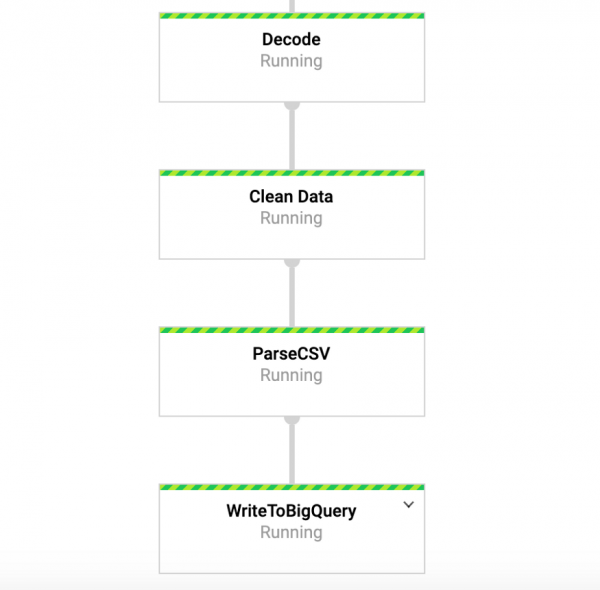
Figura 4: Pipeline Beam
Acessando nossos dados no BigQuery
Portanto, já devemos ter um pipeline em execução com dados sendo enviados para nossa tabela. Para verificar isso, podemos ir ao BigQuery e visualizar os dados. Após usar o comando abaixo, você deve ver as primeiras linhas do conjunto de dados. Agora que temos os dados armazenados no BigQuery, podemos realizar análises adicionais, além de compartilhar os dados com colegas e começar a responder às perguntas de negócios.
SELECT * FROM `user-logs-237110.userlogs.logdata` LIMIT 10; 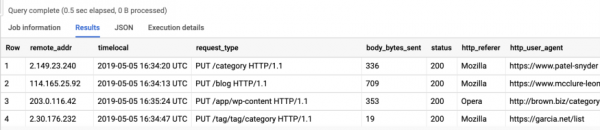
Figura 5: BigQuery
Conclusão
Esperamos que este post sirva como um exemplo útil de criação de um pipeline de dados em tempo real, bem como encontremos maneiras de tornar os dados mais acessíveis. Armazenar dados nesse formato nos proporciona muitas vantagens. Agora podemos começar a responder perguntas importantes, como quantas pessoas estão usando nosso produto? A base de usuários está crescendo ao longo do tempo? Quais aspectos do produto as pessoas mais interagem? E há erros onde não deveriam estar? Estas são perguntas que serão relevantes para a organização. Com base nas ideias que surgirem a partir das respostas a essas perguntas, poderemos aprimorar o produto e aumentar o engajamento dos usuários.
Beam é realmente útil para esse tipo de exercício e também tem uma série de outros casos de uso interessantes. Por exemplo, você pode analisar dados de ticks de ações em tempo real e fazer negociações com base na análise; talvez você tenha dados de sensores vindo de veículos e queira calcular o nível de tráfego. Você também pode, por exemplo, ser uma empresa de jogos coletando dados dos usuários e utilizando-os para criar painéis informativos para monitorar indicadores-chave. Bem, pessoal, esse já é um tema para outro post, obrigado pela leitura, e para aqueles que querem ver o código completo, abaixo está o link para o meu GitHub.
E isso é tudo. .
Fonte: habr.com
