

O kube-scheduler é um componente essencial do Kubernetes, responsável pelo agendamento de pods em nós de acordo com políticas definidas. Muitas vezes, durante a operação de um cluster Kubernetes, não pensamos em quais políticas estão sendo usadas para agendar os pods, uma vez que o conjunto de políticas padrão do kube-scheduler é adequado para a maioria das tarefas cotidianas. No entanto, existem situações em que precisamos gerenciar cuidadosamente o processo de distribuição de pods, e para isso existem duas abordagens:
- Criar um kube-scheduler com um conjunto de regras personalizado
- Escrever seu próprio scheduler e treiná-lo para trabalhar com as solicitações do servidor API
Neste artigo, descreverei a implementação do primeiro ponto para resolver o problema de agendamento desigual de pods em um de nossos projetos.
Uma breve introdução ao funcionamento do kube-scheduler
É importante destacar que o kube-scheduler não é responsável pelo agendamento direto dos pods — ele apenas determina qual nó deve hospedar um pod. Em outras palavras, o resultado do trabalho do kube-scheduler é o nome do nó que ele retorna ao servidor API em resposta à solicitação de agendamento, e com isso seu trabalho termina.
Primeiramente, o kube-scheduler compila uma lista de nós nos quais um pod pode ser agendado, de acordo com as políticas de predicates. Em seguida, cada nó dessa lista recebe uma pontuação com base nas políticas de priorites. Como resultado, é escolhido o nó que obteve a maior pontuação. Se houver nós com a mesma pontuação máxima, um deles é escolhido aleatoriamente. Você pode consultar a lista e a descrição das políticas de predicates (filtragem) e priorites (pontuação) em .
Descrição da origem do problema
Embora tenhamos um grande número de clusters Kubernetes sob nossa administração na Nixys, encontramos problemas de agendamento de pods apenas recentemente, quando um de nossos projetos exigiu a execução de um grande número de tarefas periódicas (~100 entidades CronJob). Para facilitar ao máximo a descrição do problema, tomemos como exemplo um microsserviço que executa uma tarefa cron a cada minuto, gerando alguma carga na CPU. Para a execução da tarefa cron, foram disponibilizados três nós idênticos em características (24 vCPU em cada um).
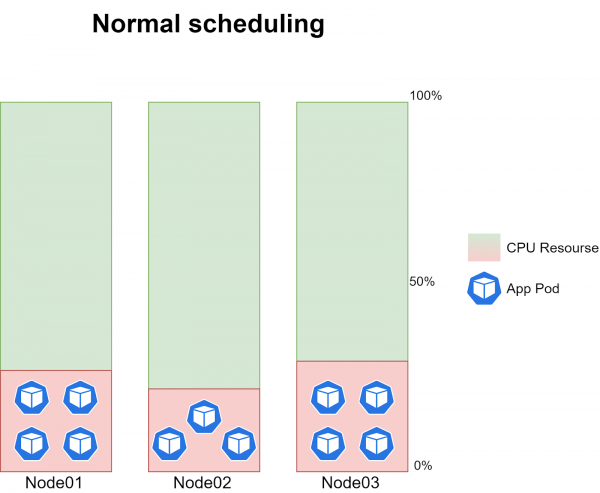
No entanto, não é possível afirmar com precisão quanto tempo levará a execução do CronJob, uma vez que o volume de dados de entrada está constantemente mudando. Em média, durante o funcionamento normal do kube-scheduler, em cada nó operam de 3 a 4 instâncias da tarefa, que geram cerca de 20-30% da carga no CPU de cada nó:
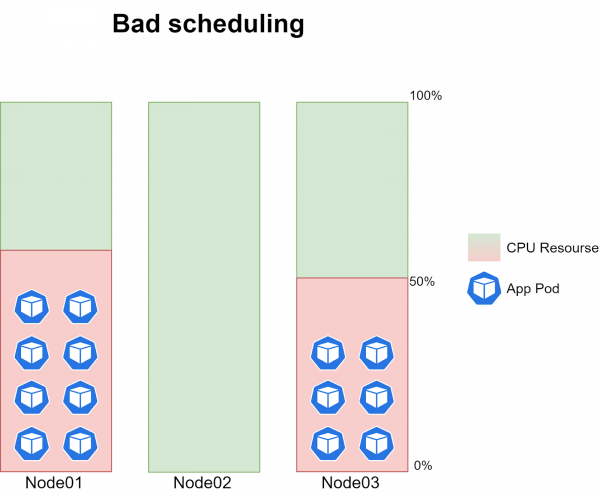
O problema em si é que, às vezes, os pods da tarefa cron deixavam de ser agendados em um dos três nós. Ou seja, em determinado momento, nenhum pod era agendado em um dos nós, enquanto nos outros dois nós operavam de 6 a 8 instâncias da tarefa, gerando cerca de 40-60% da carga no CPU:
O problema ocorria com uma periodicidade absolutamente aleatória e ocasionalmente correlacionava-se com o momento do lançamento de uma nova versão do código.
Ao aumentar o nível de log do kube-scheduler para 10 (-v=10), começamos a registrar quantos pontos cada um dos nós acumulava durante o processo de avaliação. Durante o funcionamento normal do agendamento, era possível ver as seguintes informações nos logs:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, capacidade 23900 millicores 67167186944 bytes de memória, requisição total 1387 millicores 4161694720 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, capacidade 23900 millicores 67167186944 bytes de memória, requisição total 1347 millicores 4444810240 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, capacidade 23900 millicores 67167186944 bytes de memória, requisição total 1387 millicores 4161694720 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, capacidade 23900 millicores 67167186944 bytes de memória, requisição total 1687 millicores 4790840320 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, capacidade 23900 millicores 67167186944 bytes de memória, requisição total 1347 millicores 4444810240 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, capacidade 23900 millicores 67167186944 bytes de memória, requisição total 1687 millicores 4790840320 bytes de memória, pontuação 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Pontuação: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Pontuação: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Pontuação: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Pontuação: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Pontuação: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Pontuação: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:781] Host Node01 -> Pontuação 100043
generic_scheduler.go:781] Host Node02 -> Pontuação 100043
generic_scheduler.go:781] Host Node03 -> Pontuação 100043
Ou seja, de acordo com as informações obtidas a partir dos logs, cada um dos nós acumulava a mesma quantidade de pontos finais e uma seleção aleatória era feita para o planejamento. No momento do planejamento problemático, os logs se apresentavam da seguinte forma:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, capacidade 23900 milicore 67167186944 bytes de memória, requisição total 1587 milicores 4581125120 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, capacidade 23900 milicore 67167186944 bytes de memória, requisição total 1087 milicores 3532549120 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, capacidade 23900 milicore 67167186944 bytes de memória, requisição total 1587 milicores 4581125120 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, capacidade 23900 milicore 67167186944 bytes de memória, requisição total 987 milicores 3322833920 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, capacidade 23900 milicore 67167186944 bytes de memória, requisição total 987 milicores 3322833920 bytes de memória, pontuação 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, capacidade 23900 milicore 67167186944 bytes de memória, requisição total 1087 milicores 3532549120 bytes de memória, pontuação 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Pontuação: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Pontuação: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Pontuação: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Pontuação: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Pontuação: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Pontuação: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Pontuação: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Pontuação: (10)
generic_scheduler.go:781] Host Node03 -> Pontuação 100041
generic_scheduler.go:781] Host Node02 -> Pontuação 100041
generic_scheduler.go:781] Host Node01 -> Pontuação 100038
O que se pode ver é que um dos nós obteve menos pontos finais do que os outros, e por isso o planejamento foi realizado apenas em dois nós, que obtiveram a maior pontuação. Assim, conseguimos confirmar que o problema está realmente no planejamento dos pods.
O próximo algoritmo de solução para o problema nos parecia óbvio — analisar os logs, entender qual prioridade fez com que o nó não obtivesse pontos e, se necessário, corrigir as políticas do kube-scheduler padrão. No entanto, aqui nos deparamos com duas dificuldades significativas:
- No nível máximo de registro (10) é representado um conjunto de pontos apenas para algumas prioridades. No trecho de log acima, é possível notar que, para todas as prioridades refletidas nos logs, os nós obtêm a mesma quantidade de pontos tanto no planejamento normal quanto no problemático, porém o resultado final em caso de planejamento problemático é diferente. Assim, pode-se concluir que para algumas prioridades a contagem de pontos ocorre 'nos bastidores', e não temos nenhuma maneira de entender qual prioridade fez com que o nó não obtivesse pontos. Este problema foi descrito em detalhes no repositório Kubernetes no Github. No momento da redação deste artigo, recebemos uma resposta dos desenvolvedores, informando que o suporte à gravação de logs será adicionado nas atualizações do Kubernetes v1.15, 1.16 e 1.17.
- Não há uma maneira simples de entender com qual conjunto de políticas o kube-scheduler está trabalhando atualmente. Sim, esta lista é enumerada, mas não contém informações sobre quais pesos específicos foram aplicados a cada uma das políticas de prioridade. Ver os pesos ou editar as políticas do kube-scheduler padrão só pode ser feito em Vale ressaltar que, uma vez conseguimos registrar que o nó não obteve pontos com a política ImageLocalityPriority, que concede pontos ao nó se já houver uma imagem necessária para executar o aplicativo. Ou seja, no momento da implementação da nova versão do aplicativo, a tarefa cron conseguia ser iniciada em dois nós, baixando a nova imagem do registro docker, e assim os dois nós obtinham uma pontuação final maior em relação ao terceiro. .
Vale a pena mencionar que, em uma ocasião, conseguimos registrar que o nó não somava pontos de acordo com a política ImageLocalityPriority, que credita pontos ao nó se já houver uma imagem necessária para a execução do aplicativo. Ou seja, no momento da implementação de uma nova versão do aplicativo, a tarefa cron conseguia ser executada em dois nós, baixando uma nova imagem do docker registry, e, assim, os dois nós recebiam uma pontuação final maior em relação ao terceiro.
Como mencionei acima, nos logs não vemos informações sobre a avaliação da política ImageLocalityPriority, portanto, para verificar minha suposição, enviamos a imagem com a nova versão do aplicativo para o terceiro nó, após o que o agendamento funcionou corretamente. Foi exatamente devido à política ImageLocalityPriority que o problema de agendamento foi observado com pouca frequência, sendo mais comum que estivesse relacionado a outra questão. Como não conseguimos depurar completamente cada uma das políticas na lista de prioridades do kube-scheduler padrão, surgiu a necessidade de uma gestão flexível das políticas de agendamento dos pods.
Formulação do problema
Queríamos que a solução do problema fosse o mais pontual possível, ou seja, as principais entidades do Kubernetes (refiro-me ao kube-scheduler padrão) deveriam permanecer inalteradas. Não queríamos resolver um problema em um lugar e criá-lo em outro. Assim, chegamos a duas opções de solução para o problema, que foram mencionadas na introdução do artigo — criar um scheduler adicional ou escrever o nosso próprio. O principal requisito para o agendamento de tarefas cron é a distribuição uniforme da carga entre os três nós. Este requisito pode ser atendido pelas políticas já existentes do kube-scheduler, portanto, não faz sentido escrever nosso próprio scheduler para resolver a nossa tarefa.
As instruções para a criação e o Deployment do kube-scheduler adicional estão descritas em . No entanto, achamos que as entidades Deployment não são suficientes para garantir a alta disponibilidade de um serviço tão crítico quanto o kube-scheduler, então decidimos implantar um novo kube-scheduler como um Pod Estático, que será supervisionado diretamente pelo Kubelet. Assim, temos os seguintes requisitos para o novo kube-scheduler:
- O serviço deve ser implantado como um Pod Estático em todos os mestres do cluster
- Deve haver uma previsão de alta disponibilidade em caso de inatividade do Pod ativo com o kube-scheduler
- O principal critério ao agendar deve ser a quantidade de recursos disponíveis no nó (LeastRequestedPriority)
Implementação da solução
Vale destacar que todos os trabalhos serão realizados no Kubernetes v1.14.7, pois esta versão foi utilizada no projeto. Começaremos escrevendo o manifesto para o nosso novo kube-scheduler. Tomaremos como base o manifesto padrão (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) e o adaptaremos para a seguinte forma:
kind: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  name: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        name: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Resumo das principais mudanças:
- Mudamos o nome do pod e do contêiner para kube-scheduler-cron
- Especificamos o uso das portas 10151 e 10159, pois a opção foi definida
hostNetwork: truee não podemos usar as mesmas portas que o kube-scheduler padrão (10251 e 10259) - Usando o parâmetro --config, especificamos o arquivo de configuração com o qual o serviço deve ser iniciado
- Configuramos o montante do arquivo de configuração (scheduler-custom.conf) e do arquivo de políticas de agendamento (scheduler-custom-policy-config.json) a partir do host
Não podemos esquecer que nosso kube-scheduler precisará de permissões semelhantes às do padrão. Editamos seu papel de cluster:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Agora vamos falar sobre o que deve estar contido no arquivo de configuração e no arquivo com as políticas de agendamento:
- Arquivo de configuração (scheduler-custom.conf)
Para obter a configuração do kube-scheduler padrão, é necessário usar o parâmetro--write-config-todo . A configuração obtida será colocada no arquivo /etc/kubernetes/scheduler-custom.conf e será apresentada da seguinte forma:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Resumo das principais mudanças:
- Definimos o nome do nosso serviço kube-scheduler-cron na schedulerName.
- No parâmetro
lockObjectName, também precisamos definir o nome do nosso serviço e garantir que o parâmetroleaderElectestá definido como true (caso você tenha apenas um nó mestre, pode definir como false). - Especificamos o caminho para o arquivo que descreve as políticas de agendamento no parâmetro
algorithmSource.
É necessário focar mais detalhadamente no segundo ponto, onde editamos os parâmetros da chave leaderElection. Para garantir a alta disponibilidade, ativamos (leaderElect) o processo de eleição de líder (mestre) entre os pods do nosso kube-scheduler utilizando um endpoint único para eles (resourceLock) chamado kube-scheduler-cron (lockObjectName) no namespace kube-system (lockObjectNamespace). Para mais informações sobre como o Kubernetes garante a alta disponibilidade dos principais componentes (incluindo o kube-scheduler), você pode consultar .
- O arquivo de políticas de agendamento (scheduler-custom-policy-config.json)
Como já mencionei anteriormente, para descobrir quais políticas específicas o kube-scheduler padrão utiliza, devemos analisar seu código. Isso significa que não podemos obter um arquivo com as políticas de agendamento do kube-scheduler padrão, como fazemos com o arquivo de configuração. Vamos descrever as políticas de agendamento de interesse no arquivo /etc/kubernetes/scheduler-custom-policy-config.json da seguinte forma:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Assim, o kube-scheduler primeiro cria uma lista de nós onde o pod pode ser agendado, de acordo com a política GeneralPredicates (que inclui um conjunto de políticas como PodFitsResources, PodFitsHostPorts, HostName e MatchNodeSelector). Em seguida, avalia cada nó de acordo com um conjunto de políticas no array de prioridades. Para atender aos requisitos da nossa tarefa, consideramos que esse conjunto de políticas seria a solução ideal. Lembro que o conjunto de políticas e suas descrições detalhadas estão disponíveis em . Para cumprir sua tarefa, você pode simplesmente alterar o conjunto de políticas utilizadas e atribuir pesos adequados a elas.
O manifesto do novo kube-scheduler que criamos no início do capítulo será chamado kube-scheduler-custom.yaml e será colocado no seguinte caminho /etc/kubernetes/manifests em três nós mestres. Se tudo for feito corretamente, o Kubelet em cada nó iniciará o pod e nos logs do nosso novo kube-scheduler veremos informações de que nosso arquivo de políticas foi aplicado com sucesso:
Criando scheduler a partir da configuração: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Registrando predicado: GeneralPredicates
Tipo de predicado GeneralPredicates já registrado, reutilizando.
Registrando prioridade: ServiceSpreadingPriority
Tipo de prioridade ServiceSpreadingPriority já registrado, reutilizando.
Registrando prioridade: EqualPriority
Tipo de prioridade EqualPriority já registrado, reutilizando.
Registrando prioridade: LeastRequestedPriority
Tipo de prioridade LeastRequestedPriority já registrado, reutilizando.
Registrando prioridade: NodePreferAvoidPodsPriority
Tipo de prioridade NodePreferAvoidPodsPriority já registrado, reutilizando.
Registrando prioridade: NodeAffinityPriority
Tipo de prioridade NodeAffinityPriority já registrado, reutilizando.
Criando scheduler com predicados de ajuste 'map[GeneralPredicates:{}]' e funções de prioridade 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Agora, só resta especificar no spec da nossa CronJob que todas as solicitações de agendamento de seus pods devem ser tratadas pelo nosso novo kube-scheduler:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Conclusão
No final, obtivemos um kube-scheduler adicional com um conjunto único de políticas de agendamento, cuja operação é monitorada diretamente pelo kubelet. Além disso, configuramos a eleição de um novo líder entre os pods do nosso kube-scheduler caso o antigo líder se torne indisponível por algum motivo.
Os aplicativos e serviços comuns continuam a ser agendados pelo kube-scheduler padrão, enquanto todas as tarefas cron foram completamente transferidas para o novo. A carga gerada pelas tarefas cron agora é distribuída uniformemente por todos os nós. Considerando que a maioria das tarefas cron é executada nos mesmos nós que os principais aplicativos do projeto, isso permitiu reduzir significativamente o risco de migração de pods devido à falta de recursos. Após a implementação de um kube-scheduler adicional, não houve mais problemas com agendamento desigual das tarefas cron.
Leia também outros artigos em nosso blog:
Fonte: habr.com
