

Olá a todos! Meu nome é Kirill, sou o CTO da Adapty. A maior parte da nossa arquitetura está na AWS, e hoje vou falar sobre como reduzimos os custos com servidores em 3 vezes usando instâncias spot em nosso ambiente de produção, bem como sobre como configurar a escalabilidade automática. Primeiro, haverá uma visão geral de como isso funciona, seguida de um guia detalhado de como implementar.
O que são instâncias spot?
instâncias são servidores de outros usuários da AWS que estão ociosos no momento, e eles os vendem com um grande desconto (a Amazon menciona até 90%, mas com base na nossa experiência é cerca de 3x, variando de acordo com a região, AZ e tipo de instância). A principal diferença em relação às instâncias normais é que elas podem ser desligadas a qualquer momento. Por muito tempo, acreditamos que era aceitável usá-las para ambientes de desenvolvimento ou para tarefas que requerem cálculos, salvando resultados intermediários no S3 ou em um banco de dados, mas não para produção. Existem soluções de terceiros que permitem usar spot em produção, mas no nosso caso, elas têm muitas limitações, portanto não as implementamos. O método descrito neste artigo funciona totalmente dentro das funcionalidades padrão da AWS, sem scripts adicionais, cron jobs, etc.
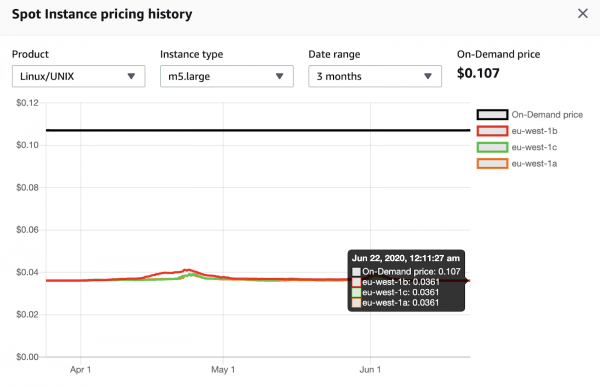
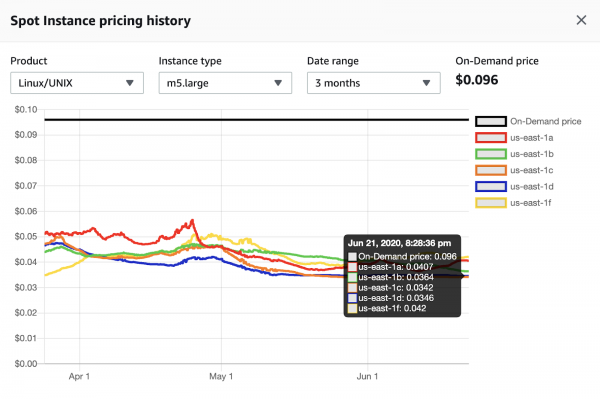
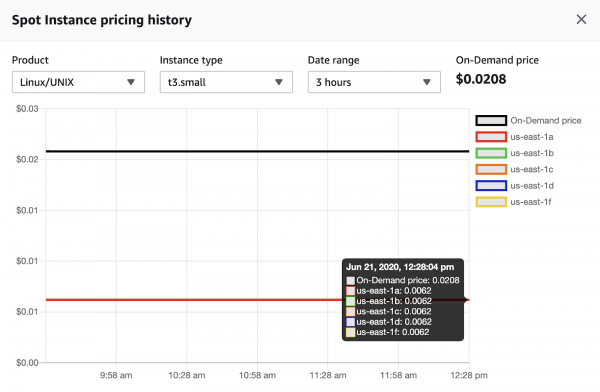
A seguir, apresento algumas capturas de tela que mostram a história dos preços das instâncias spot.
m5.large na região eu-west-1 (Irlanda). O preço é predominantemente estável ao longo de 3 meses, atualmente com uma economia de 2.9x.
m5.large na região us-east-1 (N. Virginia). O preço varia constantemente ao longo de 3 meses, atualmente com uma economia de 2.3x a 2.8x dependendo da zona de disponibilidade.
t3.small na região us-east-1 (N. Virginia). O preço é estável ao longo de 3 meses, atualmente com uma economia de 3.4x.
Arquitetura do serviço
A arquitetura básica do serviço que iremos discutir neste artigo está representada no diagrama abaixo.
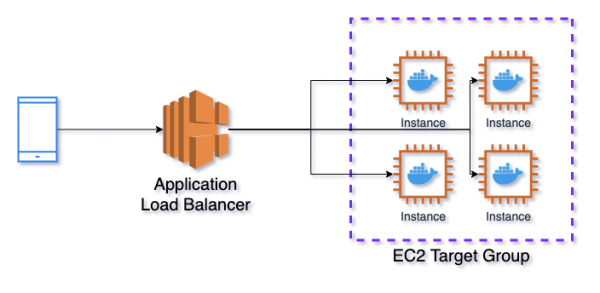
Application Load Balancer → EC2 Target Group → Elastic Container Service
O Application Load Balancer (ALB) é usado como balanceador, que direciona as requisições para o EC2 Target Group (TG). O TG é responsável por abrir portas nas instâncias para o ALB e vinculá-las às portas dos contêineres do Elastic Container Service (ECS). O ECS é análogo ao Kubernetes na AWS, que gerencia contêineres Docker.
Em uma instância, pode haver vários contêineres em execução com as mesmas portas, portanto, não podemos defini-las de forma fixa. O ECS informa ao TG que está iniciando uma nova tarefa (o que na terminologia do Kubernetes é chamado de pod), e ele verifica as portas disponíveis na instância e designa uma delas para a tarefa a ser iniciada. Além disso, o TG verifica regularmente se a instância e a API nela estão funcionando por meio de checagens de saúde e, se notar algum problema, para de redirecionar solicitações para lá.
Grupos de Auto Scaling do EC2 + Provedores de Capacidade do ECS
O serviço Grupos de Auto Scaling do EC2 (ASG) não está mostrado no diagrama acima. Pelo nome, pode-se entender que ele é responsável pela escalabilidade das instâncias. Até recentemente, a AWS não tinha um recurso integrado para gerenciar o número de máquinas em execução a partir do ECS. O ECS permitia escalar o número de tarefas, por exemplo, com base no uso de CPU, RAM ou no número de solicitações. Mas se as tarefas ocupassem todas as instâncias disponíveis, novas máquinas não seriam automaticamente iniciadas.
Isso mudou com a introdução dos Provedores de Capacidade do ECS (ECS CP). Agora, cada serviço no ECS pode ser vinculado a um ASG, e se as tarefas não cabem nas instâncias em execução, novas serão iniciadas (mas dentro dos limites estabelecidos do ASG). Isso também funciona ao contrário; se o ECS CP identificar instâncias ociosas sem tarefas, ele dará a ordem ao ASG para desligá-las. O ECS CP tem a capacidade de especificar uma porcentagem de utilização alvo das instâncias, de modo que um certo número de máquinas esteja sempre disponível para uma rápida escalabilidade das tarefas, falarei sobre isso um pouco mais tarde.
Modelos de Lançamento do EC2
O último serviço que irei apresentar, antes de passar à descrição detalhada da criação desta infraestrutura, são os Modelos de Lançamento do EC2. Ele permite criar um modelo pelo qual todas as máquinas serão iniciadas, para não ter que repetir isso do zero a cada vez. Aqui você pode escolher o tipo de máquina a ser iniciada, grupo de segurança, imagem de disco e muitos outros parâmetros. Também é possível especificar dados personalizados que serão carregados em todas as instâncias iniciadas. Nos dados personalizados, você pode executar scripts, por exemplo, pode editar o conteúdo do arquivo .
Um dos parâmetros de configuração mais importantes neste artigo é =true. Se este parâmetro estiver ativado, assim que o ECS receber o sinal de que a instância spot está sendo removida, ele muda o status de todas as tarefas que estão sendo executadas nela para Draining. Nenhuma nova tarefa será designada para esta instância; se houver tarefas que desejam ser implantadas nela, elas serão canceladas. As solicitações do balanceador de carga também deixarão de chegar. A notificação de remoção da instância chega 2 minutos antes do evento real. Portanto, se seu serviço não executar tarefas por mais de 2 minutos e não salvar nada no disco, você pode usar instâncias spot sem perda de dados.
Quanto ao disco — a AWS recentemente possível o uso do Elastic File System (EFS) junto com o ECS, com esse esquema nem mesmo o disco é um obstáculo, mas não tentamos isso, já que, em princípio, não precisamos de um disco para armazenar estado. Por padrão, após receber SIGINT (enviado no momento em que a tarefa muda para o status Draining), todas as tarefas em execução serão paradas em 30 segundos, mesmo que não tenham sido concluídas; esse tempo pode ser alterado usando o parâmetro . O importante é não definir mais que 2 minutos para máquinas spot.
Criação de serviço
Vamos passar diretamente à criação do serviço descrito. No processo, descreverei alguns pontos adicionais úteis que não foram mencionados acima. Em geral, esta é uma instrução passo a passo, mas algumas situações muito básicas ou, pelo contrário, muito específicas não serão abordadas. Todas as ações são realizadas no console visual da AWS, mas podem ser reproduzidas programaticamente usando CloudFormation ou Terraform. Na Adapty usamos Terraform.
Modelo de Inicialização EC2
Neste serviço, é criada uma configuração de máquinas que serão utilizadas. A gestão dos modelos é feita na seção EC2 -> Instances -> Launch templates.
Imagem de máquina da Amazon (AMI) — especificamos a imagem do disco com a qual todas as instâncias serão iniciadas. Para o ECS, na maioria dos casos, deve-se usar a imagem otimizada da Amazon. Ela é atualizada regularmente e contém tudo o que é necessário para o funcionamento do ECS. Para saber o ID atual da imagem, vamos à página , escolhemos a região utilizada e copiamos o ID da AMI para ela. Por exemplo, para a região us-east-1, o ID atual no momento da redação deste artigo é ami-00c7c1cf5bdc913ed. Este ID deve ser inserido no item Especificar um valor personalizado.
Tipo de instância — indicamos o tipo de instância. Escolha aquele que melhor se adapta à sua tarefa.
Par de chaves (login) — indicamos o certificado que permite a conexão com a instância via SSH, se necessário.
Configurações de rede — indicamos os parâmetros da rede. Plataforma de rede na maioria dos casos deve ser a Virtual Private Cloud (VPC). Grupos de segurança — grupos de segurança para suas instâncias. Como iremos usar um balanceador na frente das instâncias, recomendo indicar aqui um grupo que permita conexões de entrada apenas do balanceador. Ou seja, você terá 2 grupos de segurança, um para o balanceador, que permite conexões de entrada (inbound) de qualquer lugar nas portas 80 (http) e 443 (https), e o segundo para as máquinas, que permite conexões de entrada em quaisquer portas do grupo do balanceador. Conexões de saída (outbound) em ambos os grupos devem ser liberadas via protocolo TCP em todas as portas para todos os endereços. É possível restringir as portas e endereços para conexões de saída, mas isso requer monitoramento constante para garantir que você não esteja tentando acessar uma porta fechada.
Armazenamento (volumes) — indicamos os parâmetros dos discos para as máquinas. O volume do disco não pode ser menor do que o especificado na AMI, para ECS Optimized — 30 GiB.
Detalhes avançados — indicamos parâmetros adicionais.
Opção de compra — se queremos comprar instâncias spot. Queremos, mas não marcaremos esta opção aqui, configuraremos isso no Auto Scaling Group, onde há mais opções.
Perfil de instância IAM — indicamos a função com a qual as instâncias serão iniciadas. Para que as instâncias funcionem no ECS, elas precisam de permissões que normalmente estão na função ecsInstanceRole. Em alguns casos, ela pode ser criada; se não, veja aqui como fazer isso. Após a criação, indicamos isso no template.
Em seguida, existem muitos parâmetros, na maioria das vezes, pode-se deixar os valores padrão, mas cada um deles tem uma descrição clara. Eu sempre incluo os parâmetros de instância EBS-optimized e T2/T3 Unlimited, se forem utilizados instâncias.
Dados do usuário — indicamos os dados do usuário. Iremos editar o arquivo /etc/ecs/ecs.config, que contém a configuração do agente ECS.
Exemplo de como os dados do usuário podem parecer:
#!/bin/bash
echo ECS_CLUSTER=DemoApiClusterProd >> /etc/ecs/ecs.config
echo ECS_ENABLE_SPOT_INSTANCE_DRAINING=true >> /etc/ecs/ecs.config
echo ECS_CONTAINER_STOP_TIMEOUT=1m >> /etc/ecs/ecs.config
echo ECS_ENGINE_AUTH_TYPE=docker >> /etc/ecs/ecs.config
echo "ECS_ENGINE_AUTH_DATA={"registry.gitlab.com":{"username":"username","password":"password"}}" >> /etc/ecs/ecs.config
ECS_CLUSTER=DemoApiClusterProd — o parâmetro indica que a instância pertence a um cluster com o nome especificado, ou seja, esse cluster poderá alocar suas tarefas neste servidor. Ainda não criamos um cluster, mas ao criá-lo, usaremos este nome.
ECS_ENABLE_SPOT_INSTANCE_DRAINING=true — o parâmetro indica que, ao receber um sinal de desligamento de uma instância spot, todas as tarefas nela devem ser transferidas para o estado Draining.
ECS_CONTAINER_STOP_TIMEOUT=1m — o parâmetro indica que, após receber o sinal SIGINT, todas as tarefas têm 1 minuto antes de serem encerradas.
ECS_ENGINE_AUTH_TYPE=docker — o parâmetro indica que o esquema de autorização utilizado é o docker.
ECS_ENGINE_AUTH_DATA=... — parâmetros de conexão para um registro de containers privado, onde suas imagens Docker são armazenadas. Se for público, não é necessário especificar nada.
Neste artigo, utilizarei uma imagem pública do Docker Hub, portanto, não é necessário especificar parâmetros. ECS_ENGINE_AUTH_TYPE e ECS_ENGINE_AUTH_DATA não é necessário.
É útil saber: é recomendável atualizar regularmente a AMI, pois, em novas versões, as versões do Docker, Linux, agente ECS, etc., são atualizadas. Para não esquecer disso, você pode sobre o lançamento de novas versões. Você pode receber notificações por e-mail e atualizar manualmente, ou pode escrever uma função Lambda que criará automaticamente uma nova versão do Launch Template com a AMI atualizada.
Grupo de Auto Scaling EC2
O grupo de Auto Scaling é responsável por iniciar e dimensionar instâncias. O gerenciamento dos grupos é feito na seção EC2 -> Auto Scaling -> Grupos de Auto Scaling.
Template de Lançamento — selecionamos o template criado na etapa anterior. Mantemos a versão padrão.
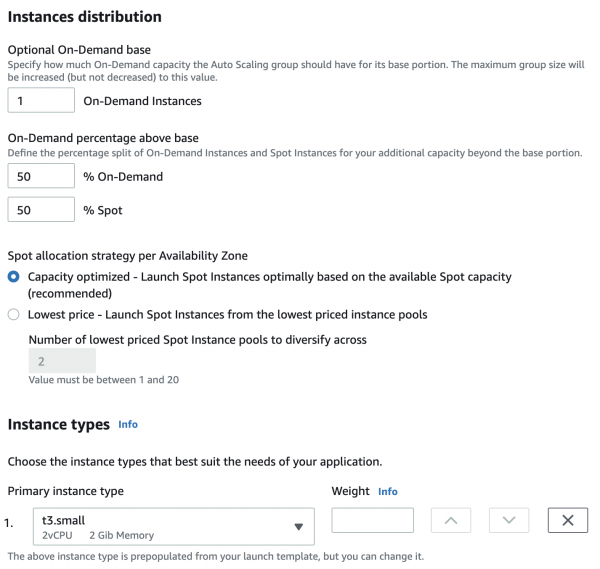
Opções de compra e tipos de instância — especificamos os tipos de instâncias para o cluster. Aderir ao template de lançamento usa o tipo de instância do Launch Template. Combinar opções de compra e tipos de instância permite configurar os tipos de instâncias de forma flexível. Usaremos esta opção.
Base On-Demand Opcional — o número de instâncias normais, não spot, que sempre estarão em funcionamento.
Percentual On-Demand acima da base — a proporção percentual de instâncias normais para instâncias spot, 50-50 distribuirá igualmente, 20-80 fará com que, para cada instância normal, sejam levantadas 4 instâncias spot. Neste exemplo, indicarei 50-50, mas na realidade frequentemente utilizamos 20-80, em alguns casos 0-100.
Tipos de instância — aqui você pode especificar tipos adicionais de instâncias que serão utilizadas no cluster. Nunca utilizamos isso, pois não entendo muito o sentido dessa história. Talvez esteja relacionado a limites em tipos específicos de instâncias, mas eles são aumentados facilmente pelo suporte. Se você sabe como isso se aplica, ficarei feliz em ler nos comentários)
Rede — configurações de rede, você escolhe o VPC e as sub-redes para as máquinas; na maioria das vezes, é melhor selecionar todas as sub-redes disponíveis.
Balanceamento de carga — configurações do balanceador, mas faremos isso separadamente, aqui não alteramos nada. Verificações de saúde também serão configuradas mais tarde.
Tamanho do grupo — especificamos limites para o número de máquinas no cluster e o número desejado de máquinas na inicialização. O número de máquinas no cluster nunca será menor do que o mínimo especificado e maior do que o máximo, mesmo que as métricas sinalizem que a escalabilidade deve ocorrer.
Políticas de escalonamento — parâmetros de escalonamento, mas iremos escalar com base nas tarefas ECS em execução, então configuraremos o escalonamento mais tarde.
Proteção de escala de instâncias — proteção contra exclusão de instâncias durante o escalonamento para baixo. Ativamos isso para que o ASG não remova a máquina que está executando tarefas. Desativar a proteção para instâncias sem tarefas será feito pelo ECS Capacity Provider.
Adicionar tags — você pode especificar tags para instâncias (para isso, a opção Tag new instances deve estar marcada). Recomendo usar a tag Name, assim todas as instâncias que são iniciadas dentro do grupo terão o mesmo nome, facilitando a visualização no console.
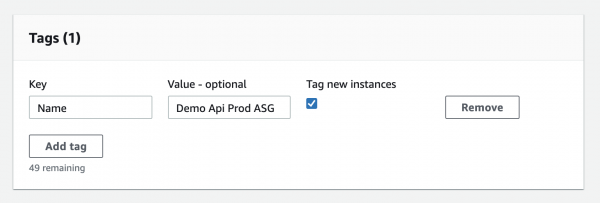
Após criar o grupo, abra-o e acesse a seção Configurações Avançadas, pois na fase de criação nem todas as opções estão visíveis no console.
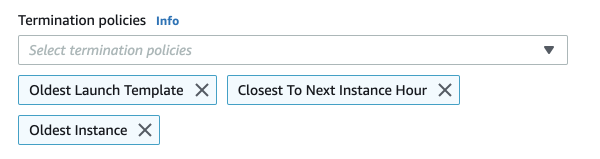
Políticas de terminação — regras consideradas ao remover instâncias. Elas são aplicadas em ordem. Geralmente, usamos aquelas mostradas na imagem abaixo. Primeiro, removemos instâncias com o Launch Template mais antigo (por exemplo, se atualizarmos o AMI, uma nova versão será criada, mas todas as instâncias já terão mudado para ela). Depois, escolhemos as instâncias que estão mais próximas do próximo horário de cálculo faturável. Em seguida, selecionamos as mais antigas pela data de lançamento.
É útil saber: para atualizar todas as máquinas no cluster, é conveniente usar . Se você combinar isso com a função Lambda da etapa anterior, terá um sistema de atualização de instâncias completamente automatizado. Antes de atualizar todas as máquinas, é necessário desativar a proteção de escala de instância para todas as instâncias no grupo. Não a configuração no grupo, mas sim a proteção das próprias máquinas, isso é feito na aba de gerenciamento de instâncias.
Application Load Balancer e EC2 Target Group
O balanceador é criado na seção EC2 → Load Balancing → Load Balancers. Usaremos o Application Load Balancer; uma comparação dos diferentes tipos de balanceadores pode ser lida na .
Listeners — faz sentido criar as portas 80 e 443 e fazer o redirecionamento de 80 para 443 mais tarde, usando regras do balanceador.
Availability Zones — na maioria dos casos, escolhemos todas as zonas de disponibilidade.
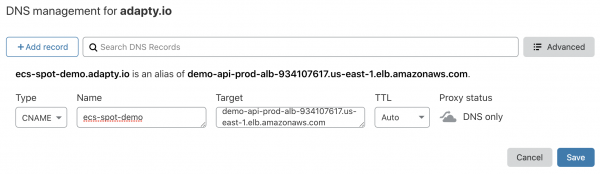
Configure Security Settings — aqui é indicado o certificado SSL para o balanceador, a opção mais conveniente é no ACM. As diferenças Security Policy podem ser lidas em , pode-se deixar o selecionado por padrão ELBSecurityPolicy-2016-08. Após criar o balanceador, você verá seu DNS name, para o qual é necessário configurar um CNAME para seu domínio. Por exemplo, assim é como aparece no Cloudflare.
Security Group — criamos ou escolhemos um grupo de segurança para o balanceador; mais detalhes sobre isso foram escritos um pouco acima na seção EC2 Launch Template → Configurações de rede.
Target group — criamos um grupo que é responsável pelo roteamento de solicitações do balanceador para as máquinas e verifica sua disponibilidade, para substituí-las em caso de problemas. Target type deve ser Instance, Protocol e Porta qualquer um, se você estiver usando HTTPS para a comunicação entre o balanceador e as instâncias, então deverá carregar o certificado nelas. Neste exemplo, não faremos isso, apenas deixaremos a porta 80.
Verificações de saúde — parâmetros de verificação de integridade do serviço. No serviço real, isso deve ser uma solicitação separada, que implementa partes importantes da lógica de negócios; neste exemplo, deixarei as configurações padrão. Em seguida, pode-se escolher o intervalo de solicitações, o tempo de espera, códigos de resposta bem-sucedidos, etc. No nosso exemplo, indicaremos códigos de sucesso de 200-399, porque a imagem do Docker que será utilizada retorna o código 304.
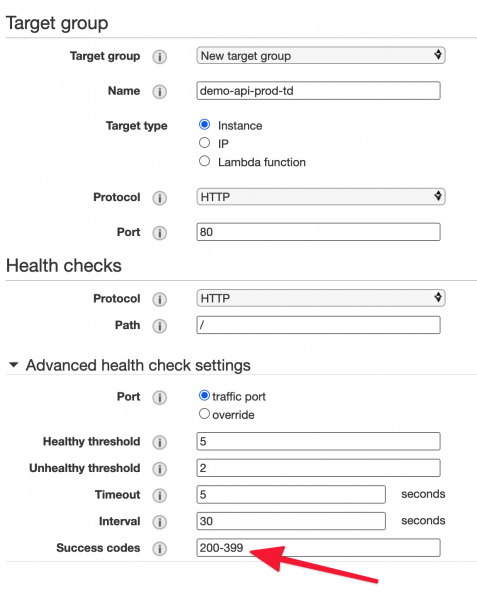
Register Targets — aqui são escolhidas as máquinas para o grupo, mas neste caso isso será gerenciado pelo ECS, portanto, apenas pulamos esta etapa.
É útil saber: no nível do balanceador, você pode ativar logs que serão salvos no S3 em um determinado . A partir daí, você pode exportá-los para serviços externos de análise ou fazer consultas SQL diretamente nos dados no S3 com . Isso é conveniente e funciona sem nenhum código adicional. Também recomendo configurar a exclusão de logs do bucket S3 após um período de tempo definido.
Definição de Tarefa ECS
Nas etapas anteriores, criamos tudo o que está relacionado à infraestrutura do serviço, agora passamos para a descrição dos contêineres que iremos executar. Isso é feito na seção ECS → Definições de Tarefa.
Compatibilidade do tipo de inicialização — escolhemos EC2.
Função IAM de execução da tarefa — selecionamos ecsTaskExecutionRole. Com ela, os logs são escritos, o acesso a variáveis secretas é concedido, entre outros.
Na seção Definições de Contêiner, clique em Adicionar Contêiner.
Imagem — o link para a imagem com o código do projeto, neste exemplo, usarei uma imagem pública do Docker Hub .
Limites de Memória — limites de memória para o contêiner. Limite Rigoroso — limite rigoroso, se o contêiner ultrapassar o valor especificado, o comando docker kill será executado, o contêiner morrerá imediatamente. Limite Suave — limite suave, o contêiner pode ultrapassar o valor especificado, mas ao alocar tarefas para as máquinas, esse parâmetro será considerado. Por exemplo, se a máquina tem 4 GiB de memória RAM e o limite suave do contêiner é 2048 MiB, então no máximo 2 tarefas podem ser executadas nessa máquina com esse contêiner. Na realidade, 4 GiB de RAM é um pouco menos que 4096 MiB, isso pode ser verificado na aba Instâncias ECS no cluster. O limite suave não pode ser maior que o limite rigoroso. É importante entender que se uma tarefa tiver vários contêineres, seus limites são somados.
Mapeamentos de Porta — em Porta do Host definimos 0, isso significa que a porta será designada dinamicamente, ela será monitorada pelo Target Group. Porta do Contêiner — a porta na qual seu aplicativo está executando, frequentemente definida no comando de execução ou designada no código do seu aplicativo, Dockerfile etc. Para o nosso exemplo, usaremos 3000, pois está especificado no imagem utilizada.
Verificação de integridade — parâmetros para verificar a operabilidade do contêiner, não confundir com a configuração no Target Group.
Ambiente — configurações do ambiente. unidades de CPU — semelhante aos limites de memória, mas sobre o processador. Cada núcleo do processador representa 1024 unidades, então se o servidor tiver um processador de dois núcleos e o contêiner tiver um valor de 512, será possível executar 4 tarefas com esse contêiner em um único servidor. As unidades de CPU sempre correspondem ao número de núcleos, não pode haver um número ligeiramente menor, como acontece com a memória.
Comando — comando para iniciar o serviço dentro do contêiner, todos os parâmetros são especificados por vírgula. Isso pode ser gunicorn, npm, etc. Se não for especificado, o valor da diretiva CMD do Dockerfile será utilizado. Especificamos npm,start.
Variáveis de ambiente — variáveis de ambiente do contêiner. Podem ser tanto dados de texto simples, quanto variáveis secretas do ou .
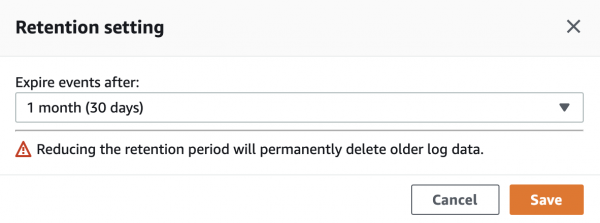
Armazenamento e Registro — aqui configuraremos o registro no CloudWatch Logs (serviço de logs da AWS). Para isso, basta marcar a opção Auto-configure CloudWatch Logs. Após criar a Task Definition, um grupo de logs será criado automaticamente no CloudWatch. Por padrão, os logs são armazenados indefinidamente, recomendo alterar o Retention period de Never Expire para o período desejado. Isso pode ser feito em CloudWatch Log groups, clicando no período atual e escolhendo um novo.
ECS Cluster e ECS Capacity Provider
Vamos para a seção ECS → Clusters para criar um cluster. Como modelo, escolhemos EC2 Linux + Networking.
Nome do cluster — é muito importante, aqui fazemos o mesmo nome que está indicado no Launch Template na parámetro ECS_CLUSTER, no nosso caso — DemoApiClusterProd. Marque a opção Create an empty cluster. Opcionalmente, você pode habilitar o Container Insights para visualizar métricas dos serviços no CloudWatch. Se tudo foi feito corretamente, na seção ECS Instances, você verá as máquinas que foram criadas no Auto Scaling group.
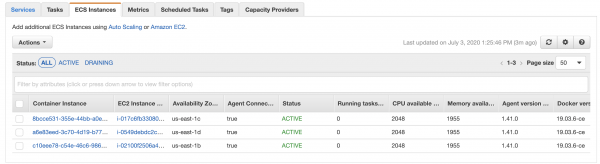
Vamos para a guia Capacity Providers e criamos um novo. Lembro que ele é necessário para gerenciar a criação e desligamento de máquinas, dependendo do número de tarefas ECS em execução. É importante notar que o provedor pode estar vinculado apenas a um único grupo.
Auto Scaling group — escolhemos o grupo criado anteriormente.
Escalonamento gerenciado — habilitamos para que o provedor possa escalar o serviço.
Capacidade alvo % — qual porcentagem de carga das máquinas precisamos para as tarefas. Se especificar 100%, todas as máquinas estarão sempre ocupadas com tarefas em execução. Se especificar 50%, metade das máquinas estará sempre livre. Nesse caso, se ocorrer um pico repentino na carga, novos táxis serão imediata e automaticamente alocados nas máquinas livres, sem necessidade de aguardar a implantação de instâncias.
Proteção de terminação gerenciada — ativamos, este parâmetro permite que o provedor remova a proteção das instâncias contra a exclusão. Isso acontece quando não há tarefas ativas na máquina e permite a capacidade alvo %.
Serviço ECS e configuração de escalonamento
Última etapa :) Para criar um serviço, é necessário acessar o cluster criado anteriormente na aba Serviços.
Tipo de lançamento — é necessário clicar em Alternar para a estratégia de provedor de capacidade e escolher o provedor criado anteriormente.
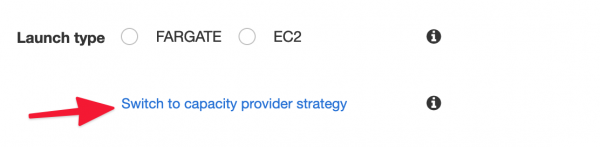
Definição de tarefa — selecionamos a Definição de Tarefa criada anteriormente e sua revisão.
Nome do serviço — para não confundir, sempre indicamos o mesmo que a Definição de Tarefa.
Tipo de serviço — sempre Replica.
Número de tarefas — número desejado de tarefas ativas no serviço. Este parâmetro é gerenciado pelo escalonamento, mas ainda precisa ser especificado.
Porcentagem mínima saudável e Porcentagem máxima — determinam o comportamento das tarefas durante a implantação. Os valores padrão 100 e 200 indicam que no momento da implantação, o número de tarefas aumentará duas vezes, e depois retornará ao desejado. Se você tiver 1 tarefa, min=0 e max=100, ela será encerrada durante a implantação e, em seguida, uma nova será iniciada, o que resultará em inatividade. Se tiver 1 tarefa, min=50 e max=150, a implantação não acontecerá, pois não é possível dividir 1 tarefa ao meio ou aumentar em 1,5 vezes.
Tipo de implantação — deixamos Atualização progressiva.
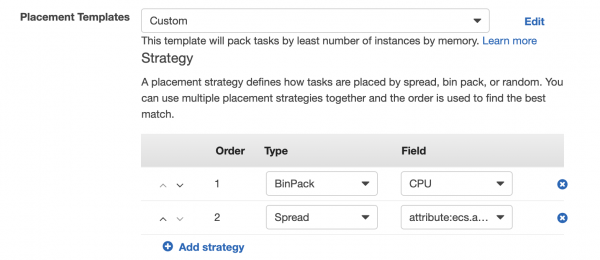
Templates de alocação — regras para alocação de tarefas nas máquinas. O padrão é AZ Balanced Spread — isso significa que cada nova tarefa será colocada em uma nova instância até que as máquinas sejam iniciadas em todas as zonas de disponibilidade. Normalmente, fazemos BinPack — CPU e Spread — AZ; com essa política, as tarefas são alocadas o mais compactamente possível em uma máquina em termos de CPU. Se for necessário criar uma nova máquina, ela será criada em uma nova zona de disponibilidade.
Tipo de balanceador de carga — escolhemos Application Load Balancer.
Função IAM do serviço — escolhemos ecsServiceRole.
Nome do balanceador de carga — escolhemos o balanceador criado anteriormente.
Período de graça da verificação de saúde — pausa antes de realizar as verificações de funcionalidade após a implantação de uma nova tarefa, costumamos definir 60 segundos.
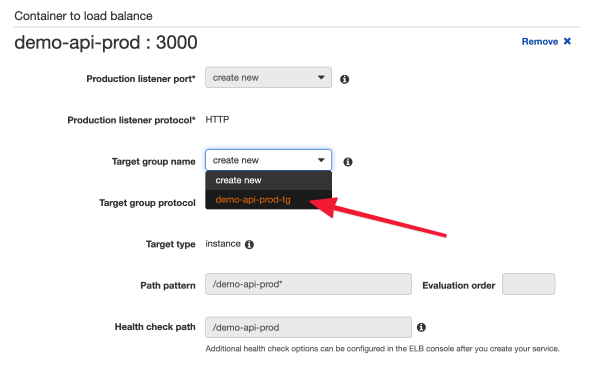
Container para balanceamento de carga — na opção Nome do grupo-alvo, selecionamos o grupo criado anteriormente e tudo será preenchido automaticamente.
Escalonamento Automático de Serviços — parâmetros de escalonamento do serviço. Selecionamos Configurar Escalonamento Automático de Serviços para ajustar a contagem desejada do seu serviço. Definimos a quantidade mínima e máxima de tarefas durante o escalonamento.
Função IAM para Escalonamento Automático de Serviços — escolhemos AWSServiceRoleForApplicationAutoScaling_ECSService.
Políticas de escalonamento automático de tarefas — regras para escalonamento. Existem 2 tipos:
- Rastreamento de meta — rastreamento de métricas-alvo (uso de CPU/RAM ou número de solicitações por tarefa). Por exemplo, queremos que a carga média do processador esteja em 85%; quando ela exceder, novas tarefas serão adicionadas até que atinja o valor alvo. Se a carga estiver abaixo, as tarefas serão removidas, a menos que a proteção contra escalonamento para baixo esteja ativada (Desativar escalonamento para baixo).
- Escalonamento em etapas — reação a um evento arbitrário. Aqui podemos configurar a reação a qualquer evento (Alarme CloudWatch); quando ocorrer, podemos adicionar ou remover uma quantidade específica de tarefas ou indicar um número exato de tarefas.
O serviço pode ter várias regras de escalonamento, o que pode ser útil, desde que não entrem em conflito uns com os outros.
Conclusão
Se você seguiu as instruções e usou a mesma imagem do Docker, seu serviço deve retornar essa página.

- Criamos um modelo pelo qual todas as máquinas no serviço são iniciadas. Também aprendemos a atualizar as máquinas ao alterar o modelo.
- Configuramos o tratamento do sinal de parada da instância spot, para que dentro de um minuto após recebê-lo, todas as tarefas em execução sejam removidas da máquina, garantindo que nada seja perdido ou interrompido.
- Subimos um balanceador para distribuir uniformemente a carga entre as máquinas.
- Criamos um serviço que opera em instâncias spot, reduzindo assim os custos com máquinas em cerca de 3 vezes.
- Configuramos o escalonamento automático em ambas as direções para lidar com aumentos de carga, mas ao mesmo tempo não pagar por inatividade.
- Usamos um Provedor de Capacidade para que o aplicativo gerencie a infraestrutura (máquinas), e não o contrário.
- Estamos indo muito bem.
Se você tem picos de carga previsíveis, por exemplo, ao fazer uma grande campanha de e-mail, pode configurar o escalonamento de acordo com .
Além disso, é possível fazer escalonamento com base em dados de diferentes partes do seu sistema. Por exemplo, temos a funcionalidade para usuários do aplicativo móvel. Às vezes, a campanha é enviada para mais de 1 milhão de pessoas. Após tal envio, sempre há um grande aumento nas solicitações ao API, pois muitos usuários acessam o aplicativo ao mesmo tempo. Portanto, se percebemos que há uma quantidade significativamente maior de promoções programadas para envio do que o padrão, podemos rapidamente iniciar várias máquinas e tarefas adicionais para nos prepararmos para a carga.
Ficarei feliz se vocês compartilharem casos interessantes de uso de instâncias spot e ECS ou alguma dica sobre escalonamento nos comentários.
Em breve, publicaremos artigos sobre como processamos milhares de eventos analíticos por segundo em uma pilha predominantemente serverless (com custos) e sobre como é feito o deploy de serviços com GitLab CI e Terraform Cloud.
Siga-nos, vai ser interessante!
Apenas usuários registrados podem participar da pesquisa. , por favor.
Você utiliza instâncias spot em produção?
22,2%Sim6
66,7%Não18
11,1%Descobri sobre elas através de um artigo, e pretendo usar.
Votaram 27 usuários. 5 usuários se abstiveram.
Fonte: habr.com
