

Na atual pandemia de COVID-19, surgiu uma infinidade de problemas que os hackers rapidamente exploraram. Desde protetores faciais impressos em 3D e máscaras de fabricação caseira até a substituição de um ventilador mecânico completo — esse fluxo de ideias inspirou e alegrou as pessoas. Ao mesmo tempo, houve tentativas de avançar em outra área: pesquisas focadas diretamente na luta contra o vírus.
Aparentemente, a abordagem com maior potencial para conter a atual pandemia e se antecipar a futuras é aquela que busca chegar à raiz do problema. Essa abordagem do tipo "conheça seu inimigo" é defendida pelo projeto computacional Folding@Home. Milhões de pessoas se registraram no projeto e estão doando parte do poder de computação de suas CPUs e GPUs, criando assim o maior [computador] supercomputador distribuído da história.
Mas para que exatamente são utilizados todos esses exaFLOPS? Por que é necessário alocar esse poder computacional para ? Какая тут работает биохимия, зачем вообще белкам нужно укладываться? Вот краткий обзор фолдинга белков: что это, как он происходит и в чём его важность.
Para começar, o mais importante: por que as proteínas são necessárias?
As proteínas são estruturas vitais. Elas não apenas fornecem o material de construção para as células, mas também atuam como catalisadores para praticamente todas as reações bioquímicas. As proteínas, sejam elas ou , são longas cadeias , dispostas em uma sequência específica. As funções das proteínas são determinadas por quais aminoácidos estão localizados em determinados pontos da proteína. Por exemplo, se uma proteína precisa se ligar a uma molécula carregada positivamente, o local de ligação deve estar preenchido com aminoácidos carregados negativamente.
Para entender como as proteínas obtêm a estrutura que define sua função, é preciso revisar os fundamentos da biologia molecular e o fluxo de informação na célula.
A produção, ou de proteínas começa com o processo de Durante a transcrição, a dupla hélice do DNA, que contém a informação genética da célula, se desenrola parcialmente, proporcionando acesso às bases nitrogenadas do DNA para a enzima chamada A função da RNA polimerase é criar uma cópia de RNA, ou transcrição, do gene. Essa cópia do gene é chamada de (mRNA) é uma molécula simples, perfeitamente adequada para controlar as fábricas de proteínas dentro da célula, , que são responsáveis pela produção, ou de proteínas.
Os ribossomos agem como dispositivos de montagem – eles capturam o molde de mRNA e o correspondem a outros pequenos pedaços de RNA, (tRNA). Cada tRNA possui duas áreas ativas – uma seção de três bases chamada , que deve coincidir com os códons correspondentes do mRNA, e uma região para se ligar ao aminoácido específico para esse Durante a tradução, as moléculas de tRNA na ribossomo tentam se ligar aleatoriamente ao mRNA usando anticódons. Se bem-sucedida, a molécula de tRNA junta seu aminoácido ao anterior, formando o próximo elo na cadeia de aminoácidos codificada pelo mRNA.
Essa sequência de aminoácidos é o primeiro nível da hierarquia estrutural da proteína, sendo assim chamada de sua Toda a estrutura tridimensional da proteína e suas funções decorrem diretamente da estrutura primária e dependem das diversas propriedades de cada um dos aminoácidos e suas interações entre si. Se não fossem essas propriedades químicas e as interações dos aminoácidos, permaneceriam como sequências lineares sem estrutura tridimensional. Isso pode ser observado a cada vez que cozinhamos alimentos – nesse processo ocorre a da estrutura tridimensional das proteínas.
As ligações de longo alcance entre partes das proteínas
O próximo nível da estrutura tridimensional, que vai além da primária, recebeu o nome engenhoso de Ela envolve ligações de hidrogênio entre aminoácidos relativamente próximos. A essência principal dessas interações estabilizadoras resume-se em duas coisas: e A hélice alfa forma uma seção bem torcida do polipeptídeo, enquanto a folha beta é uma área lisa e ampla. Ambas as formações possuem propriedades estruturais e funcionais, dependendo das características dos aminoácidos que as compõem. Por exemplo, se a hélice alfa é predominantemente composta por aminoácidos hidrofílicos, como ou é provável que participe de reações aquosas.
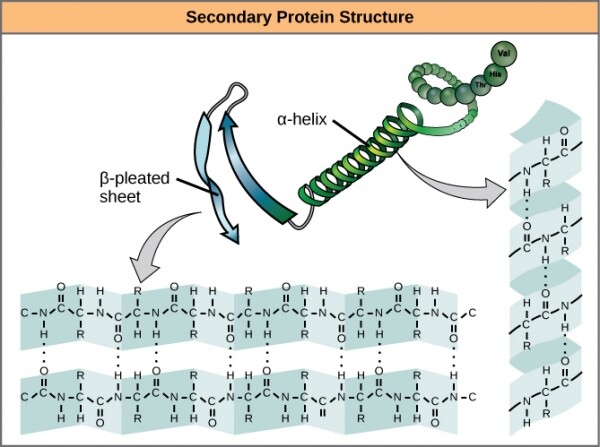
As espirais alfa e as folhas beta nas proteínas. As ligações de hidrogênio são formadas durante a expressão da proteína.
Essas duas estruturas e suas combinações formam o próximo nível de estrutura da proteína — . Ao contrário dos simples fragmentos da estrutura secundária, a estrutura terciária é principalmente influenciada pela hidrofobicidade. No centro da maioria das proteínas, existem aminoácidos de alta hidrofobicidade, como ou , e a água é excluída devido à natureza 'gorda' dos radicais. Essas estruturas frequentemente aparecem em proteínas transmembrana que estão incorporadas na bicamada lipídica que envolve as células. As partes hidrofóbicas das proteínas permanecem termodinamicamente estáveis dentro da parte lipídica da membrana, enquanto as partes hidrofílicas da proteína estão expostas ao meio aquoso de ambos os lados.
Além disso, a estabilidade das estruturas terciárias é garantida por interações de longo alcance entre os aminoácidos. Um exemplo clássico dessas ligações é , frequentemente ocorrendo entre dois radicais de cisteína. Se na cabeleireira, durante o procedimento de permanente de um cliente, você sentiu um cheiro que lembrava um pouco ovos podres, isso era a desnaturalização parcial da estrutura terciária do queratina presente no cabelo, ocorrendo através da diminuição das ligações dissulfídicas por meio de misturas que contêm enxofre A estrutura terciária é estabilizada por interações de longo alcance, como hidrofobicidade ou ligações dissulfídicas.
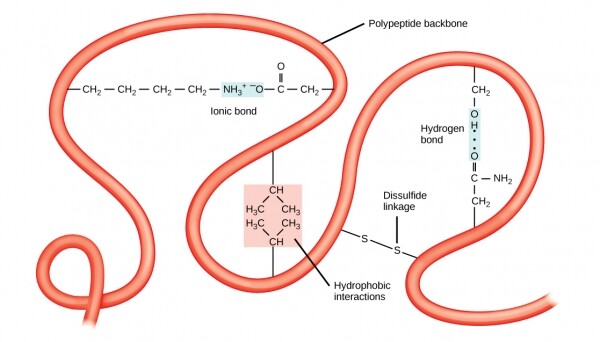
As ligações dissulfídicas podem ocorrer entre
os radicais de cisteína em uma única cadeia polipeptídica, ou entre cisteínas de diferentes cadeias completas. As interações entre diferentes cadeias formam da estrutura proteica. Um excelente exemplo da estrutura quaternária é nível da estrutura proteica. Um ótimo exemplo da estrutura quaternária é está no seu sangue. Cada molécula de hemoglobina é composta por quatro globinas idênticas, partes da proteína, cada uma das quais é mantida em uma posição específica dentro do polipeptídeo por ligações dissulfídicas, além de estar ligada a uma molécula de heme que contém ferro. Todas as quatro globinas estão ligadas por pontes dissulfídicas intermoleculares, e a molécula inteira se liga a várias moléculas de ar, até quatro, sendo capaz de liberá-las conforme necessário.
Modelagem estrutural em busca de tratamento para doenças
As cadeias polipeptídicas começam a se dobrar em sua forma final durante a tradução, quando a cadeia em crescimento sai do ribossomo - de forma semelhante a um pedaço de fio de uma liga com efeito de memória que pode assumir formas complexas quando aquecido. No entanto, como sempre na biologia, as coisas não são tão simples.
Em muitas células, os genes transcritos sofrem uma edição significativa antes da tradução, alterando substancialmente a estrutura primária da proteína em comparação com a sequência pura do gene. Nesse processo, os mecanismos de tradução frequentemente contam com a ajuda de acompanhantes moleculares, proteínas que se ligam temporariamente à nascente cadeia polipeptídica, impedindo-a de assumir qualquer forma intermediária da qual depois não possam passar para a forma final.
Isso tudo para dizer que prever a forma final de uma proteína não é uma tarefa trivial. Durante décadas, a única maneira de estudar a estrutura das proteínas foi através de métodos físicos como a cristalografia de raios X. Somente no final da década de 1960, químicos biofísicos começaram a construir modelos computacionais de dobramento de proteínas, concentrando-se principalmente na modelagem da estrutura secundária. Esses métodos e seus descendentes requerem enormes volumes de dados de entrada além da estrutura primária - por exemplo, tabelas de ângulos de ligação de aminoácidos, listas de hidrofobicidade, estados carregados e até a preservação da estrutura e função em intervalos evolutivos de tempo - tudo para tentar adivinhar como será a proteína final.
Os métodos computacionais modernos para prever a estrutura secundária, como os que funcionam na rede Folding@Home, operam com uma precisão de cerca de 80% - o que é bastante razoável, considerando a complexidade da tarefa. Os dados obtidos por modelos preditivos sobre proteínas como a proteína spike do SARS-CoV-2 serão comparados com dados de estudos físicos do vírus. Assim, será possível obter a estrutura exata da proteína e, possivelmente, entender como o vírus se liga aos receptores. humanos, localizados nas vias respiratórias que se conectam ao interior do corpo. Se conseguirmos compreender essa estrutura, provavelmente encontraremos medicamentos que bloqueiem a ligação e previnam a infecção.
As pesquisas sobre o dobramento de proteínas estão no cerne da nossa compreensão de tantas doenças e infecções, que mesmo quando usarmos a rede Folding@Home para descobrir como combater a COVID-19, cujo aumento explosivo temos observado recentemente, esta rede não ficará inativa por muito tempo. É uma ferramenta de pesquisa ideal para estudar modelos de proteínas que estão na base de dezenas de doenças relacionadas ao dobramento incorreto de proteínas - como a doença de Alzheimer ou uma variação da doença de Creutzfeldt-Jakob, frequentemente erroneamente chamada de doença da vaca louca. E quando inevitavelmente surgir um novo vírus, estaremos preparados para enfrentar a batalha novamente.
Fonte: habr.com
