

Neste estudo, eu quis observar quais melhorias de desempenho podem ser obtidas usando a fonte de dados ClickHouse em vez de PostgreSQL. Eu entendo quais benefícios de desempenho eu obtenho ao usar ClickHouse. Esses benefícios serão mantidos se eu acessar o ClickHouse a partir do PostgreSQL através de uma camada de dados externa (FDW)?
Os ambientes de banco de dados em estudo são PostgreSQL v11, clickhousedb_fdw e o banco de dados ClickHouse. No final, do PostgreSQL v11, vamos executar várias consultas SQL, roteadas através do nosso clickhousedb_fdw para o banco de dados ClickHouse. Então veremos como o desempenho do FDW se compara às mesmas consultas executadas no PostgreSQL nativo e no ClickHouse nativo.
Banco de dados ClickHouse
ClickHouse é um sistema de gerenciamento de banco de dados baseado em colunas de código aberto que pode alcançar um desempenho de 100 a 1000 vezes mais rápido do que abordagens tradicionais de banco de dados, capaz de processar mais de um bilhão de linhas em menos de um segundo.
clickhousedb_fdw
O clickhousedb_fdw é uma camada de dados externa para o banco de dados ClickHouse, ou FDW, um projeto de código aberto da Percona. .
.
Como você verá, isso fornece um FDW para ClickHouse, que permite SELECT from e INSERT INTO no banco de dados ClickHouse a partir do servidor PostgreSQL v11.
O FDW suporta funcionalidades avançadas, como agregações e joins. Isso melhora significativamente o desempenho, utilizando os recursos do servidor remoto para essas operações que consomem muitos recursos.
Ambiente de benchmark
- Servidor Supermicro:
- Intel® Xeon® CPU E5-2683 v3 @ 2.00GHz
- 2 soquetes / 28 núcleos / 56 threads
- Memória: 256GB de RAM
- Armazenamento: Samsung SM863 1.9TB SSD Enterprise
- Sistema de arquivos: ext4/xfs
- OS: Linux smblade01 4.15.0-42-generic #45~16.04.1-Ubuntu
- PostgreSQL: versão 11
Testes de benchmark
Em vez de usar um conjunto de dados gerado por máquinas para este teste, usamos os dados de "Desempenho ao longo do tempo, reportando o tempo de operação" de 1987 a 2018. Você pode acessar os dados .
O tamanho do banco de dados é de 85 GB, fornecendo uma tabela com 109 colunas.
Consultas de benchmark
Aqui estão as consultas que usei para comparar ClickHouse, clickhousedb_fdw e PostgreSQL.
Q#
Consulta Contém Agregações e Group By
Q1
SELECT DayOfWeek, count(*) AS c FROM ontime WHERE Year >= 2000 AND Year <= 2008 GROUP BY DayOfWeek ORDER BY c DESC;
Q2
SELECIONE DiaDaSemana, contagem(*) COMO c DE ontime ONDE DepDelay>10 E Ano >= 2000 E Ano <= 2008 AGRUPAR POR DiaDaSemana ORDENAR POR c DESC;
Q3
SELECIONE Origem, contagem(*) COMO c DE ontime ONDE DepDelay>10 E Ano >= 2000 E Ano <= 2008 AGRUPAR POR Origem ORDENAR POR c DESC LIMIT 10;
Q4
SELECIONE Transportadora, contagem() DE ontime ONDE DepDelay>10 E Ano = 2007 AGRUPAR POR Transportadora ORDENAR POR contagem() DESC;
Q5
SELECIONE a.Transportadora, c, c2, c1000/c2 COMO c3 DE ( SELECIONE Transportadora, contagem() COMO c DE ontime ONDE DepDelay>10 E Ano=2007 AGRUPAR POR Transportadora ) a INNER JOIN ( SELECIONE Transportadora, contagem(*) COMO c2 DE ontime ONDE Ano=2007 AGRUPAR POR Transportadora)b ON a.Transportadora=b.Transportadora ORDENAR POR c3 DESC;
Q6
SELECIONE a.Transportadora, c, c2, c1000/c2 COMO c3 DE ( SELECIONE Transportadora, contagem() COMO c DE ontime ONDE DepDelay>10 E Ano >= 2000 E Ano = 2000 E Ano <= 2008 AGRUPAR POR Transportadora ) b ON a.Transportadora=b.Transportadora ORDENAR POR c3 DESC;
Q7
SELECIONE Transportadora, média(DepDelay) * 1000 COMO c3 DE ontime ONDE Ano >= 2000 E Ano <= 2008 AGRUPAR POR Transportadora;
Q8
SELECIONE Ano, média(DepDelay) DE ontime AGRUPAR POR Ano;
Q9
selecione Ano, contagem(*) COMO c1 DE ontime AGRUPAR POR Ano;
Q10
SELECIONE média(cnt) DE (SELECIONE Ano,Mês,contagem(*) COMO cnt DE ontime ONDE DepDel15=1 AGRUPAR POR Ano,Mês) a;
Q11
selecione média(c1) DE (selecione Ano,Mês,contagem(*) COMO c1 DE ontime AGRUPAR POR Ano,Mês) a;
Q12
SELECIONE NomeCidadeOrigem, NomeCidadeDestino, contagem(*) COMO c DE ontime AGRUPAR POR NomeCidadeOrigem, NomeCidadeDestino ORDENAR POR c DESC LIMIT 10;
Q13
SELECIONE NomeCidadeOrigem, contagem(*) COMO c DE ontime AGRUPAR POR NomeCidadeOrigem ORDENAR POR c DESC LIMIT 10;
Consulta contém junções
Q14
SELECIONE a.Ano, c1/c2 DE ( selecione Ano, contagem()1000 COMO c1 DE ontime ONDE DepDelay>10 AGRUPAR POR Ano) a INNER JOIN (selecione Ano, contagem(*) COMO c2 DE ontime AGRUPAR POR Ano ) b ON a.Ano=b.Ano ORDENAR POR a.Ano;
Q15
SELECIONE a."Ano", c1/c2 DE ( selecione "Ano", contagem()1000 COMO c1 DE fontime ONDE "DepDelay">10 AGRUPAR POR "Ano") a INNER JOIN (selecione "Ano", contagem(*) COMO c2 DE fontime AGRUPAR POR "Ano" ) b ON a."Ano"=b."Ano";
Tabela-1: Consultas usadas no benchmark
Execuções de consulta
Aqui estão os resultados de cada uma das consultas executadas com diferentes configurações de banco de dados: PostgreSQL com e sem índices, ClickHouse próprio e clickhousedb_fdw. O tempo é mostrado em milissegundos.
Q#
PostgreSQL
PostgreSQL (Indexado)
ClickHouse
clickhousedb_fdw
Q1
27920
19634
23
57
Q2
35124
17301
50
80
Q3
34046
15618
67
115
Q4
31632
7667
25
37
Q5
47220
8976
27
60
Q6
58233
24368
55
153
Q7
30566
13256
52
91
Q8
38309
60511
112
179
Q9
20674
37979
31
81
Q10
34990
20102
56
148
Q11
30489
51658
37
155
Q12
39357
33742
186
1333
Q13
29912
30709
101
384
Q14
54126
39913
124
1364212
Q15
97258
30211
245
259
Tabela-1: Tempo levado para executar as consultas usadas no benchmark
Visualizar resultados
O gráfico mostra o tempo de execução da consulta em milissegundos, o eixo X mostra o número da consulta das tabelas acima, e o eixo Y mostra o tempo de execução em milissegundos. Os resultados do ClickHouse e os dados obtidos do postgres através do clickhousedb_fdw são mostrados. A partir da tabela, observa-se que há uma enorme diferença entre PostgreSQL e ClickHouse, mas a diferença mínima entre ClickHouse e clickhousedb_fdw.
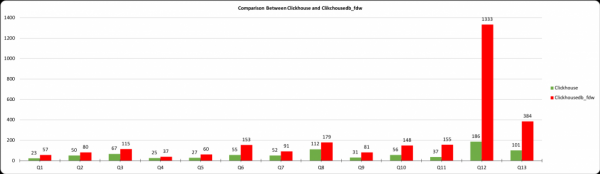
Este gráfico mostra a diferença entre ClickhouseDB e clickhousedb_fdw. Em muitas consultas, os custos operacionais do FDW não são tão grandes e raramente significativos, exceto na Q12. Esta consulta envolve junções e a cláusula ORDER BY. Devido à cláusula ORDER BY GROUP/BY, os ORDER BY não são descartados para ClickHouse.
Na Tabela 2, vemos um salto no tempo das consultas Q12 e Q13. Reitero que isso se deve ao uso da cláusula ORDER BY. Para confirmar isso, executei as consultas Q-14 e Q-15 com e sem a cláusula ORDER BY. Sem a cláusula ORDER BY, o tempo de execução é de 259 ms, enquanto com a cláusula ORDER BY é de 1364212 ms. Para depurar esta consulta, explico ambas as consultas, e aqui estão os resultados da explicação.
Q15: Sem Cláusula ORDER BY
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2
     FROM (SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) AS c2 FROM fontime GROUP BY "Year") b ON a."Year"=b."Year";
Q15: Consulta Sem Cláusula ORDER BY
PLANO DE CONSULTA
Hash Join  (custo=2250.00..128516.06 linhas=50000000 largura=12)
Saída: fontime."Year", (((count(*) * 1000)) / b.c2)
Único Interior: sim   Condição de Hash: (fontime."Year" = b."Year")
->  Pesquisa Remota  (custo=1.00..-1.00 linhas=100000 largura=12)
Saída: fontime."Year", ((count(*) * 1000))
Relações: Agregar em (fontime)
SQL Remoto: SELECT "Year", (count(*) * 1000) FROM "default".ontime WHERE (("DepDelay" > 10)) GROUP BY "Year"
->  Hash  (custo=999.00..999.00 linhas=100000 largura=12)
Saída: b.c2, b."Year"
->  Pesquisa de Subconsulta em b  (custo=1.00..999.00 linhas=100000 largura=12)
Saída: b.c2, b."Year"
->  Pesquisa Remota  (custo=1.00..-1.00 linhas=100000 largura=12)
Saída: fontime_1."Year", (count(*))
Relações: Agregar em (fontime)
SQL Remoto: SELECT "Year", count(*) FROM "default".ontime GROUP BY "Year"(16 linhas)
Q14: Consulta Com Cláusula ORDER BY
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2 FROM(SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) as c2 FROM fontime GROUP BY "Year") b  ON a."Year"= b."Year"
     ORDER BY a."Year";
Q14: Plano de Consulta com Cláusula ORDER BY
PLANO DE CONSULTA
Merge Join  (custo=2.00..628498.02 linhas=50000000 largura=12)
Saída: fontime."Year", (((count(*) * 1000)) / (count(*)))
Único Interior: sim   Condição de Merge: (fontime."Year" = fontime_1."Year")
->  GroupAggregate  (custo=1.00..499.01 linhas=1 largura=12)
Saída: fontime."Year", (count(*) * 1000)
Chave de Grupo: fontime."Year"
->  Pesquisa Remota em public.fontime  (custo=1.00..-1.00 linhas=100000 largura=4)
SQL Remoto: SELECT "Year" FROM "default".ontime WHERE (("DepDelay" > 10))
            ORDER BY "Year" ASC
->  GroupAggregate  (custo=1.00..499.01 linhas=1 largura=12)
Saída: fontime_1."Year", count(*)         Chave de Grupo: fontime_1."Year"
->  Pesquisa Remota em public.fontime fontime_1  (custo=1.00..-1.00 linhas=100000 largura=4)

SQL Remoto: SELECT "Year" FROM "default".ontime ORDER BY "Year" ASC(16 linhas)
Saída
Os resultados desses experimentos mostram que o ClickHouse oferece um desempenho realmente bom, e o clickhousedb_fdw proporciona benefícios de desempenho do ClickHouse a partir do PostgreSQL. Embora haja algumas sobrecargas ao usar o clickhousedb_fdw, elas são insignificantes e comparáveis ao desempenho alcançado ao executar diretamente no banco de dados ClickHouse. Isso também confirma que o fdw no PostgreSQL oferece resultados excelentes.
Chat do Telegram sobre Clickhouse
Chat do Telegram sobre PostgreSQL
Fonte: habr.com
