

Olá a todos, meu nome é Alexander e sou engenheiro de Qualidade de Dados, responsável por verificar a qualidade dos dados. Neste artigo, falarei sobre como cheguei a isso e por que, em 2020, essa área de teste se tornou uma grande tendência.
Tendência Global
O mundo de hoje está passando por uma nova revolução tecnológica, um dos aspectos da qual é o uso de dados acumulados por diversas empresas para impulsionar suas vendas, lucros e marketing. Acredita-se que a posse de bons dados (de qualidade), bem como cérebros habilidosos que possam transformá-los em dinheiro (processamento correto, visualização, construção de modelos de machine learning, etc.), se tornaram a chave para o sucesso de muitos. Se há 15-20 anos a coleta e monetização de dados eram dominadas principalmente por grandes empresas, hoje isso é uma preocupação de praticamente todas as empresas sensatas.
Com isso, há alguns anos, todos os portais dedicados à busca de empregos em todo o mundo começaram a ser inundados com vagas para Data Scientists, pois todos acreditavam que, ao contratar tal especialista, poderiam construir um supermodelo de machine learning, prever o futuro e dar um "salto quântico" para a empresa. Com o tempo, as pessoas perceberam que essa abordagem quase nunca funciona, já que nem todos os dados que chegam a esses especialistas são adequados para o treinamento de modelos.
E começaram as solicitações dos Data Scientists: "Vamos comprar mais dados de tais e tais...", "Estamos com falta de dados...", "Precisamos de mais alguns dados, de preferência de qualidade...". Com base nessas solicitações, começaram a se formar inúmeras interações entre empresas que possuíam diferentes conjuntos de dados. Naturalmente, isso exigiu a organização técnica desse processo - conectar-se à fonte de dados, extrair os dados, verificar se estavam completamente carregados, etc. O número desses processos começou a crescer e, hoje, temos uma enorme demanda por outro tipo de especialistas - engenheiros de Qualidade de Dados - aqueles que monitoram o fluxo de dados no sistema (data pipelines), a qualidade dos dados na entrada e na saída, e tiram conclusões sobre sua suficienciência, integridade e outras características.
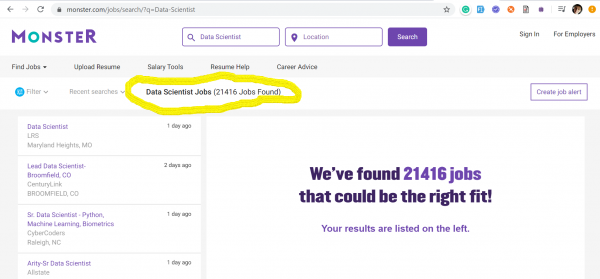
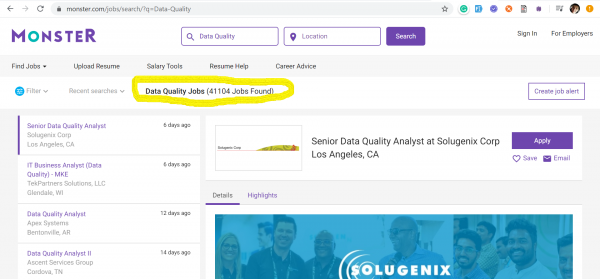
A tendência de engenheiros de Data Quality chegou até nós dos Estados Unidos, onde, no auge da era capitalista turbulenta, ninguém está disposto a perder a batalha pelos dados. Abaixo, apresento capturas de tela de dois dos sites de busca de empregos mais populares nos Estados Unidos: e — nos quais estão exibidos os dados referentes ao estado em 17 de março de 2020 sobre o número de vagas disponíveis, com base nas palavras-chave: Data Quality e Data Scientist.
Data Scientists – 21.416 vagas
Data Quality – 41.104 vagas
Data Scientists – 404 vagas
Data Quality – 2.020 vagas
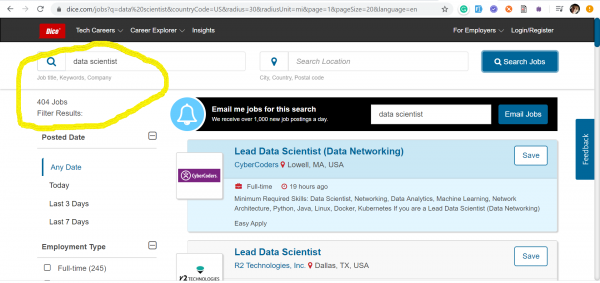
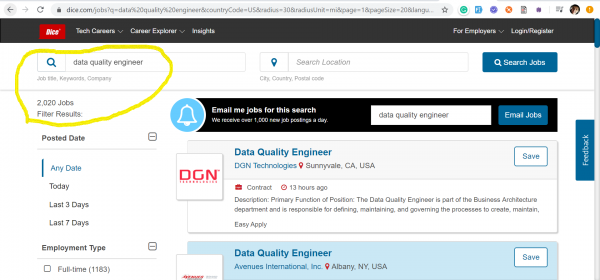
É evidente que essas profissões de forma alguma competem entre si. As capturas de tela servem apenas para ilustrar a situação atual do mercado de trabalho em relação à demanda por engenheiros de Data Quality, que no momento são muito mais solicitados do que Data Scientists.
Em junho de 2019, a EPAM, em resposta às necessidades do moderno mercado de TI, separou o Data Quality como uma prática independente. Os engenheiros de Data Quality, em seu dia a dia, gerenciam dados, verificam seu comportamento em novas condições e sistemas, e controlam a relevância, a suficiência e a atualidade dos dados. No entanto, em um sentido prático, os engenheiros de Data Quality dedicam de fato um pouco de tempo aos testes funcionais clássicos, MAS isso depende muito do projeto (um exemplo irei apresentar a seguir).
As responsabilidades de um engenheiro de Data Quality não se limitam apenas a checagens manuais/automáticas de rotina sobre "nulls, contagens e somas" em tabelas de banco de dados, mas requerem um profundo entendimento das necessidades comerciais do cliente e, consequentemente, a habilidade de transformar os dados disponíveis em informações comerciais úteis.
Teoria de Data Quality
Para podermos imaginar mais claramente o papel de um engenheiro desse tipo, vamos entender o que é Data Quality na teoria.
Data Quality — um dos estágios de Data Management (um mundo inteiro que deixaremos para você explorar por conta própria) e responsável pela análise dos dados de acordo com os seguintes critérios:
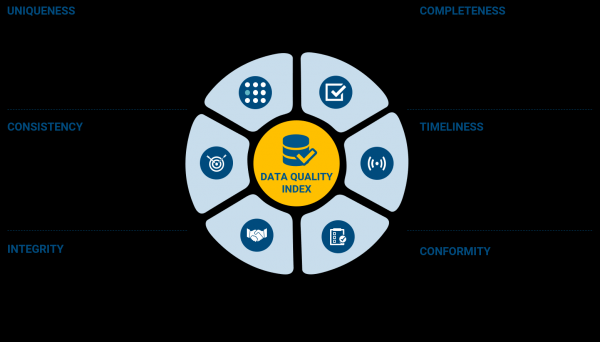
Acho que não é necessário decifrar cada um dos pontos (que na teoria são chamados de 'data dimensions'), pois estão bem descritos na imagem. Mas o próprio processo de teste não implica a cópia rigorosa dessas características em casos de teste e sua verificação. Na Qualidade de Dados, assim como em qualquer outro tipo de teste, é necessário, antes de tudo, partir dos requisitos de qualidade de dados, acordados com os participantes do projeto que tomam decisões de negócios.
Dependendo do projeto, o engenheiro de Qualidade de Dados pode desempenhar diferentes funções: desde um simples testador automatizado com uma avaliação superficial da qualidade dos dados até uma pessoa que realiza um profundo perfilamento desses dados com base nas características mencionadas anteriormente.
Uma descrição muito detalhada dos processos de Gestão de Dados, Qualidade de Dados e afins está bem descrita no livro intitulado ‘DAMA-DMBOK: Data Management Body of Knowledge: 2nd Edition’. Recomendo muito este livro como uma introdução a este tema (você encontrará o link no final do artigo).
Minha história
Na indústria de TI, passei de testador Junior em empresas de produtos até Engenheiro de Qualidade de Dados Lead na EPAM. Já após cerca de dois anos trabalhando como testador, tive a firme convicção de que fazia todos os tipos de testes: regressão, funcional, estresse, estabilidade, segurança, UI, entre outros — e experimentei uma grande quantidade de ferramentas de teste, trabalhando em três linguagens de programação: Java, Scala, Python.
Olhando para trás, entendo por que meu conjunto de habilidades profissionais se tornou tão diversificado — participei de projetos relacionados ao trabalho com dados, grandes e pequenos. Isso me levou a um mundo de inúmeras ferramentas e oportunidades de crescimento.
Para avaliar a diversidade de ferramentas e oportunidades de adquirir novos conhecimentos e habilidades, basta dar uma olhada na imagem abaixo, que mostra as mais populares no mundo de 'Data & AI'.
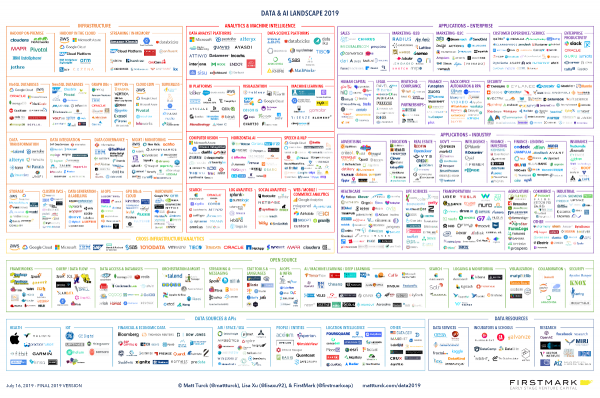
Este tipo de ilustração é criada anualmente por um dos conhecidos capitalistas de risco, Matt Turck, que vem da área de desenvolvimento de software. Aqui está o link para o blog dele e , onde ele atua como parceiro.
Cresci profissionalmente especialmente rápido quando fui o único testador no projeto, ou pelo menos no início do projeto. É exatamente nesse momento que você assume a responsabilidade por todo o processo de teste, e não tem a opção de recuar, apenas seguir em frente. No começo, isso era intimidante, mas agora vejo claramente todas as vantagens desse desafio:
- Você começa a se comunicar com toda a equipe como nunca antes, já que não há nenhum intermediário para a comunicação: nem gerente de testes, nem colegas testadores.
- A imersão no projeto se torna incrivelmente profunda, e você possui informações sobre todos os componentes, tanto em termos gerais quanto em detalhes.
- Os desenvolvedores não olham para você como "o cara da testagem que não se sabe o que faz", mas sim como um igual que traz uma vantagem incrível para a equipe com seus testes automatizados e a previsão da aparição de bugs em um determinado ponto do produto.
- Como resultado, você se torna mais eficiente, mais qualificado e mais requisitado.
À medida que o projeto crescia, em 100% dos casos eu me tornava mentor dos novos testadores que chegavam, ensinando-os e passando o conhecimento que eu mesmo havia adquirido. Dependendo do projeto, nem sempre eu recebia do gerenciamento especialistas em teste automatizado de alto nível, e havia a necessidade de treinar aqueles que queriam aprender automação ou criar ferramentas para que eles pudessem usar em suas atividades diárias (ferramentas para geração de dados e seu upload no sistema, ferramentas para realização de testes de carga/testes de estabilidade "rápidos", etc.).
Exemplo de um projeto específico
Infelizmente, devido a obrigações de confidencialidade, não posso falar em detalhes sobre os projetos em que trabalhei, mas darei exemplos de tarefas típicas de um Engenheiro de Qualidade de Dados em um dos projetos.
A essência do projeto era implementar uma plataforma para preparação de dados para treinar modelos de aprendizado de máquina. O cliente era uma grande empresa farmacêutica dos EUA. Tecnicamente, era um cluster , implantado em instâncias, com vários microsserviços e apoiado em um projeto de Código Aberto da empresa EPAM — , adaptado às necessidades do cliente específico (atualmente o projeto renasceu em ). Os processos ETL foram organizados com o auxílio de e transferiam dados de o sistema do cliente para Buckets. Em seguida, foi implantada uma imagem Docker de um modelo de aprendizado de máquina na plataforma, que foi treinado com dados atualizados e, através de uma interface REST API, fornecia previsões que interessavam ao negócio e resolviam problemas específicos.
Visualmente, tudo parecia assim:
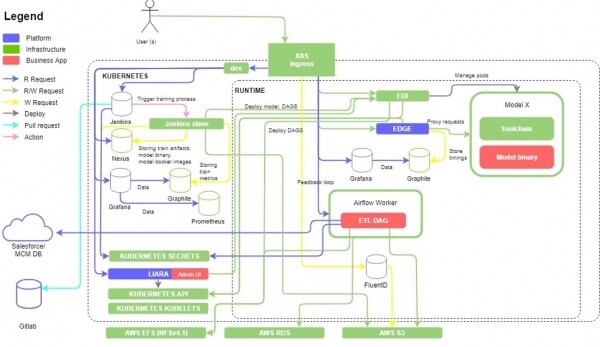
Havia muitos testes funcionais neste projeto, e considerando a rapidez no desenvolvimento de novas funcionalidades e a necessidade de manter o ritmo do ciclo de lançamentos (sprints de duas semanas), era necessário começar a pensar na automação dos testes das partes mais críticas do sistema. A maior parte da própria plataforma, com base em Kubernetes, era coberta por testes automatizados implementados em + Python, mas era preciso também manter e expandir esses testes. Além disso, para a comodidade do cliente, foi criado um GUI para gerenciar os modelos de aprendizado de máquina implantados no cluster, bem como a possibilidade de especificar de onde e para onde os dados deveriam ser transferidos para treinar os modelos. Esse extenso complemento levou à expansão das verificações funcionais automatizadas, que eram principalmente realizadas através de chamadas REST API e um número reduzido de testes end-to-end. Aproximadamente na metade de todo esse processo, juntou-se a nós um testador manual, que se destacou na execução dos testes de aceitação das versões do produto e na comunicação com o cliente sobre a aceitação de mais um lançamento. Além disso, com a chegada do novo especialista, conseguimos documentar nosso trabalho e adicionar algumas verificações manuais muito importantes que eram difíceis de automatizar logo de início.
E finalmente, após alcançarmos a estabilidade da plataforma e a interface gráfica sobre ela, começamos a construir pipelines ETL usando DAGs do Apache Airflow. A verificação automatizada da qualidade dos dados foi realizada através da escrita de DAGs específicos do Airflow que verificavam os dados com base nos resultados do processo ETL. Neste projeto, tivemos a sorte de o cliente nos fornecer acesso a conjuntos de dados anonimizados, nos quais realizamos nossos testes. Verificamos os dados linha por linha para garantir a conformidade com os tipos, a presença de dados corrompidos, o número total de registros antes e depois, e a comparação das transformações realizadas pelo processo ETL em termos de agregação, alteração de nomes de colunas e outros. Além disso, essas verificações foram escalonadas para diferentes fontes de dados, incluindo não apenas o SalesForce, mas também o MySQL.
As verificações de qualidade dos dados finais foram realizadas já no nível do S3, onde eles eram armazenados e estavam prontos para uso no treinamento de modelos de aprendizado de máquina. Para obter dados do arquivo CSV final, localizado no S3 Bucket, e sua validação, foi escrito um código utilizando .
Além disso, o cliente exigiu que alguns dados fossem armazenados em um S3 Bucket e outros em outro. Para isso, foi necessário escrever verificações adicionais para controlar a validade dessa classificação.
Experiência geral em outros projetos.
Exemplo da lista mais geral de atividades do engenheiro de Qualidade de Dados:
- Preparar dados de teste (válidos, inválidos, grandes, pequenos) através de uma ferramenta automatizada.
- Carregar o conjunto de dados preparado na fonte de origem e verificar sua prontidão para uso.
- Executar processos ETL para processar o conjunto de dados da fonte de origem para o destino final ou intermediário, utilizando um determinado conjunto de configurações (no caso de ser possível definir parâmetros configuráveis para a tarefa ETL).
- Verificar os dados processados pelo processo ETL em termos de sua qualidade e conformidade com os requisitos de negócios.
Neste contexto, o foco principal das verificações deve recair não apenas sobre o fato de que o fluxo de dados no sistema foi processado e chegou ao final (o que é parte dos testes funcionais), mas principalmente sobre a verificação e validação dos dados quanto à conformidade com os requisitos esperados, identificação de anomalias e outros aspectos.
Ferramentas
Uma das técnicas para esse controle de dados pode ser a organização de verificações em cadeia em cada estágio do processamento de dados, conhecido na literatura como "data chain" — controle dos dados desde a fonte até o ponto de uso final. Esse tipo de verificação é frequentemente realizado por meio da escrita de consultas SQL de verificação. É claro que essas consultas devem ser o mais leves possível e verificar partes específicas da qualidade dos dados (metadados das tabelas, linhas em branco, NULLs, erros de sintaxe — outros atributos de verificação necessários).
No caso de testes de regressão, que utilizam conjuntos de dados já prontos (não modificáveis ou ligeiramente modificáveis), os códigos de testes automatizados podem armazenar modelos já prontos para verificar a qualidade dos dados (descrições de metadados esperados das tabelas; objetos de seleção aleatória que podem ser escolhidos durante o teste, e outros).
Além disso, durante os testes, é necessário escrever processos de ETL de teste, utilizando frameworks como o Apache Airflow, ou ferramentas de caixa preta na nuvem, como , e outros. Essa situação exige que o engenheiro de teste se aprofunde nos princípios de funcionamento das ferramentas mencionadas e utilize-as de forma ainda mais eficiente tanto para realizar testes funcionais (por exemplo, dos processos de ETL existentes no projeto) quanto para verificar os dados. Em particular, o Apache Airflow já possui operadores prontos para trabalhar com bancos de dados analíticos populares, como o O exemplo mais básico de sua utilização já foi exposto, portanto não vou me repetir.
Além das soluções prontas, ninguém impede que você implemente suas próprias técnicas e ferramentas. Isso não apenas beneficiará o projeto, mas também o próprio Engenheiro de Qualidade de Dados, que assim ampliará seu conhecimento técnico e habilidades de programação.
Como isso funciona em um projeto real.
Uma boa ilustração dos últimos parágrafos sobre «data chain», ETL e verificações onipresentes é o seguinte processo de um dos projetos reais:
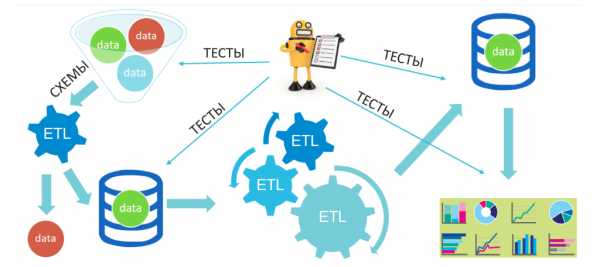
Aqui, diversos dados (naturalmente, preparados por nós) entram na «funnel» de nossa sistema: válidos, inválidos, misturados e assim por diante, depois são filtrados e chegam a um armazenamento intermediário. Em seguida, eles passam por uma série de transformações antes de serem colocados no armazenamento final, de onde, por sua vez, será realizada a análise, construção de data lakes e busca por insights de negócio. Em tal sistema, sem verificar funcionalmente a operação dos processos ETL, focamos na qualidade dos dados antes e depois das transformações, bem como na saída para análise.
Resumindo o que foi dito, independentemente dos lugares onde trabalhei, sempre estive envolvido em projetos de dados que compartilhavam as seguintes características:
- Somente através da automação é possível verificar alguns casos e alcançar um ciclo de lançamento aceitável para o negócio.
- O testador em tal projeto é um dos membros mais respeitados da equipe, pois traz um grande benefício a cada um dos participantes (acelerando os testes, garantindo bons dados para o Data Scientist, identificando defeitos em estágios iniciais).
- Não importa se você trabalha no seu próprio hardware ou na nuvem — todos os recursos estão abstraídos em um cluster do tipo Hortonworks, Cloudera, Mesos, Kubernetes, etc.
- Os projetos são construídos com uma abordagem de microsserviços, prevalecendo cálculos distribuídos e paralelos.
Saliento que, ao trabalhar com testes na área de Qualidade de Dados, o especialista em testes muda seu foco profissional para o código do produto e as ferramentas utilizadas.
Características distintivas dos testes de Qualidade de Dados
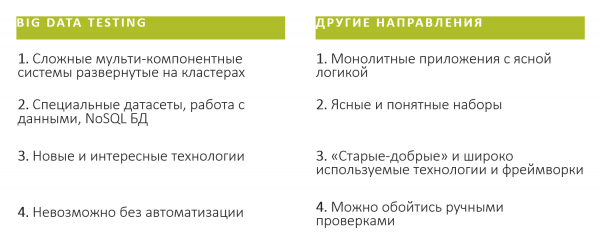
Além disso, para mim, identifiquei as seguintes (para ser claro, MUITO generalizadas e exclusivamente subjetivas) características distintivas dos testes em projetos (sistemas) de Dados (Big Data) e outras áreas:
Links Úteis
- Teoria: .
- EPAM
- Materiais recomendados para um engenheiro de Qualidade de Dados iniciante:
- Curso gratuito no Stepik: .
- Curso no LinkedIn Learning: .
- Artigos:
- ;
- ;
- ;
- Vídeo:
- ;
- ;
Conclusão
Data Quality — é uma área muito jovem e promissora, fazer parte dela significa ser parte de uma startup. Ao ingressar na Qualidade de Dados, você mergulhará em uma grande quantidade de tecnologias modernas e demandadas, mas o mais importante é que enormes oportunidades se abrirão para a geração e realização de suas ideias. Você poderá usar a abordagem de melhoria contínua não apenas no projeto, mas também para si mesmo, desenvolvendo-se continuamente como profissional.
Fonte: habr.com
