

Convido todos a conferir a transcrição da palestra de início de 2016 de Andrei Salnikov "Erros típicos em aplicativos que levam ao bloat no postgresql"
Nesta palestra, abordarei os principais erros em aplicativos que ocorrem na fase de projeto e desenvolvimento do código do aplicativo. Irei considerar apenas aqueles erros que levam ao bloat no Postgresql. Geralmente, esse é o início do fim do desempenho do seu sistema como um todo, embora inicialmente não houvesse sinais disso.
Saudações a todos! Esta palestra não é tão técnica quanto a anterior do meu colega. Esta palestra é voltada principalmente para desenvolvedores de sistemas de backend, pois temos um número considerável de clientes. E todos cometem os mesmos erros. Sobre esses erros que vou falar. Explicarei as consequências fatais e negativas desses erros.
Por que os erros ocorrem? Eles ocorrem por duas razões: por acaso, pode dar certo, e pela falta de conhecimento sobre alguns mecanismos que acontecem entre o banco de dados e o aplicativo, assim como no próprio banco de dados.
Vou lhe apresentar três exemplos com imagens horríveis do que acontece quando tudo dá errado. Em resumo, falarei sobre o mecanismo que ocorre ali. E como lidar com eles quando acontecem, além de quais métodos preventivos usar para evitar erros. Farei uma apresentação de ferramentas auxiliares e fornecer links úteis.
Utilizei um banco de dados de teste, onde tinha duas tabelas. Uma tabela com as contas dos clientes e outra com as operações dessas contas. E, com uma certa periodicidade, atualizamos os saldos dessas contas.
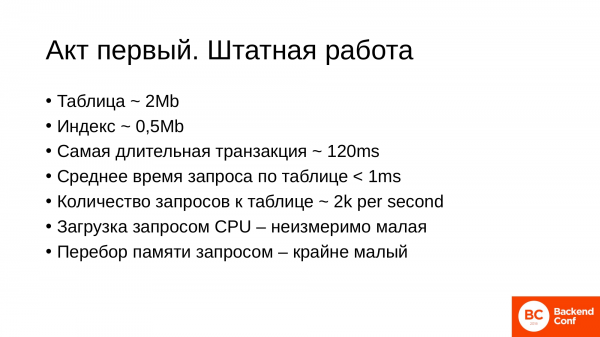
Dados iniciais da tabela: é bastante pequena, 2 MB. O tempo de resposta do banco e especificamente da tabela também é muito bom. E uma carga bastante boa - 2.000 operações por segundo na tabela.
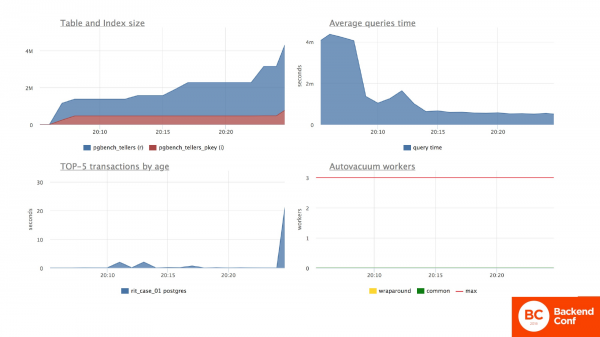
E ao longo desta palestra, vou mostrar gráficos para que fique claro o que está acontecendo. Sempre haverá 2 slides com gráficos. O primeiro slide mostrará o que está acontecendo em geral no servidor.
E nesta situação, vemos que realmente temos uma tabela de tamanho pequeno. O índice é pequeno, de 2 MB. Este é o primeiro gráfico à esquerda.
O tempo médio de resposta do servidor também é estável e pequeno. Este é o gráfico superior direito.
O gráfico no canto inferior esquerdo mostra as transações mais longas. Observamos que as transações são concluídas rapidamente. E o autovacuum ainda não está funcionando aqui, porque foi um teste inicial. Depois, ele funcionará e será útil para nós.
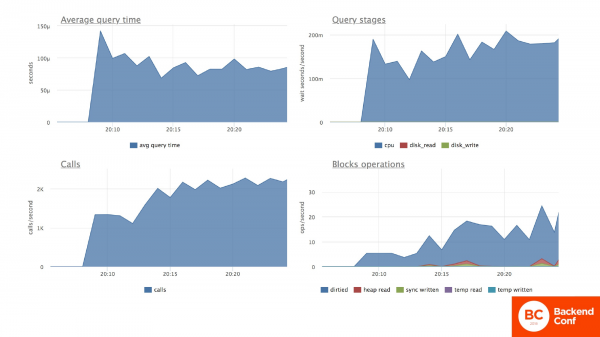
O segundo slide sempre será dedicado à tabela em teste. Nessa situação, atualizamos constantemente os saldos das contas do cliente. E observamos que o tempo médio de resposta para a operação de atualização é bastante bom, abaixo de um milissegundo. Também vemos que os recursos da CPU (este é o gráfico no canto superior direito) são consumidos de forma uniforme e em quantidades bastante pequenas.
O gráfico no canto inferior direito mostra quanta memória operacional e de disco estamos percorrendo em busca da linha necessária antes de atualizá-la. E a quantidade de operações na tabela é de 2.000 por segundo, como mencionei no início.
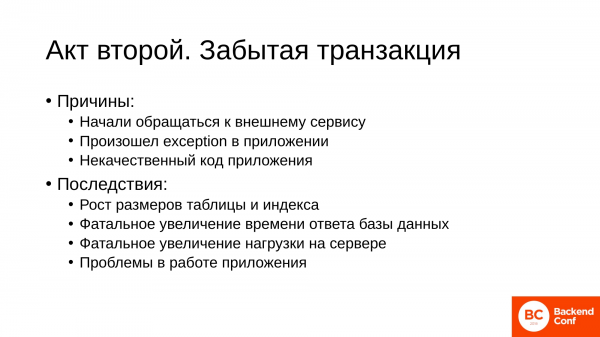
E agora ocorre uma tragédia. Por algum motivo, surge uma transação esquecida e longa. As razões geralmente são bastante banais:
- Uma das mais comuns é que começamos a chamar um serviço externo no código do aplicativo. E esse serviço não nos responde. Ou seja, abrimos uma transação, fizemos uma alteração no banco e fomos ler e-mails ou buscar outro serviço dentro da nossa infraestrutura, e por algum motivo ele não responde. E temos uma sessão pendente em um estado – não sabemos quando será resolvido.
- A segunda situação ocorre quando, por algum motivo, houve uma exceção no código. E não tratamos o fechamento da transação na exceção. E acabamos com uma sessão pendente com uma transação aberta.
- E por último, este é também um caso bastante comum. É um código de má qualidade. Alguns frameworks abrem uma transação. Ela fica pendente, e você pode não saber em seu aplicativo que ela está pendente.
A que isso leva?
A que as tabelas e os índices começam a crescer rapidamente. Este é exatamente o efeito de bloat. Para o banco de dados, isso se manifestará em um aumento abrupto no tempo de resposta, aumento da carga no servidor de banco de dados. E, como resultado, o aplicativo sofrerá. Porque se no código você gastava 10 milissegundos em uma consulta ao banco, 10 milissegundos em sua lógica, sua função levava 20 milissegundos. Mas agora, a situação será bastante triste.
E vamos ver o que está acontecendo. O gráfico no canto inferior esquerdo mostra que temos uma transação longa. E se olharmos para o gráfico no canto superior esquerdo, vemos que o tamanho da tabela de dois megabytes disparou para 300 megabytes. Entretanto, a quantidade de dados na tabela não mudou, ou seja, há uma quantidade considerável de lixo.
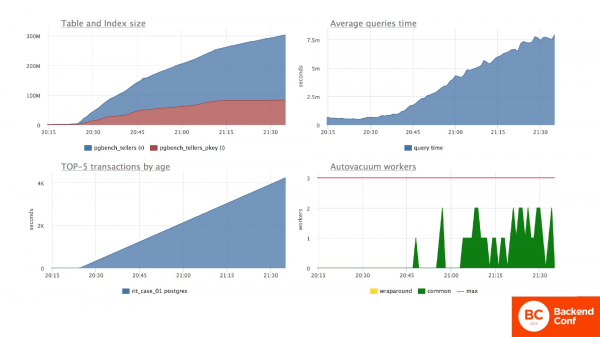
A situação geral em relação ao tempo médio de resposta do servidor também mudou em várias ordens de grandeza. Ou seja, todas as solicitações ao servidor começaram a apresentar quedas significativas. E, além disso, processos internos do Postgres, como o autovacuum, começaram a rodar, tentando fazer algo e consumindo recursos.
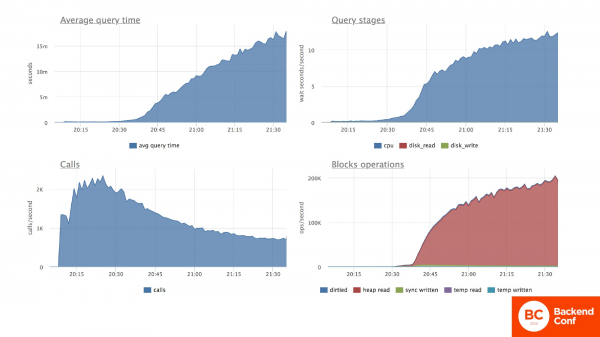
O que está acontecendo com nossa tabela? A mesma coisa. O tempo médio de resposta da tabela disparou em várias ordens de grandeza. Especificamente em relação aos recursos consumidos, vemos que a carga sobre o processador aumentou consideravelmente. Este é o gráfico no canto superior direito. E isso aumentou porque o processador está tendo que percorrer uma quantidade enorme de linhas inúteis em busca de uma linha necessária. Este é o gráfico no canto inferior direito. Como resultado, o número de chamadas por segundo começou a cair drasticamente, porque o banco de dados não consegue processar a mesma quantidade de solicitações.
Precisamos voltar à vida. Vamos à internet e descobrimos que transações longas levam a problemas. Encontramos e eliminamos essa transação. E tudo volta ao normal. Tudo funciona como deve.
Ficamos calmos, mas após algum tempo começamos a notar que o aplicativo não está funcionando tão bem quanto antes da situação de emergência. As solicitações ainda estão sendo processadas mais lentamente, e de fato, significativamente mais lentas. No meu caso, cerca de uma vez e meia a duas vezes mais lentas. A carga no servidor também está maior do que antes da emergência.
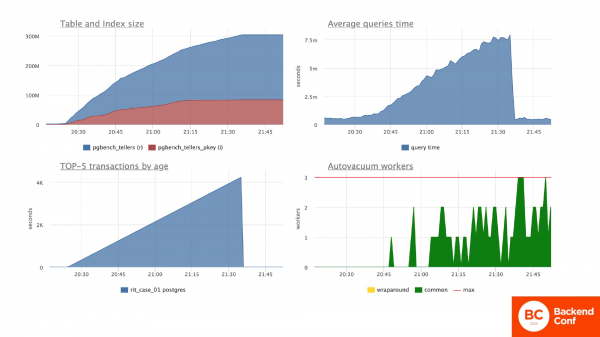
E a pergunta é: "O que está acontecendo com o banco de dados nesse momento?". O que acontece com o banco de dados é a seguinte situação. No gráfico de transações, você pode ver que ele parou e realmente não há transações longas. Mas o tamanho da tabela durante a emergência aumentou drasticamente. E desde então não diminuiu. O tempo médio no banco de dados se estabilizou. E as respostas parecem estar adequadas com uma velocidade aceitável para nós. O autovacuum se tornou mais ativo e começou a fazer algo com a tabela, porque precisa lidar com uma maior quantidade de dados.
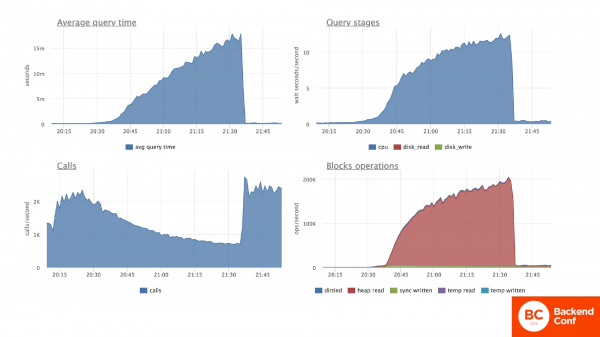
Especificamente em relação à tabela testada com as contas, onde mudamos os saldos: o tempo de resposta para a consulta parece ter voltado ao normal. Mas, na verdade, ainda está uma vez e meia mais alto.
Quanto à carga do processador, vemos que a carga não retornou ao nível necessário antes da falha. As razões estão, na verdade, no gráfico inferior direito. É visível que lá há um consumo excessivo de memória. Ou seja, para encontrar a linha necessária, estamos consumindo recursos do servidor de banco de dados ao percorrer dados inúteis. O número de transações por segundo estabilizou.
No geral, está bem, mas a situação é pior do que antes. Há uma clara degradação do banco de dados como consequência do nosso aplicativo que interage com esse banco de dados.
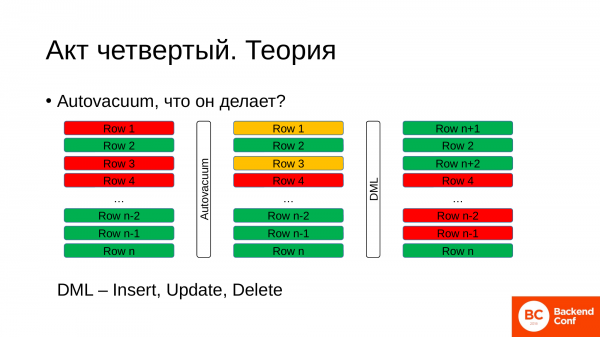
E para entender o que está acontecendo, caso você não tenha assistido à apresentação anterior, uma breve teoria. Teoria sobre o processo interno. Para que serve o autovacuum e o que ele faz?
Resumidamente, para entendimento. Em algum momento, temos uma tabela. Na tabela, temos linhas. Essas linhas podem ser ativas, vivas, que precisamos agora. Na imagem, estão marcadas em verde. E existem linhas mortas, que já foram processadas, foram atualizadas, surgiram novas entradas. Estão marcadas como não mais interessantes para o banco de dados. Mas permanecem na tabela devido às peculiaridades do Postgres.
Para que serve o autovacuum? O autovacuum em algum momento chega, se dirige ao banco de dados e pergunta: "Por favor, me dê o id da transação mais antiga que está aberta no momento no banco de dados". O banco de dados retorna esse id. E o autovacuum, com base nisso, atravessa as linhas na tabela. Se ele vê que algumas linhas foram modificadas por transações muito mais antigas, ele tem o direito de marcá-las como linhas que podemos reutilizar no futuro, gravando novos dados nelas. Este é um processo em segundo plano.
Enquanto isso, continuamos a trabalhar com o banco de dados, fazendo algumas alterações na tabela. E para essas linhas que podemos reutilizar, gravamos novos dados. Assim, temos um ciclo, ou seja, sempre surgem algumas linhas mortas antigas, e em vez delas, gravamos novas linhas que precisamos. E esse é um estado normal para o funcionamento do PostgreSQL.
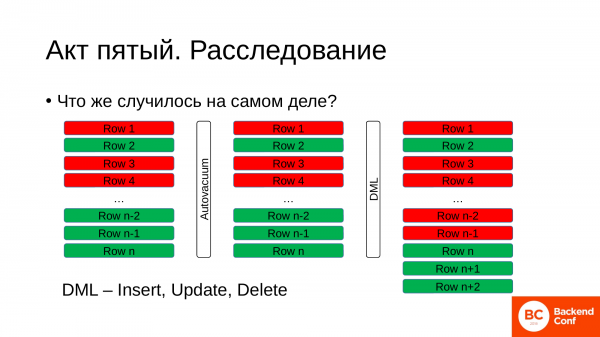
O que aconteceu durante o acidente? Como esse processo ocorreu?
Tínhamos uma tabela em um certo estado, algumas linhas vivas e outras mortas. O autovacuum chegou. Ele perguntou ao banco de dados qual era a nossa transação mais antiga e qual era o seu id. Recebeu esse id, que poderia ter horas de idade ou apenas dez minutos. Isso depende da carga que você tem no seu banco de dados. E começou a procurar as linhas que ele poderia marcar como reutilizáveis. E não encontrou tais linhas na nossa tabela.
Mas, enquanto isso, continuamos a trabalhar na tabela. Estamos fazendo algo nela, atualizando, mudando dados. E o que o banco de dados faz nesse tempo? Não resta a ele outra opção a não ser adicionar novas linhas ao final da tabela existente. E assim, o tamanho da tabela começa a aumentar.
Na realidade, precisamos das linhas verdes para o trabalho. Mas durante esse problema, nosso percentual de linhas verdes é extremamente baixo em todo o volume da tabela.
E quando executamos uma consulta, o banco de dados precisa percorrer todas as linhas: tanto as vermelhas quanto as verdes, para encontrar a linha certa. E o efeito de aumento da tabela com dados inúteis é chamado de 'bloat', que também consome nosso espaço em disco. Lembra que era 2 MB, agora é 300 MB? Agora troque megabytes por gigabytes e você rapidamente ficará sem todos os seus recursos de disco.
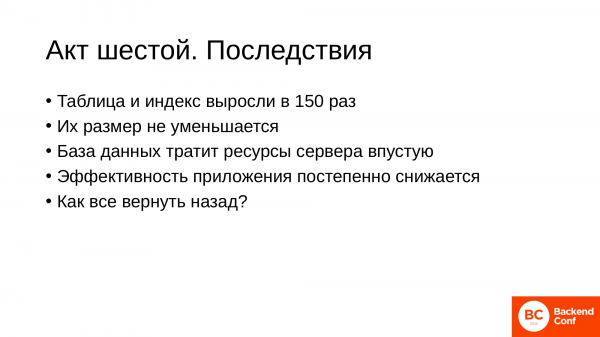
Quais podem ser as consequências para nós?
- No meu exemplo, a tabela e o índice cresceram 150 vezes. Alguns de nossos clientes tiveram casos mais fatais, quando simplesmente o espaço em disco começava a acabar.
- O tamanho das tabelas em si nunca diminui. O autovacuum em alguns casos pode cortar a cauda da tabela se houver apenas linhas mortas. Mas como ocorre uma rotação constante, uma linha verde pode acabar pendurada no final e não ser atualizada, enquanto todas as outras serão gravadas em algum lugar no início da tabela. Mas isso é um evento tão improvável, que não é algo que você deva esperar.
- O banco de dados precisa percorrer todo um monte de linhas inúteis. E estamos consumindo recursos de disco, recursos de processador e energia elétrica.
- E isso impacta diretamente nosso aplicativo, pois, se no início gastávamos 10 milissegundos em uma solicitação e 10 milissegundos no nosso código, durante a falha passamos a gastar um segundo na solicitação e 10 milissegundos no código, ou seja, a performance do aplicativo caiu drasticamente. E quando a falha foi resolvida, começamos a gastar 20 milissegundos na solicitação e 10 milissegundos no código. Isso significa que ainda assim nossa performance caiu em um fator de 1,5. E tudo isso devido a uma transação que travou, possivelmente por nossa culpa.
- E a pergunta é: "Como voltar atrás?" Para que tudo volte a funcionar bem e as solicitações sejam tão rápidas quanto antes da falha.
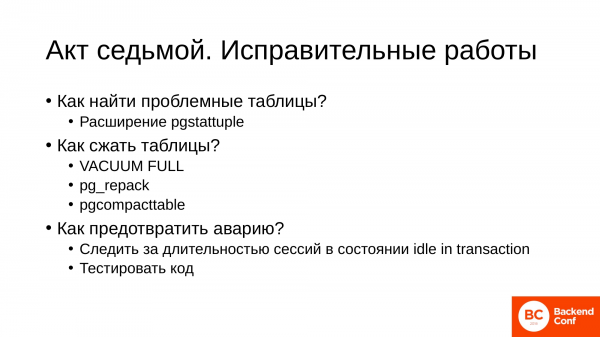
Para isso, existe um ciclo de trabalho definido que deve ser realizado.
Primeiro, precisamos identificar as tabelas problemáticas que incharam. Compreendemos que algumas tabelas têm registros mais ativos e outras menos ativos. E para isso, utilizamos a extensão . Após instalar essa extensão, você pode escrever consultas que ajudarão a encontrar as tabelas que incharam significativamente.
Depois de identificar essas tabelas, elas precisam ser compactadas. Para isso, já existem ferramentas. Em nossa empresa, usamos três ferramentas. A primeira é o VACUUM FULL embutido. Ele é severo, rigoroso e implacável, mas às vezes é muito útil. e — são utilitários de terceiros para a compactação de tabelas. E eles lidam com o banco de dados de maneira mais cuidadosa.
Eles são utilizados dependendo da sua conveniência. Mas eu falarei sobre isso no final. O importante é que há três ferramentas. Há opções disponíveis.
Depois de corrigirmos tudo e assegurarmos que tudo está bem, devemos saber como prevenir essa situação no futuro:
- É uma prevenção relativamente fácil. Precisamos monitorar a duração das sessões no Servidor Master. Sessões especialmente perigosas em estado de idle in transaction.Essas são as que abriram uma transação, realizaram algo e saíram ou simplesmente travaram, se perderam no código.
- E para vocês, como desenvolvedores, é importante testar o código quando essas situações surgem. Não é difícil de fazer. Isso será uma verificação útil. Você evitará um grande número de problemas "infantis" relacionados a transações longas.
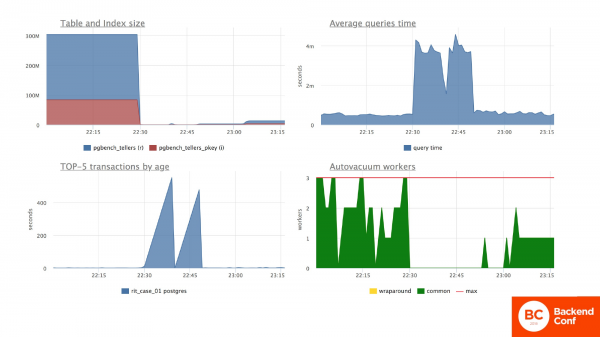
Nestes gráficos, eu queria mostrar como a tabela e o comportamento do banco de dados mudaram depois que passei, neste caso, um VACUUM FULL na tabela. Isso não é produção para mim.
O tamanho da tabela voltou imediatamente ao seu estado normal de funcionamento, com poucos megabytes. Isso não afetou muito o tempo médio de resposta do servidor.
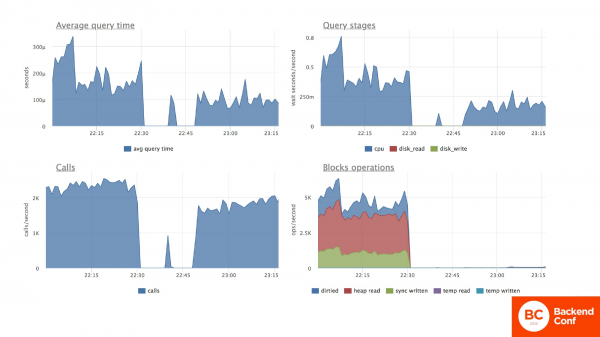
Mas, especificamente para nossa tabela experimentada, onde atualizamos os saldos nas contas, vemos que o tempo médio de resposta para a solicitação de atualização de dados na tabela foi reduzido ao nível pré-acidente. Os recursos consumidos pelo processador para executar essa solicitação também caíram para o nível pré-acidente. E o gráfico no canto inferior direito mostra que agora encontramos exatamente a linha que precisamos imediatamente, sem percorrer um monte de linhas mortas que existiam antes da compactação da tabela. E o tempo médio das solicitações permaneceu aproximadamente no mesmo nível. Mas aqui eu tenho, mais provavelmente, um erro do meu hardware.
Aqui termina a primeira história. É a mais comum. E acontece com todos, independentemente da experiência do cliente e da qualificação dos programadores. Mais cedo ou mais tarde isso acontece.
A segunda história, onde distribuímos a carga e otimizamos os recursos do servidor.
- Já crescemos e nos tornamos um grupo sério. E entendemos que temos uma réplica e seria bom balancear a carga: escrever no Master e ler da réplica. Normalmente essa situação surge quando queremos preparar alguns relatórios ou fazer ETL. E o negócio fica muito satisfeito com isso. Ele realmente deseja relatórios diversos com um monte de análises complexas.
- Os relatórios levam horas, porque a análise complexa não pode ser realizada em milissegundos. Nós, como bons rapazes, escrevemos código. Fazemos inserções no aplicativo, gravando no Master e executando relatórios na réplica.
- Distribuímos a carga.
- Tudo funciona perfeitamente. Nós estamos indo bem.
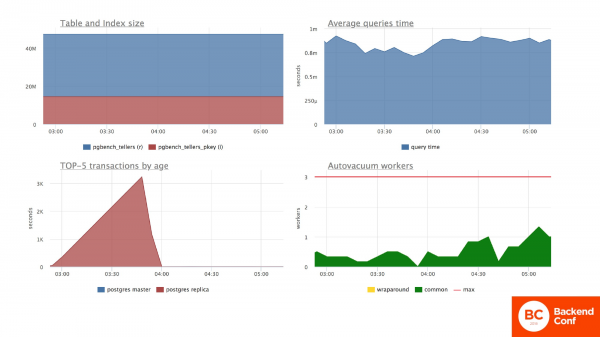
E como essa situação se apresenta? Especificamente nestes gráficos, eu adicionei também a duração das transações com a réplica. Todos os outros gráficos se referem apenas ao servidor Master.
A tabela de relatórios cresceu até o momento. Agora temos mais dela. Vemos que o tempo médio de resposta do servidor está estável. Observamos que na réplica há uma transação longa, que está em andamento há 2 horas. Notamos o funcionamento tranquilo do autovacuum, que lida com linhas mortas. E tudo está indo bem.
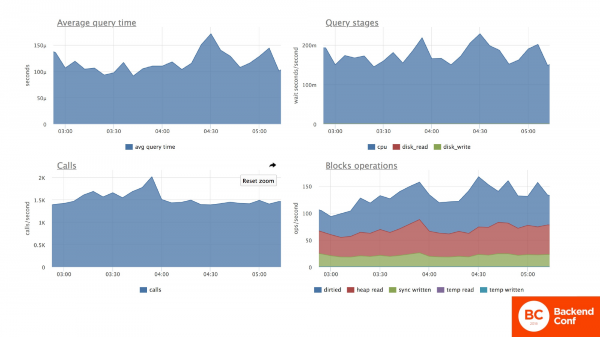
Especificamente em relação à tabela testada, continuamos atualizando os saldos nas contas. E também temos um tempo de resposta estável para as consultas, com um consumo de recursos estável. Tudo está indo bem.
Tudo vai bem até o momento em que esses relatórios começam a ser rejeitados devido a conflitos com a replicação. E eles são rejeitados com uma periodicidade constante.
Pesquisamos na internet e começamos a ler por que isso acontece. E encontramos uma solução.
A primeira solução é aumentar a latência de replicação. Sabemos que nosso relatório funciona por 3 horas. Definimos a latência de replicação para 3 horas. Ligamos tudo, mas ainda assim continuamos tendo problemas com o fato de que os relatórios às vezes são rejeitados.
Queremos que tudo funcione perfeitamente. Pesquisamos mais e encontramos uma configuração interessante na internet – hot_standby_feedback. Ativamos isso. O hot_standby_feedback nos permite segurar o funcionamento do autovacuum no Master. Assim, nos livramos completamente dos conflitos de replicação. E tudo funciona bem com os relatórios.
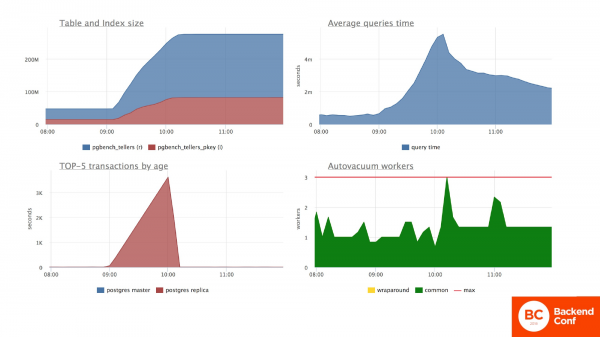
E o que está acontecendo com o servidor Master nesse momento? O que ocorre com o servidor Master é um desastre total. Agora observamos os gráficos após ativar essas duas configurações. E vemos que a sessão na réplica de alguma forma começou a influenciar a situação no servidor Master. Ela realmente influencia, pois interrompeu o autovacuum, que remove linhas mortas. O tamanho da tabela disparou novamente. O tempo médio de execução das consultas em toda a base de dados também disparou. Os autovacuums ficaram um pouco sobrecarregados.
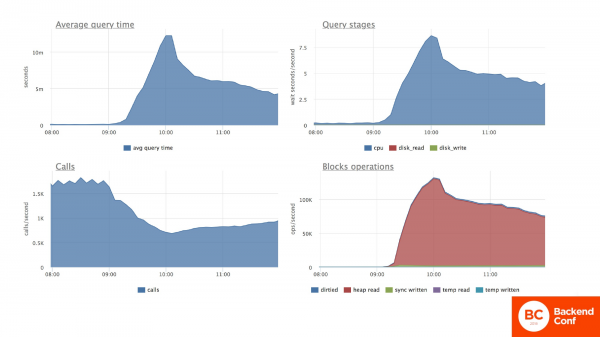
Especificamente em relação à nossa tabela, vemos que a atualização dos dados nela também disparou. O consumo de recursos do processador aumentou significativamente. Estamos revisando um grande número de linhas mortas e inúteis. E o tempo de resposta desta tabela, o número de transações caiu.
Como isso se parecerá se não soubermos do que estou falando até agora?
- Estamos começando a buscar problemas. Se encontramos problemas na primeira parte, sabemos que isso pode ser causado por uma transação longa e temos que verificar o Master. O problema está no Master. Ele está instável. Ele está esquentando e sua média de carga está perto de cem.
- As requisições lá estão lentas, mas não vemos nenhuma transação longa. E não entendemos qual é o problema. Não sabemos onde procurar.
- Estamos verificando o hardware do servidor. Pode ser que o RAID tenha falhado. Pode ser que uma peça da memória tenha queimado. Qualquer coisa pode estar acontecendo. Mas não, os servidores são novos, tudo está funcionando perfeitamente.
- Todos estão correndo: administradores, desenvolvedores e o diretor. Nada ajuda.
- E em algum momento tudo começa a se corrigir inesperadamente.
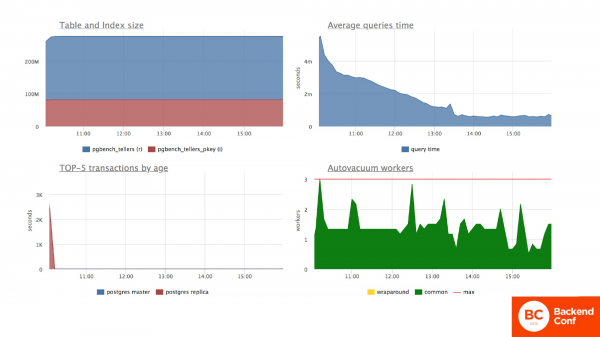
Na réplica, enquanto isso, uma requisição foi processada e enviada. Recebemos um relatório. O negócio ainda está satisfeito. Como podemos ver, nossa tabela cresceu novamente e não está diminuindo. No gráfico de sessões, deixei uma parte desta longa transação da réplica para que você possa avaliar quanto tempo leva até que a situação se estabilize.
A sessão se foi. E só depois de algum tempo o servidor começa a se normalizar. E o tempo médio de resposta das requisições no servidor Master volta ao normal. Porque, finalmente, o autovacuum teve a oportunidade de limpar e marcar essas linhas mortas. E ele começou a fazer seu trabalho. E quão rápido ele faz isso, tão rápido voltaremos ao normal.
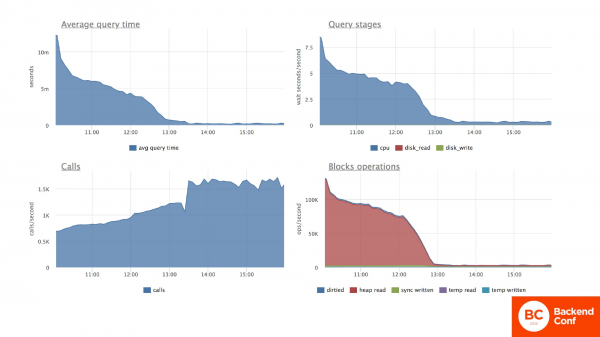
Na tabela testada, onde atualizamos os saldos das contas, vemos exatamente a mesma imagem. O tempo médio de atualização da conta também se normaliza gradualmente. Os recursos consumidos pela CPU também diminuem. E o número de transações por segundo retorna ao normal. Mas novamente, não ao mesmo normal que tínhamos antes da falha.
De qualquer forma, estamos enfrentando uma queda de desempenho, assim como na primeira vez, de uma vez e meia a duas vezes, às vezes até mais.
Aparentemente fizemos tudo certo. Distribuímos a carga. O hardware não está ocioso. Distribuímos inteligentemente as requisições, mas ainda assim, tudo acabou mal.
- Não ativar hot_standby_feedback? Sim, não é recomendado ativá-lo sem uma razão forte. Isso porque esse recurso impacta diretamente o Servidor Principal e interrompe o funcionamento do autovacuum nele. Se você ativá-lo em uma réplica e esquecer, pode prejudicar o Servidor Principal e enfrentar grandes problemas com o aplicativo.
- Aumentar max_standby_streaming_delay? Sim, isso é verdade para relatórios. Se você tem um relatório de três horas e não quer que ele falhe devido a conflitos de replicação, simplesmente aumente a latência. Relatórios longos nunca exigem dados que acabaram de chegar ao banco de dados. Se você está rodando um relatório de três horas, significa que está obtendo dados de um período passado. E ter uma latência de três horas ou seis horas não fará diferença, mas assim você receberá os relatórios de forma consistente e evitará problemas de falhas.
- Naturalmente, é necessário controlar sessões longas nas réplicas, especialmente se você decidiu ativar hot_standby_feedback na réplica. Porque pode acontecer de tudo. Damos essa réplica a um desenvolvedor para que ele teste as consultas. Ele escreve uma consulta complexa, executa e vai tomar um chá, enquanto nós ficamos com o Servidor Principal sobrecarregado. Ou deixamos um aplicativo inadequado rodar. As situações são variadas. As sessões nas réplicas devem ser monitoradas tão rigorosamente quanto nas do Servidor Principal.
- E se você tiver consultas rápidas e longas nas réplicas, neste caso, é melhor dividir a carga. Isso se relaciona ao streaming_delay. Para consultas rápidas, tenha uma réplica com um pequeno atraso na replicação. Para relatórios longos, use uma réplica que possa estar atrasada em até 6 horas ou um dia. Isso é uma situação perfeitamente normal.
Eliminamos as consequências da mesma forma:
- Encontramos tabelas crescidas.
- E as comprimimos com a ferramenta mais adequada para nós.
A segunda história termina aqui. Vamos para a terceira história.
Esta também é bastante comum para nós, na qual realizamos uma migração.
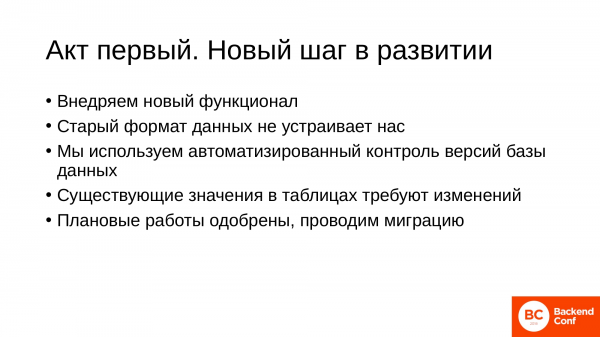
- Qualquer produto de software cresce. Os requisitos para ele mudam. Nós, de qualquer forma, queremos evoluir. E acontece que precisamos atualizar os dados na tabela, ou seja, executar uma atualização no contexto da nossa migração para a nova funcionalidade que estamos implementando como parte do nosso desenvolvimento.
- O formato antigo de dados não é aceitável. Suponha que agora iremos para a segunda tabela, onde tenho operações nessas contas. E, suponha que estavam em rublos, mas decidimos aumentar a precisão e fazer em copeques. E para isso precisamos fazer uma atualização: multiplicar o campo com o valor da operação por cem.
- No mundo moderno, usamos ferramentas automatizadas de controle de versões de banco de dados. Suponha que . Escrevemos nossa migração. Testamos na nossa base de testes. Tudo ótimo. A atualização acontece. Bloqueia o trabalho por um tempo, mas, em compensação, obtemos dados atualizados. E podemos lançar novas funcionalidades a partir disso. Tudo foi testado e verificado. Todos confirmaram.
- Realizamos manutenções programadas, realizamos a migração.
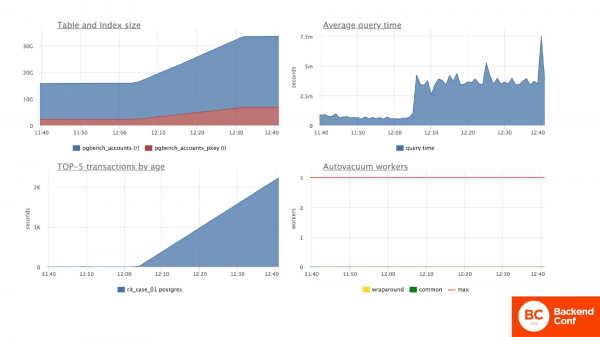
Aqui está a migração com a atualização apresentada para você. Como se trata de operações de contas, a tabela tinha 15 GB. E como estamos atualizando cada linha, a atualização dobrou o tamanho da tabela, porque regravamos cada linha.
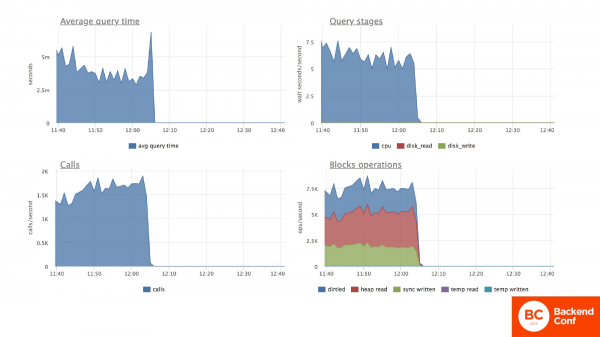
Durante a migração, não pudemos fazer nada com esta tabela, porque todas as consultas a ela ficaram enfileiradas e aguardando a conclusão desta atualização. Mas aqui gostaria de chamar sua atenção aos números que estão no eixo vertical. Ou seja, temos um tempo médio de consulta antes da migração em torno de 5 milissegundos e uma carga no processador, número de operações de leitura de memória do disco menor do que 7,5.
Realizamos a migração e novamente encontramos problemas.
A migração foi bem-sucedida, mas:
- A funcionalidade antiga começou a demorar mais.
- A tabela cresceu novamente em tamanho.
- A carga no servidor tornou-se maior do que era antes.
- E, naturalmente, enquanto ainda estamos lidando com a funcionalidade que funcionava bem, a melhoramos um pouco.
E isso é novamente um bloat que estraga nossa vida mais uma vez.
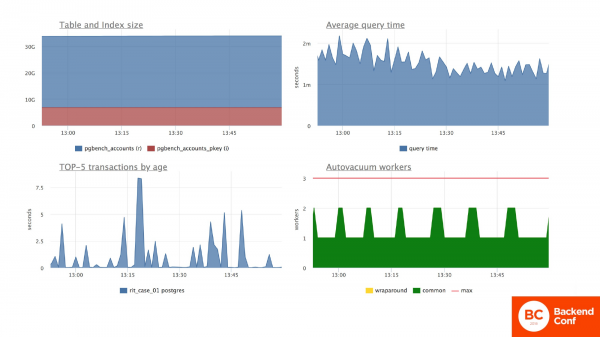
Aqui demonstro que a tabela, como nos dois casos anteriores, não está disposta a retornar aos tamanhos anteriores. A carga média no servidor parece adequada.
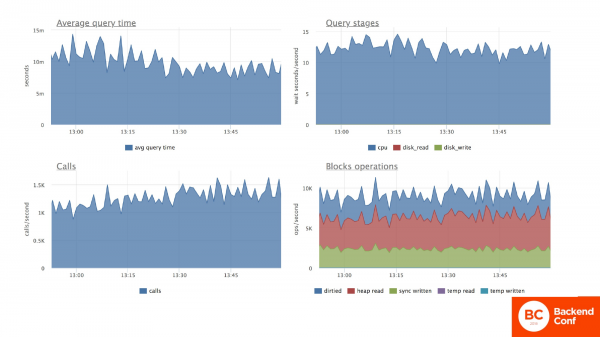
Se olharmos para a tabela de contas, veremos que o tempo médio de solicitação dobrou para esta tabela. A carga no processador e a quantidade de linhas percorridas na memória subiram acima de 7,5, quando antes estava abaixo disso. E houve um aumento de duas vezes no caso dos processadores e de 1,5 vezes em operações em bloco, ou seja, tivemos uma degradação do desempenho do servidor. E, como consequência, uma degradação do desempenho do nosso aplicativo. Entretanto, o número de chamadas permaneceu aproximadamente no mesmo nível.
Aqui, o principal é entender como fazer essas migrações corretamente. E elas precisam ser feitas. Nós realizamos essas migrações de forma bastante consistente.
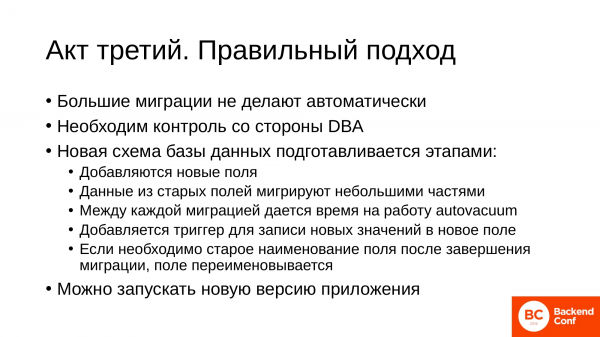
- Migrações grandes como essas não são feitas automaticamente. Elas devem sempre ser controladas.
- É necessário ter um controle por parte de uma pessoa experiente. Se você tem um DBA na equipe, que ele faça isso. É o trabalho dele. Se não houver, que a pessoa mais experiente a faça, aquela que sabe trabalhar com bancos de dados.
- Um novo esquema de banco de dados, mesmo que estejamos atualizando apenas uma coluna, sempre preparamos em etapas, ou seja, antecipadamente antes de lançarmos a nova versão do aplicativo:
- Novos campos são adicionados, onde vamos registrar os dados atualizados.
- Transferimos dados do campo antigo para o novo campo em pequenas partes. Por que fazemos isso? Primeiro, sempre controlamos o processo. Sabemos que já transferimos tantos lotes e quanto nos resta.
- Um segundo efeito positivo é que entre cada lote, encerramos a transação, abrimos uma nova, e isso permite que o autovacuum funcione na tabela, marcando as linhas mortas para reutilização.
- Para as linhas que aparecerão durante o funcionamento do aplicativo (ainda temos o aplicativo antigo rodando), adicionamos um gatilho que registra novos valores nos novos campos. No nosso caso, isso é multiplicar o valor antigo por cem.
- Se quisermos o mesmo campo, então, após a conclusão de todas as migrações e antes do lançamento da nova versão do aplicativo, simplesmente renomeamos os campos. Os antigos para algum nome inventado e os novos campos para os antigos.
- E só depois disso lançamos a nova versão do aplicativo.
E assim não teremos inchaço e não sofreremos uma queda no desempenho.
Aqui termina a terceira história.
E agora, um pouco mais detalhadamente sobre as ferramentas que mencionei na primeira história.
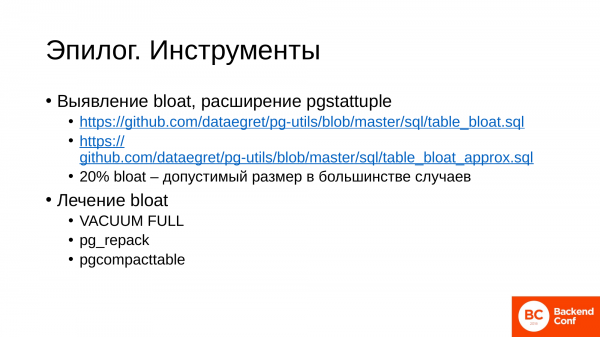
Antes de procurar por bloat, é essencial instalar a extensão. .
Para que você não precise criar consultas, já escrevemos essas consultas em nosso trabalho. Você pode utilizá-las. Aqui estão apresentadas duas consultas.
- A primeira funciona por um tempo considerável, mas oferece os valores exatos de bloat na tabela.
- A segunda é mais rápida e muito eficaz quando você precisa avaliar rapidamente se há bloat na tabela ou não. E você deve entender que o bloat nas tabelas do Postgres está sempre presente. É uma característica do seu modelo MVCC.
- E 20% de bloat é normal para tabelas na maioria dos casos. Ou seja, você não precisa se preocupar e comprimir essa tabela.
Como identificar tabelas que estão incharam, nós já entendemos, mesmo que tenham crescido com dados inúteis.
Agora, sobre como corrigir o bloat:
- Se temos uma tabela pequena e bons discos, ou seja, para tabelas de até um gigabyte, é perfeitamente viável usar o VACUUM FULL. Ele vai precisar obter um bloqueio exclusivo na tabela por alguns segundos, e isto é o suficiente, pois vai fazer tudo de forma rápida e eficaz. O que faz o VACUUM FULL? Ele obtém um bloqueio exclusivo na tabela e reescreve as linhas vivas de tabelas antigas para uma nova tabela. E, no final, troca-as de lugar. Ele apaga os arquivos antigos e insere os novos no lugar dos antigos. Mas durante sua execução, ele retém um bloqueio exclusivo da tabela. Isso significa que você não conseguirá fazer nada com essa tabela: nem escrever, nem ler, nem modificar. E o VACUUM FULL exige espaço adicional em disco para gravar os dados.
- A próxima ferramenta é bastante semelhante ao VACUUM FULL, pois também reescreve dados de arquivos antigos para novos e os substitui na tabela. Mas, ao contrário, não pega um bloqueio exclusivo na tabela desde o início de sua execução; ele o obtém apenas no momento em que já tem os dados prontos para substituir os arquivos. As exigências de recursos em disco são similares às do VACUUM FULL. Você precisa de espaço adicional em disco, e isso pode ser crítico, especialmente se suas tabelas forem de vários terabytes. Além disso, ele consome bastante CPU, pois realiza trabalho ativo de entrada e saída.
- A terceira ferramenta é . Ela utiliza os recursos de forma mais eficiente, pois funciona um pouco de maneira diferente. O principal aspecto do pgcompacttable é que, com as atualizações na tabela, ela move todas as linhas ativas para o início da tabela. E então executa um vacuum nessa tabela, porque sabemos que no início estão as linhas ativas e no final estão as linhas mortas. E o vacuum já corta essa parte final, ou seja, não requer muito espaço extra em disco. E ainda por cima, ele pode ser ajustado para consumir menos recursos.
Com as ferramentas, está tudo certo.
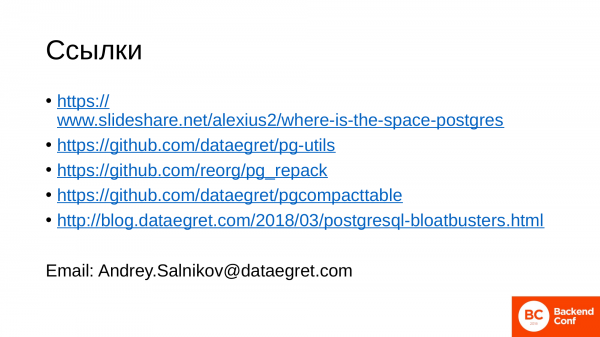
Se o tema do bloat parecer interessante para você explorar mais a fundo, aqui estão alguns links úteis:
- – esta é a apresentação do meu colega. Ele é geral sobre onde o espaço vai no Postgres durante seu funcionamento e vida. E lá há uma parte técnica muito extensa e detalhada para administradores de bancos de dados sobre bloat.
- – este é o link para nosso repositório, onde armazenamos uma série de scripts úteis para verificar o estado do banco de dados. Você pode encontrar scripts para buscar bloat lá.
- e links para ferramentas que ajudarão você a compactar tabelas.
- – este é um post do meu colega. Ele analisa técnica e detalhadamente o bloat, já em um nível mais próximo dos administradores.
Eu tentei mais mostrar um alerta para os desenvolvedores, pois eles são nossos principais clientes de banco de dados e precisam entender quais ações levam a que resultados. Espero ter conseguido. Obrigado pela atenção!
Perguntas
Obrigado pela apresentação! Você falou sobre como identificar problemas. E como podemos preveni-los? Ou seja, eu tive uma situação em que as consultas estavam travadas não apenas porque acessavam algum serviço externo. Eram apenas algumas junções muito complexas. Havia algumas consultas pequenas e inofensivas que ficaram travadas por um dia, e depois começaram a causar problemas. Isso está muito parecido com o que você descreveu. Como monitorar isso? Precisamos ficar constantemente olhando para uma consulta travada? Como podemos evitar isso?
Nesse caso, é uma tarefa para os administradores da sua empresa, não necessariamente para o DBA.
Eu sou administrador.
No PostgreSQL, existe uma visualização chamada pg_stat_activity, que mostra as consultas pendentes. E você pode ver há quanto tempo elas estão travadas.
Eu preciso entrar a cada 5 minutos para verificar?
Configure cron and monitor it. If you have a long-running query, send an email, and that's it. In other words, you don't need to watch it manually; this can be automated. You'll receive an email, and you react to it. Alternatively, you can set automatic triggers.
Are there clear reasons why this is happening?
I listed some. Others are more complex. It could lead to a lengthy discussion.
Thank you for your presentation! I wanted to clarify about the pg_repack utility. If it doesn't acquire exclusive locks, then…
It does acquire exclusive locks.
… then I could potentially lose data. My application shouldn't write anything during that time?
No, it can work with the table without issues. Pg_repack first moves all live rows. Naturally, there will be some writing to the table. It simply appends that tail.
So, it does that in the end?
In the end, it takes an exclusive lock to swap those files.
Will this be faster than VACUUM FULL?
VACUUM FULL, once started, immediately acquires an exclusive lock. And it won’t release it until it's done. Pg_repack only takes an exclusive lock during the file replacement. At that moment, you won't be able to write there, but no data will be lost; everything will be fine.
Hello! You talked about the autovacuum's operation. There was a chart with red, yellow, and green recorded cells. So, yellow ones are marked as deleted. Consequently, can something new be written into them?
Yes. Postgres doesn't delete rows; that's its peculiarity. If we update a row, we mark the old one as deleted. It shows the transaction ID that modified that row and we write a new row. We have sessions that can potentially read them. At some point, they become very old. The essence of autovacuum is to go through these rows and mark them as unnecessary. You can then overwrite that data.
I understand. But the question is a bit different. I didn't finish my thought. Let's say we have a table with variable-sized fields. If I try to insert something new, it might simply not fit into the old cell.
Não, de qualquer forma, toda a linha será atualizada. No Postgres, existem dois modelos de armazenamento de dados. Ele escolhe com base no tipo de dados. Existem dados que são armazenados diretamente na tabela e outros dados tos. Estes são grandes volumes de dados: texto, json. Eles são armazenados em tabelas separadas. E nessas tabelas ocorre a mesma questão de bloat, ou seja, tudo é igual. Apenas estão separados.
Obrigado pela apresentação! Qual a aceitabilidade de usar o statement timeout para limitar a duração das consultas?
É bastante aceitável. Nós usamos isso em todos os lugares. E como não temos nossos próprios serviços, fornecemos suporte remoto, então temos clientes bastante variados. E todos ficam bastante satisfeitos com isso. Ou seja, temos tarefas no cron que verificam. Apenas combinamos a duração das sessões com o cliente, que não podemos encerrar antes do tempo definido. Pode ser um minuto ou dez minutos. Isso depende da carga na base de dados e de seu objetivo. Mas todos usamos pg_stat_activity.
Obrigado pela apresentação! Estou tentando aplicar sua palestra aos meus aplicativos. E parece que em todos os lugares nós iniciamos transações e as encerramos explicitamente. Se houver alguma exceção, o rollback ainda ocorre. E aqui eu fiquei pensando. Afinal, uma transação pode ser iniciada de forma não explícita. É uma dica para a garota, provavelmente. Se eu apenas faço uma atualização de registro, a transação começará no PostgreSQL e só será concluída quando a conexão for encerrada?
Se você está falando agora sobre o nível do aplicativo, isso depende do driver que você está usando, da ORM que está em uso. Há muitas configurações. Se o auto commit estiver ativado, então a transação começa e logo em seguida é encerrada.
Ou seja, ela é encerrada imediatamente após a atualização?
Isso depende das configurações. Eu mencionei uma configuração. Essa é a auto commit on. Ela é bastante comum. Se estiver ativada, a transação é aberta e fechada. Se você não disser explicitamente 'start transaction' e 'end transaction', mas apenas executar uma consulta na sessão.
Olá! Obrigado pela apresentação! Suponha que temos um banco de dados que está crescendo e de repente o servidor fica sem espaço. Existem ferramentas para corrigir essa situação?
O espaço no servidor deve ser monitorado corretamente.
Por exemplo, o DBA foi tomar um chá, estava de férias, etc.
Quando um sistema de arquivos é criado, ele sempre reserva algum espaço, onde os dados não são escritos.
E se for completamente zero?
Esse espaço é chamado de espaço reservado, ou seja, ele pode ser liberado e, dependendo de quão grande ele foi criado, você terá espaço livre. Por padrão, eu não sei quanto há lá. Em outro caso, é preciso fornecer discos para ter espaço para realizar a operação de recuperação. Você pode excluir alguma tabela que definitivamente não é necessária.
Não há outras ferramentas?
Isso é sempre um trabalho manual. E é no local que se determina o que é melhor fazer, pois existem dados críticos e não críticos. E para cada banco de dados e aplicação que trabalha com ele, isso depende do negócio. Sempre se decide no local.
Obrigado pela apresentação! Eu tenho duas perguntas. Primeiro, você mostrou slides onde foi demonstrado que, em caso de transações pendentes, tanto o volume do espaço da tabela quanto o tamanho do índice aumentam. E depois na apresentação havia várias utilitários que compactam a tabela. E quanto ao índice?
Eles também os compactam.
Mas o vacuum não afeta o índice?
Alguns trabalham com o índice. Por exemplo, pg_rapack, pgcompacttable. O vacuum recria os índices, afeta-os. O VACUUM FULL tem a essência de reescrever tudo, ou seja, ele trabalha com todos.
E a segunda pergunta. Eu não entendi por que os relatórios nas réplicas dependem tanto da própria replicação. Eu pensei que os relatórios eram leitura, e a replicação era gravação.
Onde ocorre o conflito de replicação? Temos o Master, onde ocorrem os processos. Temos o autovacuum. O autovacuum, na verdade, o que faz? Ele elimina algumas linhas antigas. Se nesse momento em que está sendo feito na réplica, há uma consulta que lê essas linhas antigas, mas no Master ocorreu uma situação em que o autovacuum marcou essas linhas como possíveis para regravação, então nós as regravamos. E recebemos um pacote de dados, quando devemos regravar as linhas que são necessárias para a consulta na réplica, o processo de replicação aguardará o timeout que você configurou. E então o PostgreSQL decidirá o que é mais importante para ele. E a replicação é mais importante para ele do que a consulta, então ele descartará a consulta para realizar essas alterações na réplica.
André, tenho uma pergunta. Esses gráficos incríveis que você mostrou durante a apresentação, são resultado do trabalho de alguma das suas ferramentas? Como foram feitos esses gráficos?
Este é um serviço .
É um produto comercial?
Sim. É um produto comercial.
Fonte: habr.com
