

Meu nome é Yuri, sou líder do grupo de administração de sistemas na Citimobil. Hoje, vou compartilhar minha experiência com a tecnologia de provisionamento fino (thin provisioning) em sistemas de arquivos Linux e como ela pode ser aplicada nos processos tecnológicos de CI/CD da empresa. Vamos analisar a situação em que, para testes automáticos de código ao serem enviados para produção, necesitamos de cópias do banco de dados MySQL o mais parecidas possível com a versão "em produção", disponíveis para leitura e gravação.
Introdução: por que dar conselhos prejudiciais?
É uma pergunta lógica, pois já existem mecanismos testados para migrações de esquemas de banco de dados em ambientes de teste. Por que levar o banco de dados não particionado ao ponto de atingir tais volumes? E nem todos os dados são necessários para testes. Vou tentar explicar.
Aproximadamente um ano atrás, com o crescimento ativo do nosso agregador de táxis (em 2018, aumentamos o número de corridas finalizadas em cerca de 15 vezes), o volume de dados, a carga nos servidores e a frequência de atualizações aumentaram. Nos encontramos na seguinte situação:
- O banco de dados MySQL principal cresceu para cerca de 1000 tabelas, totalizando 2,5 TB, e continuou a crescer.
- Não havia possibilidade de fazer a fragmentação rapidamente e dispersar a base. Isso era impedido pela antiga abordagem de "escrever no banco o que quero e como quero", com uma série de JOINs e dependências internas entre tabelas.
- Não havia mecanismo para migrações do esquema do banco de dados em ambientes de teste.
- Não havia testes automáticos de código ao ser enviado para produção.
O último problema precisava ser resolvido o mais rápido possível. Já haviam sido escritos testes Postman para verificar o principal monólito PHP, mas faltava uma base de dados atual. No entanto, não podíamos criar uma réplica à noite, torná-la mestre e disponibilizá-la durante o dia: a grande quantidade de atualizações e mudanças, incluindo dados e o esquema do banco, tornaria o ambiente não funcional até o meio do dia. E limitar as atualizações apenas ao horário comercial seria ineficaz.
No entanto, a tarefa foi concluída: conseguimos o primeiro ambiente funcional em apenas duas semanas. Ao longo do ano passado, ele passou por muitas mudanças e continua em uso.
A seguir, descreverei detalhadamente todas as etapas e fases de desenvolvimento da nossa solução. Você verá que esse método merece existir.
O que é "provisionamento fino"?
Esta é uma tecnologia de hardware ou software (outra nome — volumes esparsos) que permite alocar uma quantidade maior de recursos do que a disponível. O volume alocado deve atender aos critérios de just-enough (apenas o necessário) e just-in-time (no tempo necessário). Principalmente, a reserva fina é aplicada em diferentes sistemas de armazenamento para fornecer espaço em disco em volumes necessários que superam o que está efetivamente disponível. A tecnologia é suportada por diferentes sistemas de arquivos, como LVM2, ZFS, BTRFS. É amplamente utilizada em hipervisores de virtualização. A reserva fina nos permitiu criar rapidamente a partir de snapshots da partição principal com dados quantas cópias dessa partição precisássemos (diretório de dados do SGBD MySQL).
Primeiro stand, tecnologia Thin LVM
Este capítulo pode ainda ser chamado de "Como fazer snapshots rápidos de grandes volumes de dados com , reduzindo a estabilidade do sistema de arquivos e do SGBD MySQL a níveis inaceitáveis."
Como já utilizamos o LVM para construir as partições principais do sistema operacional, decidimos começar por ele. Para isso, precisávamos de uma máquina física separada — uma réplica do nosso banco de dados MySQL principal, na qual poderíamos criar um snapshot da réplica sob demanda e levantá-lo ao lado como uma instância separada do MySQL. Durante o período de testes, permitimos que operações modificadoras fossem realizadas nesta instância, e ao final dos testes, ela era devidamente removida. A configuração do servidor era a seguinte:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD em controladora RAID Adaptec em RAID-10
Sobre a escolha entre controladora RAID e RAID MD baseado em software, poderia ser escrito um artigo separado. Apenas direi que nossa escolha foi influenciada por dois fatores:
- Na época da proposta, todas as SGBDs eram instaladas em controladoras RAID, então pode-se dizer que assim se estabeleceu historicamente.
- A diferença de desempenho em testes sintéticos do sistema de arquivos e testes com várias operações no MySQL foi mínima.
Dividimos o RAID-10 resultante: fizemos um único Grupo de Volume (VG) para todo o espaço (com uma sobrecarga de aproximadamente 6,7 GB) e criamos uma partição lógica (Logical Volume, LV) para o sistema com 50 GB. Normalmente, definimos o restante do espaço para a partição do MySQL. Mas precisávamos de reservas finas, então primeiro criamos um pool, dentro do qual criamos uma partição para /var/lib/mysql com 3,5 TB (com base nos volumes de BD previstos):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Formatamos a partição em ext4, montamos, gravamos a réplica e obtivemos o ambiente inicial. Em seguida, criamos uma camada de API, que deve criar snapshots, levantar uma instância do MySQL na porta especificada e remover a instância criada. Como isso utiliza apenas chamadas de sistema, escolhemos o bash normal para a linguagem de script e, para a camada API HTTP → bash, implementamos uma solução open source , escrita em Go.
Algum dia vamos disponibilizar nossos scripts bash em open source, mas por enquanto, apenas descreverei o algoritmo principal:
Criação do snapshot principal snapmain:
- Parar a réplica principal.
- Colocar bloqueio nas operações com o snapshot snapmain.
- Criar um novo snapshot snapmain.
- Iniciar o MySQL e remover o bloqueio.
Criação de uma BD em uma porta arbitrária a partir do snapmain:
- Colocar bloqueio na instância específica da BD (porta).
- Verificar a presença do bloqueio de criação do snapshot principal. Se existir, esperar e verificar novamente a cada 5 segundos.
- Verificar se existe uma partição LV antiga para a instância.
3.1 Se existir, parar a instância do MySQL usando kill -9 e remover a partição LV. - Criar uma nova instância a partir do snapmain.
- Preparar e montar diretórios para essa instância.
- Remover sinais de slave (arquivos) e iniciar a instância do MySQL.
- Tornar isso um master.
- Remover o bloqueio.
Remoção da BD em uma porta arbitrária:
- Colocar bloqueio na instância específica da BD (porta).
- Matar a instância do MySQL usando kill -9.
- Desmontar diretórios.
- Remover a partição LV e remover o bloqueio.
Exemplo de comandos para clonar partições da nova instância da BD:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Agora vou falar sobre o principal problema que enfrentamos ao usar a reserva fina. Enfrentamos o desempenho dos SSDs. Isso ocorreu devido às características do Thin LVM: ele opera em um nível de dispositivo com blocos de 4 MB por padrão. Como isso se pareceu:
- Criamos um snapshot da partição principal /var/lib/mysql.
- Iniciamos a replicação para alcançar o mestre.
- Qualquer alteração nas tabelas da réplica faz com que os blocos de dados antigos e inalterados sejam mantidos na partição do snapshot.
- Qualquer alteração na instância de teste levantada faz com que os blocos de dados antigos e inalterados sejam mantidos na partição do snapshot clonado para essa instância.
- Atingimos uma carga de operações de entrada e saída de 100% no dispositivo, atrasando qualquer operação e causando o gradual deslizamento da réplica.
- Ao final do dia de trabalho, temos um stand que ficou atrás por várias horas.
Como lidamos com isso para obter um resultado mais razoável (principais pontos):
Controlador RAID:
- Desativamos por padrão todos os tipos de cache.
- Configuramos o writeback (quando os dados entram no buffer, a gravação é concluída antes que o salvamento real no disco ocorra).
Sistema de arquivos:
- No ponto de montagem /var/lib/mysql, configuramos noatime,nodiratime,data=writeback
- Desativamos o journaling do ext4 usando tune2fs.
MySQL:
- Configuramos innodb_flush_method = O_DSYNC (aumentamos a velocidade de gravação, reduzindo assim a confiabilidade).
- Desativamos o journaling, pois não precisamos de logs.
- Configuramos innodb_buffer_pool_size = 4G (quanto menor o tamanho do pool InnoDB, mais rápido o MySQL se extinguirá em caso de parada e mais rápido criaremos o snapshot).
Esta não é uma lista completa, especialmente em relação ao MySQL. No entanto, as outras mudanças são menores e muitas vezes não se aplicam sempre ou de forma precisa. Por exemplo, na tentativa de aliviar os discos, até mesmo movemos innodb_parallel_doublewrite_path para /dev/shm, o que em alguns casos, ao iniciar uma instância não finalizada corretamente, nos economizou até 5 segundos.
Por que paramos o MySQL antes de fazer o snapshot? Afinal, podemos tirar um snapshot de uma réplica em funcionamento. Isso está correto, mas a nova instância de BD nesse snapshot será considerada corrompida por padrão e exigirá uma varredura completa ao ser iniciada. Parar a réplica é definitivamente mais rápido, embora no final seja a operação mais demorada em todo o processo.
Como resultado, obtivemos tempos mais aceitáveis e um ambiente operacional pronto para uso. No entanto, como pode ser visto no gráfico mais eloquente do atraso de replicação da réplica primária, a situação ainda está longe do ideal:
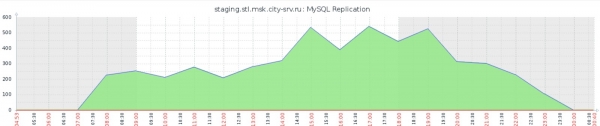
Entre outras desvantagens, destaca-se a praticamente impossibilidade de monitorar o pool Thin LVM: além das funções padrão do sistema como iostat, entender, por exemplo, qual elemento do pool está atualmente gerando a maior carga no sistema de arquivos é impossível.
É importante observar uma grande desvantagem relacionada à otimização mencionada acima: criamos um ambiente YOLO. Aproximadamente uma vez a cada um ou dois meses, o ext4 não suportava esse tipo de abuso e quebrava irreversivelmente, exigindo reformatar e recarregar a réplica. Ganhando em velocidade, comprometemos desesperadamente a estabilidade.
Quais métricas devem ser monitoradas durante a operação do Thin LVM:
- Porcentagem de dados do pool thin
- Porcentagem de metadados do pool thin
Se o espaço para dados esgotado for suportável pelo nosso ambiente (basta limpar os discos), o espaço esgotado para metadados levará ao colapso total do pool e à necessidade de recriá-lo do zero.
O sistema de arquivos dentro do pool se fragmenta bastante ao longo do tempo. Recomendo executar diariamente, através de um cron job, o comando fstrim -v /var/lib/mysql.
Sumários intermediários:
- A tecnologia é facilmente aplicável, assim como o próprio LVM, e não requer qualificações especiais do engenheiro.
- Ela se adequa bem a bancos de dados de pequeno porte e não muito carregados. Quanto menor o banco de dados, menos chunks são movidos pelo sistema de arquivos dentro do pool, e menor é a carga nos discos.
- Para nossa tarefa, começamos a procurar outras soluções, sobre as quais falaremos na próxima seção.
O segundo ambiente, a tecnologia ZFS
Há muito tempo, eu trabalhei com o sistema de arquivos ZFS, mas na época, o ZFS funcionava realmente bem em seu sistema operacional nativo, o Solaris. Existia uma versão portada para FreeBSD com um nível de implementação bastante bom. Também havia um porto não finalizado para Linux, que poucos usavam. Devido à estrutura de armazenamento de dados em B-tree (aliás, a mesma estrutura de armazenamento que o InnoDB do MySQL), o ZFS não teve um bom desempenho em instalações com um número muito grande de arquivos. Tudo isso, juntamente com a necessidade de aprender a parte técnica antes de usá-lo, acabou por riscar totalmente esse sistema de arquivos da minha prática. Surgiram o ext4 e o xfs, que se tornaram o padrão. Mas considerando que o ZFS é mais do que adequado para nossa tarefa, e a versão para Linux, segundo as avaliações, se tornou um produto razoável (embora não tenha total suporte, o que significa que instalar o sistema no ZFS completamente do zero só pode ser feito com várias manobras), decidimos experimentá-lo.
Por razões óbvias, escolhemos uma configuração de estande semelhante (exceto pelo controlador RAID). Instalamos oito SSDs de 1920 GB. Não houve desejo de escrever nossa própria imagem de rede para instalar o servidor em um ZFS
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Criamos partições para o MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Observe que ativamos a compressão de dados gzip padrão. Temos muitos recursos de CPU em nosso servidor que não estão sendo totalmente utilizados. Como resultado, 3 TB do nosso banco de dados foram reduzidos para 1,6 TB, e como o ponto fraco, assim como no caso anterior, é a máxima performance dos discos, quanto menos dados tivermos, melhor. Desde o início, obtemos um excelente bônus do ZFS! Durante os horários de pico, com carga total, o uso de cores para manter o gzip ativo chega a até 4 núcleos, mas não nos importamos.
Em seguida, a implementação aconteceu mais rapidamente. Reproduzimos as configurações de replicação do MySQL a partir do estande LVM. Tivemos que gastar algum tempo reescrevendo os scripts para os comandos do ZFS, mas no geral, os algoritmos permaneceram os mesmos. Um exemplo de criação de snapshot:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
De ajustes adicionais: movemos para a memória as seções ZFS com metadados e logs l2arc e zil. Para a nossa tarefa, como ficou evidente mais tarde, isso se mostrou excessivo, mas por enquanto mantivemos essa otimização, que é fácil de alterar se necessário. Entre os efeitos negativos, está o fato de que após reiniciar o servidor, precisamos recriar as áreas de memória correspondentes. Os dados não se perdem. Recorte do zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
Com essa configuração, começamos a testar o ambiente e obtivemos resultados excelentes: com duas instâncias de banco de dados operando simultaneamente (e uma réplica principal ativa) em snapshots, a carga nos discos variou entre 50% e 60%.
Eliminamos nosso principal problema, como pode ser visto no gráfico de atraso da replicação (compare com o gráfico anterior na seção Thin LVM):
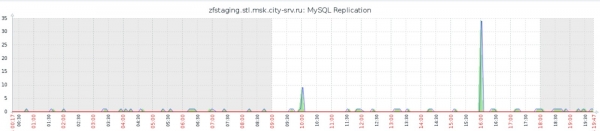
Além disso, e graças a isso, aceleramos significativamente em todas as operações: a criação completa de um snapshot com a parada e reinício da réplica leva até 40 segundos, enquanto o desdobramento de uma nova instância MySQL a partir de um snapshot leva até 20 segundos. O que atende mais do que nossas expectativas e os nossos testes de software.
Sumários intermediários:
- Os resultados atenderam completamente nossa necessidade de obter uma cópia do banco de dados de produção para testes de código.
- A tecnologia requer entendimento: é preciso compreender o que é ZFS e como trabalhar com ele.
- Não testamos o estado atual do funcionamento do ZFS com um grande número (acima de 1 milhão) de arquivos pequenos. Mas presumimos que o problema persiste, portanto, eu não recomendaria este sistema de arquivos para qualquer tipo de armazenamento de arquivos.
E agora?
No estande, não fizemos mais nada, o resultado nos agradou. Possivelmente, no futuro, adicionaremos exceções de tabelas na configuração de replicação do estande, aquelas que não são necessárias para os testes, o que reduzirá ainda mais o volume do banco de dados. Não testamos o sistema BTRFS e sua implementação da tecnologia de backup fino. No entanto, essa tarefa já não está em discussão, pois o objetivo principal foi alcançado. No geral, claro, queremos nos afastar da abordagem descrita acima — implementar migrações de banco de dados funcionais para o ambiente de teste, criar um contorno de teste separado para o banco de dados e trabalhar no particionamento do banco de dados principal. Muitas dessas iniciativas já estão sendo colocadas em prática, sobre as quais certamente falaremos em artigos futuros.
Resultados
A tarefa inicial foi resolvida, embora de uma maneira incomum. As conclusões intermediárias descreveram as vantagens e desvantagens de cada tecnologia aplicada, portanto, vamos determinar qual tecnologia e quando pode ser utilizada:
- Thin LVM — para bancos de dados pequenos e quando não se deseja ou não há tempo para estudar ZFS.
- ZFS — se houver experiência de trabalho com ela ou a possibilidade de dedicar tempo ao seu estudo em qualquer situação.
Em um nível mais alto de apresentação, este artigo não é apenas uma comparação das tecnologias de dois sistemas de arquivos. A ideia principal que eu gostaria de transmitir e reforçar é que não devemos ter medo de pensar de maneira não convencional em situações críticas para os negócios e de seguir somente receitas prontas. No passado, poderíamos, como todo o departamento técnico, balançar a cabeça e dizer que a tarefa de criar backups de três terabytes de banco de dados em menos de um minuto era impossível, e que não precisávamos de tecnologias arriscadas, que iríamos fazer da maneira correta. Isso era possível, mas perderíamos cerca de seis meses a um ano e muitas viagens de clientes (as viagens são nosso principal indicador de negócios) sem testes e durante a implementação. Agindo de maneira não convencional, não perdemos muito tempo na implementação, adquirimos experiência em novas e antigas tecnologias esquecidas, e oferecemos testes exatamente no momento em que precisávamos muito deles. Sem dúvida, isso teve um impacto positivo em todos os nossos indicadores. A escolha sempre será sua, e da nossa parte, continuaremos a contar em nosso blog sobre conquistas atuais e futuras interessantes.
Fonte: habr.com
