

Olá a todos!
Meu nome é Nikita, sou o líder da equipe de engenheiros da Cian. Uma das minhas responsabilidades na empresa é reduzir o número de incidentes relacionados à infraestrutura em produção para zero.
O que será discutido a seguir nos trouxe muita dor, e o objetivo deste artigo é evitar que outras pessoas cometam nossos erros ou, pelo menos, minimizar seu impacto.
Préâmbulo
Há muito tempo, quando a Cian era composta por monólitos e ainda não havia indícios de microsserviços, medíamos a disponibilidade do recurso verificando de 3 a 5 páginas.
Quando respondem — tudo bem, quando não respondem por muito tempo — alerta. O quanto de tempo elas devem ficar fora do ar para que seja considerado um incidente, era decidido em reuniões. A equipe de engenheiros sempre participava da investigação do incidente. Quando a investigação terminava, escrevíamos um postmortem — um tipo de relatório enviado por e-mail no formato: o que aconteceu, quanto tempo durou, o que fizemos no momento, o que faremos no futuro.
Páginas principais do site ou como sabemos que atingimos o fundo do poço
Para que pudéssemos entender de alguma forma a prioridade do erro, destacamos as páginas do site que são mais críticas para a funcionalidade do negócio. Para elas, contamos o número de requisições bem-sucedidas / malsucedidas e timeouts. Assim, medimos o uptime.
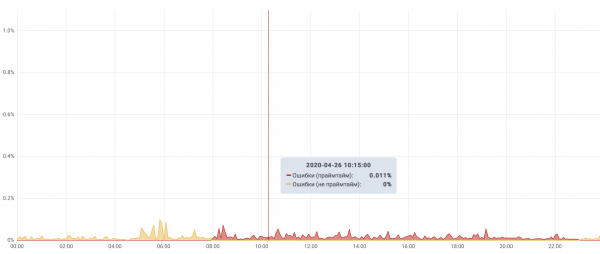
Suponha que descobrimos que há uma série de seções super importantes do site, que são responsáveis pelo principal serviço — busca e envio de anúncios. Se o número de requisições que resultaram em erro ultrapassa 1%, isso é um incidente crítico. Se durante 15 minutos em horário de pico a porcentagem de erros supera 0,1% — isso também é considerado um incidente crítico. Esses critérios cobrem a maior parte dos incidentes; os demais estão fora do escopo deste artigo.
Top melhores incidentes da Cian
Portanto, aprendemos a identificar claramente quando um incidente ocorre.
Agora, cada incidente é detalhadamente descrito e refletido na épica do Jira. A propósito: para isso criamos um projeto separado, chamamos de FAIL — nele só é possível criar épicas.
Se reunirmos todos os fracassos dos últimos anos, os principais são:
- incidentes relacionados ao mssql;
- incidentes causados por fatores externos;
- erros de administração.
Vamos nos aprofundar mais nos erros de administração, bem como em alguns outros fracassos interessantes.
Quinto lugar — "Colocando ordem no DNS"
Foi uma terça-feira chuvosa. Decidimos organizar o cluster DNS.
Quisemos migrar os servidores DNS internos de BIND para PowerDNS, dedicando servidores inteiramente para isso, onde não há nada além do DNS.
Colocamos um servidor DNS em cada localização dos nossos datacenters, e chegou o momento de migrar as zonas de BIND para PowerDNS e direcionar a infraestrutura para os novos servidores.
No auge da migração, de todos servidores, que estavam configurados nos caches locais de BIND em todos os servidores, restou apenas um, localizado no datacenter em São Petersburgo. Este datacenter havia sido inicialmente declarado como não crítico para nós, mas de repente tornou-se um ponto único de falha.
Exatamente durante esse período de migração, a conexão entre Moscovo e São Petersburgo caiu. Ficamos efetivamente sem DNS por cinco minutos e recuperamos quando hospedagem os problemas foram resolvidos.
Conclusões:
Anteriormente, descuidávamos dos fatores externos ao preparar os trabalhos, mas agora também os incluímos na lista de coisas para as quais nos preparamos. E agora buscamos que todos os componentes sejam reservados em n-2, enquanto durante os trabalhos podemos reduzir esse nível para n-1.
- Ao elaborar o plano de ação, anote os pontos onde o serviço pode falhar e pense em um cenário onde tudo foi "para o pior", com antecedência.
- Distribua os servidores DNS internos por diferentes geolocalizações/datacenters/armários/ switches/entradas.
- Em cada servidor, instale um servidor DNS cache local que redirecione as solicitações para os servidores DNS principais e, em caso de indisponibilidade, responda a partir do cache.
O quarto lugar — "Organizando o Nginx"
Em um belo dia, nossa equipe decidiu que "basta de tolerar isso", e o processo de refatoração das configurações do Nginx se iniciou. O principal objetivo é trazer as configurações para uma estrutura intuitiva. Antes, tudo era "historicamente composto" e não tinha lógica. Agora, cada server_name foi levado para um arquivo homônimo e todas as configurações foram distribuídas por pastas. A propósito — a configuração contém 253949 linhas ou 7836520 caracteres e ocupa quase 7 megabytes. O nível superior da estrutura:
Estrutura do Nginx
├── acesso
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Melhorou significativamente, mas durante o processo de renomeação e redistribuição das configurações, algumas delas estavam com a extensão errada e não foram incluídas na diretiva include *.conf. Como resultado, alguns hosts ficaram indisponíveis e retornavam 301 para a página principal. Como o código de resposta não era 5xx/4xx, isso não foi percebido imediatamente, apenas pela manhã. Depois disso, começamos a escrever testes para verificar os componentes da infraestrutura.
Conclusões:
- Estruture corretamente as configurações (não apenas do nginx) e pense na estrutura desde o início do projeto. Assim, você as tornará mais compreensíveis para a equipe, o que, por sua vez, reduzirá o TTM.
- Para alguns componentes da infraestrutura, escreva testes. Por exemplo: verifique se todos os principais server_name retornam o status correto, além do corpo da resposta. Apenas alguns scripts que verifiquem as funções principais do componente serão suficientes, para que você não precise se lembrar freneticamente às 3 da manhã do que mais precisa ser verificado.
Terceiro lugar - "Espaço inesperadamente acabou no Cassandra"
Os dados cresceram de forma consistente, e tudo estava bem até o momento em que os reparos de grandes keyspaces começaram a falhar no cluster Cassandra, pois a compactação não pôde ser processada.
Em um dia nublado, o cluster quase virou uma abóbora, ou seja:
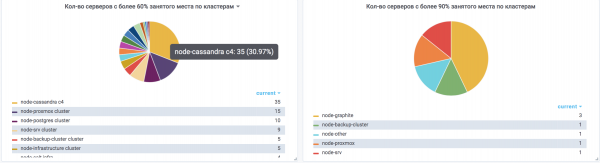
- restavam cerca de 20% de espaço total no cluster;
- não é possível adicionar nós plenamente, pois não passa pelo cleanup após a adição de um nó devido à falta de espaço nas partições;
- a performance cai gradativamente, já que a compactação não está funcionando;
- o cluster opera em modo de emergência.
A saída - adicionamos mais 5 nós sem limpeza, após o que começamos a remover sistematicamente do cluster e a reinseri-los, como nós vazios, onde o espaço acabou. O tempo gasto foi muito maior do que gostaríamos. Havia risco de indisponibilidade parcial ou total do cluster.
Conclusões:
- Em todos os servidores Cassandra, não deve haver mais de 60% de espaço ocupado em cada partição.
- Eles devem estar carregados em no máximo 50% de CPU.
- Não devemos negligenciar o planejamento de capacidade e ele deve ser pensado para cada componente, com base em suas especificidades.
- Quanto mais nós no cluster, melhor. Servidores com um pequeno volume de dados são mais rápidos para reiniciar, e esse tipo de cluster é mais fácil de reanimar.
Segundo lugar - "Dados sumiram do armazenamento de chave-valor do Consul"
Para descoberta de serviços, nós, como muitos, usamos o Consul. Mas o nosso key-value é utilizado também para a implantação blue-green do monólito. Nele está armazenada a informação sobre os upstreams ativos e inativos, que mudam de lugar durante o deploy. Para isso, um serviço de deploy foi escrito, que interagia com KV. Em algum momento, os dados do KV sumiram. Recuperamos da memória, mas com alguns erros. Como consequência, durante a implantação a carga nos upstreams foi distribuída de forma desigual, e recebemos muitos erros 502 devido à sobrecarga dos backends por CPU. No final, migramos do Consul KV para o Postgres, de onde é mais difícil remover os dados.
Conclusões:
- Serviços sem qualquer autorização não devem conter dados críticos para o funcionamento do site. Por exemplo, se você não tem autorização no ES, é melhor proibir o acesso a partir da rede em qualquer lugar onde não seja necessário, deixar apenas os acessos essenciais, e também definir action.destructive_requires_name: true.
- Trabalhe o mecanismo de backup e recuperação antecipadamente. Por exemplo, crie um script (como em python) que consiga tanto fazer backup quanto restaurar.
Primeiro lugar - "Capitão Óbvio"
Em algum momento, notamos uma distribuição desigual da carga nos upstreams do nginx quando havia 10 ou mais servidores no backend. Como o round-robin direcionava as solicitações do primeiro ao último upstream em ordem, e cada recarga do nginx começava do zero, os primeiros upstreams sempre recebiam mais solicitações do que os demais. Como resultado, eles funcionavam mais devagar, afetando todo o site. Isso se tornava cada vez mais evidente à medida que o tráfego aumentava. Simplesmente atualizar o nginx para incluir random não resolveu — era necessário refazer uma série de códigos em lua que não funcionavam na versão 1.15 (naquele momento). Tivemos que patchar nosso nginx 1.14.2, implementando suporte para random. Isso resolveu o problema. Esse bug merece o prêmio de 'capitão da obviedade'.
Conclusões:
Foi muito interessante e envolvente investigar esse bug).
- Configure o monitoramento de forma que ele ajude a identificar rapidamente flutuações semelhantes. Por exemplo, você pode usar o ELK para observar a rps de cada backend de cada upstream, monitorando seus tempos de resposta do ponto de vista do nginx. Nesse caso, isso nos ajudou a identificar o problema.
A maior parte das falhas poderia ter sido evitada com uma abordagem mais meticulosa em relação ao que se está fazendo. Sempre deve-se lembrar da lei de Murphy: Anything that can go wrong will go wrong, e construir componentes com base nisso.
Fonte: habr.com
